Índice
A El Scraping de Google Maps Hoy puede devolver miles de registros y, más tarde, fallar al ejecutar la misma tarea porque ha cambiado parte del proceso de extracción.
Las solicitudes bloqueadas, los problemas con el proxy, los CAPTCHA, los lotes fallidos y los cambios en el análisis generan trabajo de mantenimiento. Una vez que el rastreador pasa a formar parte de un flujo de trabajo recurrente, alguien tiene que supervisar los trabajos, solucionar los fallos, gestionar la infraestructura y garantizar que la lógica de extracción siga funcionando.
Es fácil pasar por alto ese trabajo continuo durante la primera versión. Un equipo puede sentirse cómodo asumiendo esa responsabilidad cuando los requisitos de extracción son poco habituales o cuando la extracción de datos ya forma parte de las tareas de mantenimiento que realizan sus ingenieros.
La decisión se complica cuando los datos de Google Maps son solo uno de los elementos que se utilizan para la generación de clientes potenciales, la investigación, las bases de datos o las aplicaciones internas. En esos casos, el tiempo dedicado a mantener en funcionamiento la capa de extracción pasa a formar parte del coste de los propios datos.
Respuesta rápida: ¿Deberías crear tu propio rastreador de Google Maps?
- Constrúyelo para una extracción personalizada y un control total.
- Utiliza un rastreador gestionado para reducir las tareas de mantenimiento.
- Utiliza una API gestionada para mantener tu propio flujo de trabajo sin tener que ocuparte del scraper.
- Comparar el tiempo dedicado al control, el mantenimiento, el volumen y la ingeniería antes de tomar una decisión.
Qué implica mantener un rastreador de Google Maps creado por uno mismo
Escribir la primera versión de un rastreador es solo una parte del trabajo. Una vez que se ejecuta de forma repetida, el mantenimiento pasa a centrarse en todo lo que rodea al proceso de extracción.
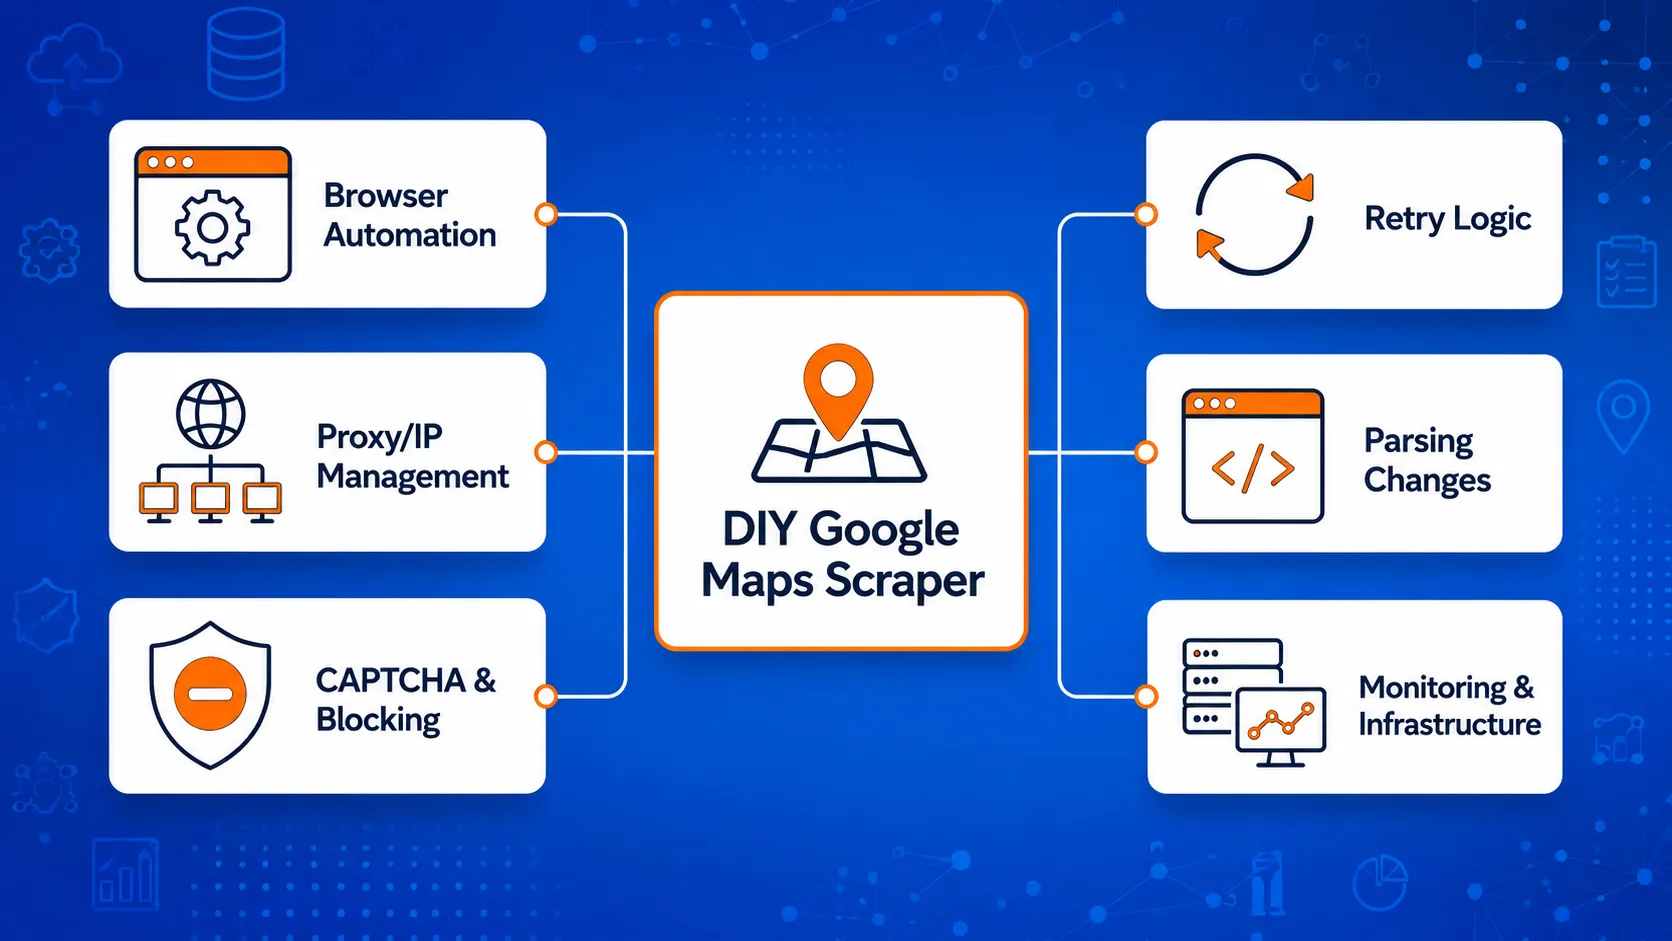
Una configuración «hazlo tú mismo» puede requerir automatización del navegador, gestión de proxies, lógica de reintentos, supervisión y correcciones periódicas cuando cambia el comportamiento de la página. Estas tareas cobran mayor relevancia cuando el rastreador se utiliza para la generación recurrente de clientes potenciales, estudios de mercado o flujos de trabajo internos de datos.
Automatización del navegador y lógica de extracción
Google Maps se basa en gran medida en contenido dinámico de página, por lo que muchos rastreadores de creación propia recurren a la automatización del navegador o a métodos similares para cargar y recopilar datos.
La lógica de extracción también debe identificar los elementos correctos, gestionar el desplazamiento o las cargas repetidas y devolver los campos que espera tu flujo de trabajo. Si cambia la estructura de la página, es posible que haya que actualizar partes de esa lógica.
Si quieres conocer la configuración técnica con más detalle, nuestra guía sobre Extracción de datos de Google Maps con Python abarca la extracción basada en el navegador y el trabajo complementario relacionado con ella.
Gestión de proxies y direcciones IP
Las solicitudes repetidas pueden suponer una carga de trabajo adicional en lo que respecta a la gestión de la propiedad intelectual.
Es posible que un equipo que utilice su propio rastreador tenga que gestionar grupos de proxies, eliminar los proxies que fallan, realizar un seguimiento de las solicitudes bloqueadas y decidir cómo se distribuyen las solicitudes. La calidad de los proxies también puede influir en la fiabilidad con la que se completan los trabajos.
A pequeña escala, esto puede ser manejable. Sin embargo, resulta más difícil de ignorar cuando el rastreador recorre numerosas búsquedas o ubicaciones.
CAPTCHAs y bloqueo
Los CAPTCHA y las solicitudes bloqueadas pueden interrumpir un trabajo de extracción antes de que finalice.
Por lo tanto, un flujo de trabajo de producción necesita una forma de detectar estos fallos y decidir qué ocurre a continuación. Es posible que algunas solicitudes deban volver a intentarse, retrasarse o redirigirse a una dirección IP diferente.
Sin ese tratamiento, un rastreador puede parecer que funciona correctamente, aunque en realidad siga devolviendo conjuntos de datos incompletos.
Reintentos y trabajos fallidos
Una solicitud fallida suele ser más fácil de gestionar que un trabajo completado parcialmente.
Por ejemplo, un scraper puede completar el 80 % de un lote grande antes de que se interrumpa una parte del proceso. En ese caso, el sistema necesita saber qué operaciones se han realizado correctamente, cuáles han fallado y cuáles deben volver a ejecutarse sin generar duplicados innecesarios.
Para ello, se necesitan reglas de seguimiento de tareas y de reintento, además del propio código de extracción.
Análisis de los cambios
El rastreador también depende de la estructura que espera encontrar.
Un cambio en las etiquetas, en los elementos de la página o en la forma en que se cargan los datos puede afectar a los campos que devuelve el analizador. Es posible que el rastreador siga funcionando, pero generando sin avisar valores que faltan o que están asignados incorrectamente.
Por lo tanto, es necesario realizar comprobaciones periódicas para confirmar que los resultados siguen coincidiendo con lo que esperan los sistemas posteriores.
Infraestructura y supervisión
Una vez que un rastreador se encarga de tareas recurrentes, alguien tiene que comprobar si sigue funcionando.
Esto puede incluir servidores, registros, almacenamiento, estado de los trabajos, alertas, lotes fallidos y comprobaciones de resultados. La supervisión cobra especial importancia cuando los datos se envían a otro sistema y es posible que un fallo en la extracción no se detecte de inmediato.
Esta es la parte de un programa de extracción de datos de Google Maps «hazlo tú mismo» que se tiende a subestimar fácilmente. El código que recopila los datos es solo una parte. El equipo también cuenta con los sistemas necesarios para mantener en funcionamiento el proceso de recopilación.
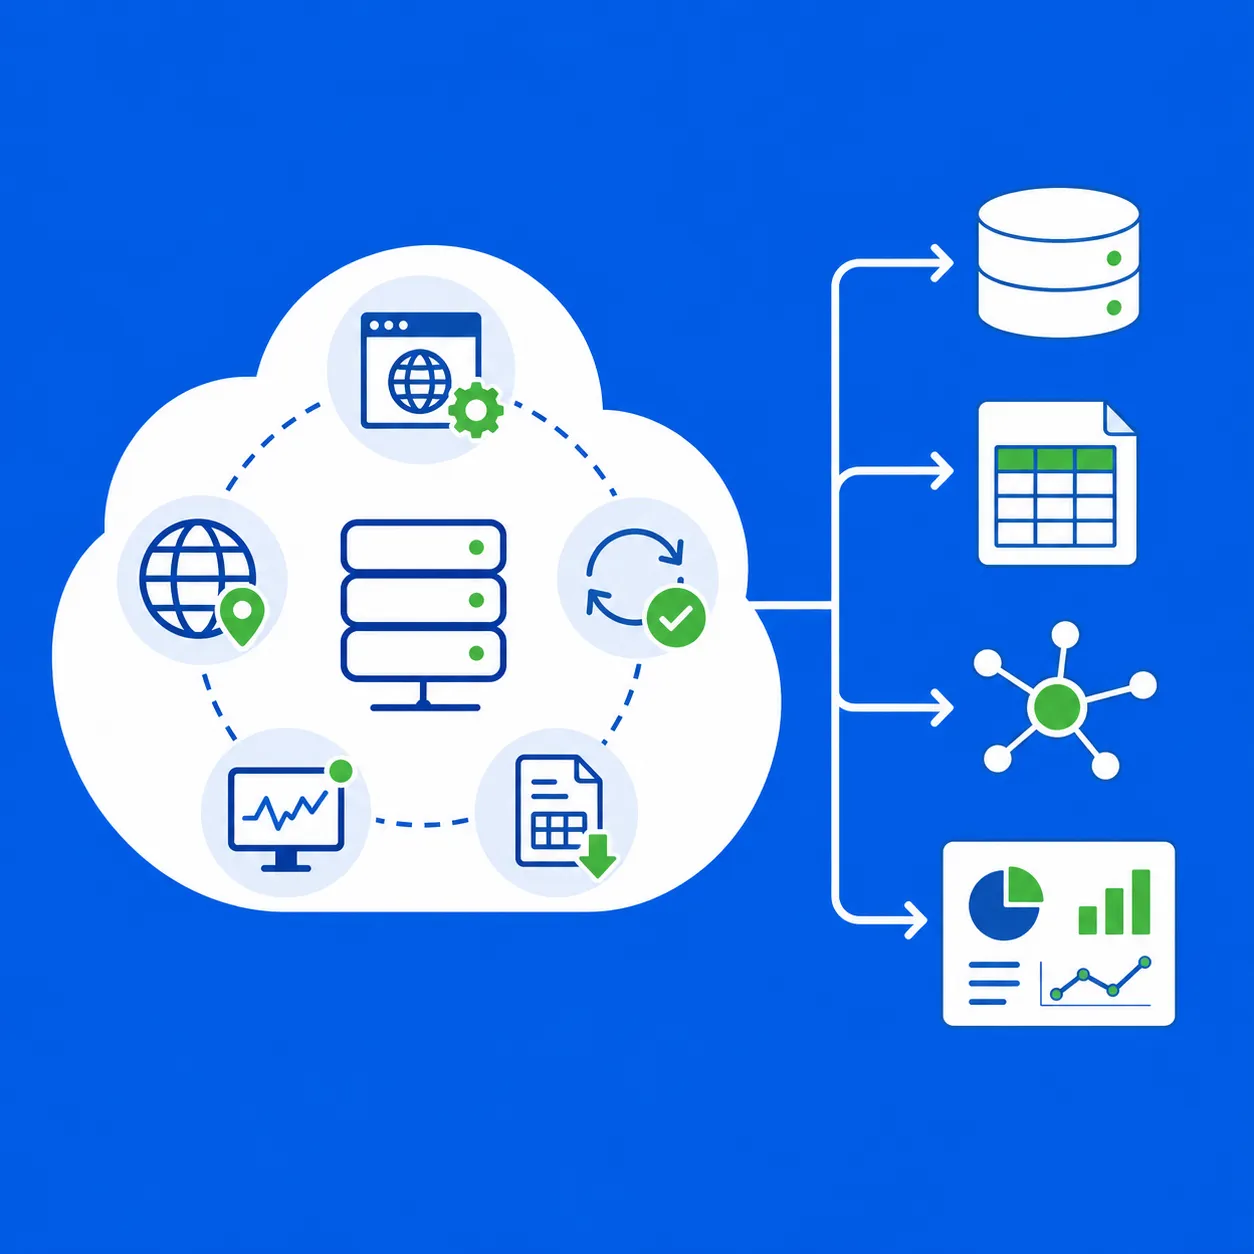
Outscraper se encarga de la capa de extracción de datos de Google Maps para que tu equipo pueda trabajar con los datos empresariales resultantes, en lugar de tener que ocuparse del mantenimiento de la infraestructura de extracción de datos.
¿Cuánto cuesta crear tu propio rastreador de Google Maps?
El coste de un rastreador creado por uno mismo va más allá de escribir la primera versión del código. Una vez que el rastreador admite tareas recurrentes, el equipo también debe hacer frente a los gastos de los sistemas y al tiempo de ingeniería necesarios para mantenerlo en funcionamiento.
Compara el coste de construir el rascador con el coste de mantenerlo en funcionamiento.
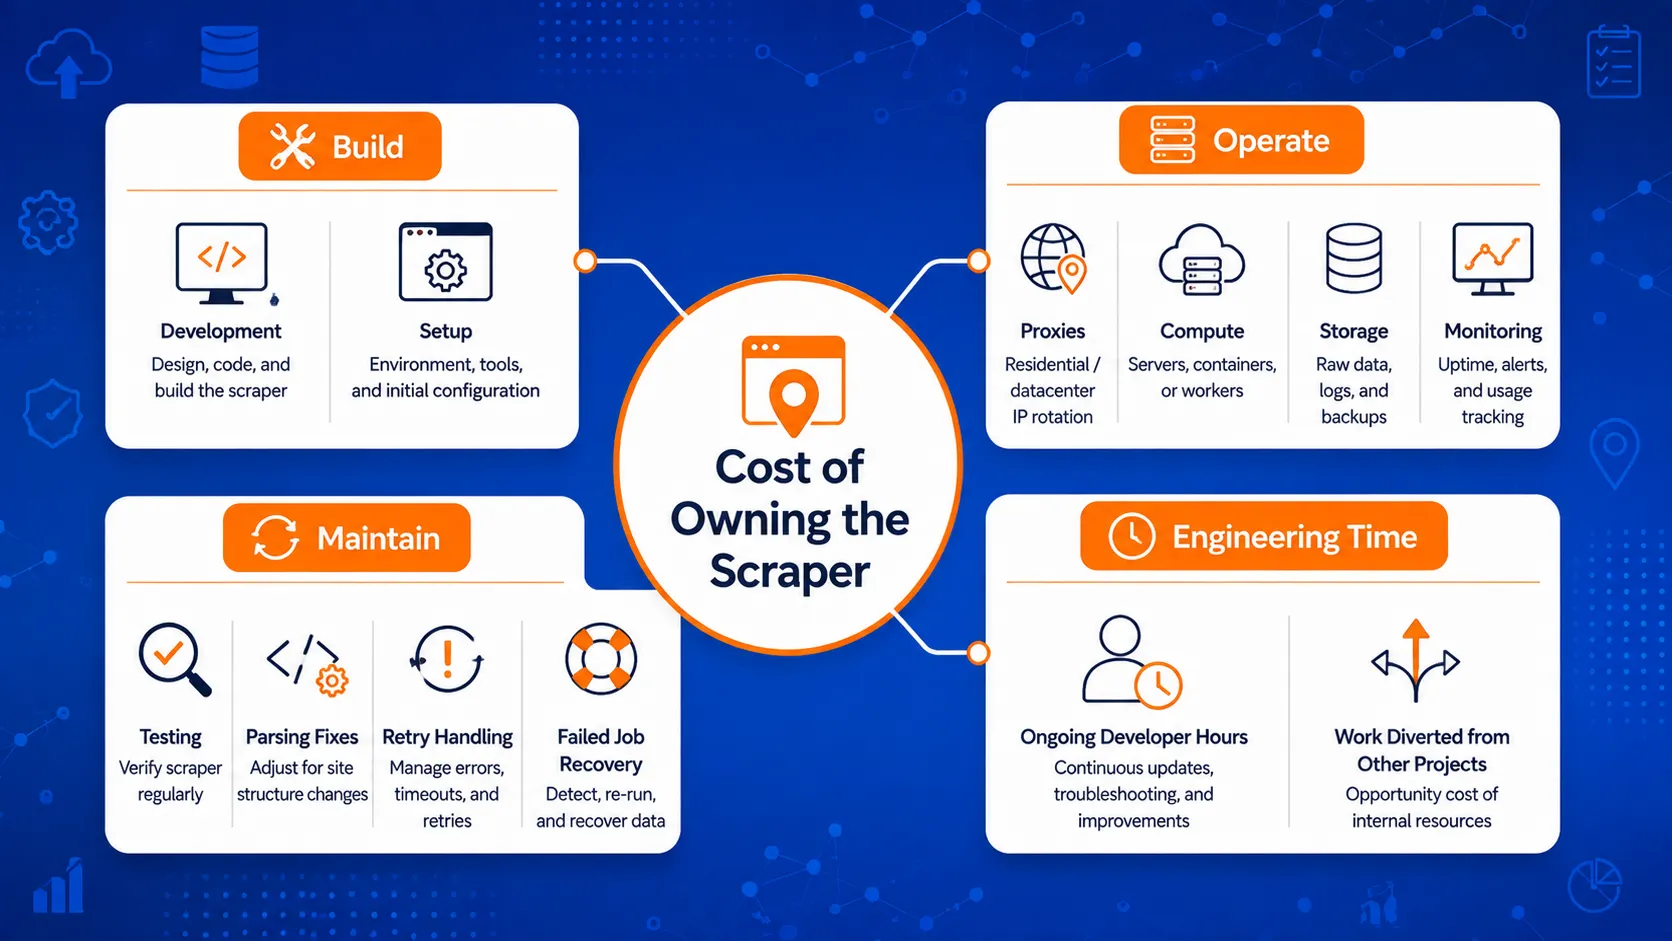
Tiempo de ingeniería inicial
La primera compilación puede incluir algo más que el propio script de extracción.
Es posible que los ingenieros también tengan que configurar la automatización del navegador, la gestión de solicitudes, el enrutamiento por proxy, el almacenamiento de datos, las reglas de reintento, el registro de eventos y las comprobaciones de resultados. La cantidad de trabajo depende de la cantidad de datos que deba recopilar el rastreador y del nivel de fiabilidad que deba tener el flujo de trabajo.
Una pequeña prueba interna tiene requisitos muy diferentes a los de un rastreador que alimenta una base de datos de producción cada semana.
Costes de proxy e infraestructura
El scraping recurrente puede requerir una infraestructura de pago, como proxies, servidores, almacenamiento y sistemas de supervisión.
Estos costes pueden aumentar en función del número de búsquedas, ubicaciones y registros que se recopilen. También pueden variar cuando el rastreador necesite recursos adicionales para gestionar trabajos de mayor envergadura o solicitudes fallidas.
Lo importante es que, por lo general, las infraestructuras siguen formando parte de los costes de explotación una vez finalizada la construcción.
Tiempo de mantenimiento
Hay que prestar atención a un scraper cuando cambia su comportamiento de extracción o cuando los resultados dejan de ajustarse a lo esperado.
Dichas tareas pueden incluir:
- corrección de selectores o reglas de análisis sintáctico
- sustitución de los servidores proxy que fallan
- Comprobación de trabajos incompletos
- Actualización de la automatización del navegador
- revisar los registros
- probar los cambios antes de ejecutar el siguiente lote
Incluso las soluciones rápidas acaban sumando cuando el rastreador pasa a formar parte de un proceso de datos recurrente.
Costes de fallo y recuperación
Las tareas fallidas también consumen tiempo.
Alguien tiene que identificar qué ha fallado, determinar qué registros ya se han recopilado, volver a realizar el trabajo que falta y comprobar que el resultado final no presente lagunas ni duplicados.
Esto cobra mayor importancia cuando un lote defectuoso retrasa otro proceso, como la preparación de listas de clientes potenciales, un estudio de mercado o una aplicación interna que depende de esos datos.
Coste de oportunidad en ingeniería
El tiempo dedicado a la ingeniería conlleva otro coste: el trabajo que no se lleva a cabo mientras los desarrolladores se ocupan del rastreador.
Es posible que un equipo prefiera dedicar esas horas a crear herramientas de generación de informes, mejorar su base de datos, añadir pasos de enriquecimiento o desarrollar funciones relacionadas con los datos recopilados.
Por eso, el mantenimiento de los rascadores es una decisión tanto empresarial como técnica.
| Área de costes | Durante la fase inicial de desarrollo | Durante el uso continuado |
|---|---|---|
| Ingeniería | Lógica y configuración de la extracción | Correcciones, pruebas y actualizaciones |
| Servidores proxy | Configuración y pruebas | Uso recurrente |
| Infraestructura | Servidores, almacenamiento, registro de datos | Alojamiento y supervisión |
| Recuperación del empleo | Lógica de reintento | Tareas fallidas y parciales |
| Comprobaciones de datos | Configuración de salida | Campos que faltan o que están mal rellenados |
| Tiempo de ingeniería | Fabricación del rascador | Mantenimiento del proceso de extracción |
Para comparar estos costes internos con la opción gestionada, también puedes analizar cómo Precios de Google Maps Scraper cómo funciona y qué parámetros pueden influir en el coste de las tareas.
Es posible que la opción más económica al principio deje de serlo una vez que se tengan en cuenta los gastos de mantenimiento, los trabajos fallidos y el tiempo dedicado a la ingeniería.
Cuándo tiene sentido hacerlo uno mismo
Crear tu propio scraper puede seguir siendo la mejor opción cuando el proceso de extracción en sí mismo es importante para el producto o cuando el equipo tiene una razón clara para controlar toda la configuración.
Necesitas una lógica de extracción muy personalizada
Un scraper gestionado puede cubrir los campos y el flujo de trabajo que necesitan la mayoría de los equipos, pero algunos proyectos requieren reglas de extracción específicas para una aplicación concreta.
Esto puede incluir una lógica de análisis sintáctico inusual, un comportamiento personalizado de las páginas, pasos de validación especiales o un flujo de trabajo basado en datos que los proveedores estándar no proporcionan.
En esos casos, disponer del propio «scraper» ofrece al equipo de ingeniería más libertad para modificar el funcionamiento de la extracción.
Ya contáis con ingenieros de scraping internos
La carga que supone el mantenimiento es diferente cuando una empresa ya cuenta con ingenieros encargados de los sistemas de extracción de datos.
Es posible que ya cuenten con una infraestructura de proxy, sistemas de supervisión, lógica de reintentos, almacenamiento y herramientas internas para gestionar los trabajos fallidos. Añadir un rastreador de Google Maps a esa configuración puede resultar más razonable que incorporar otro servicio externo.
La cuestión principal es si el equipo dispone de capacidad suficiente para mantenerlo sin desviar la atención de las tareas de mayor prioridad.
El flujo de trabajo es limitado o experimental
Una pequeña prueba no siempre requiere una infraestructura de nivel de producción.
Para un proyecto de investigación breve, una prueba de concepto o un experimento interno de alcance limitado, un rastreador básico puede ser suficiente para responder a la pregunta que el equipo está analizando.
La decisión cambia si ese script temporal empieza a convertirse en una fuente de datos recurrente. En ese momento, las tareas de mantenimiento mencionadas anteriormente cobran mayor importancia.
El control total de la infraestructura es fundamental
Algunos equipos necesitan tener un control directo sobre cómo se realizan las solicitudes, dónde se procesan los datos, cómo se almacenan los registros o cómo se comporta el sistema cuando falla una tarea.
Esos requisitos pueden derivarse de normas internas de ingeniería, políticas de seguridad o la arquitectura del producto.
Si se requiere ese nivel de control, puede resultar más fácil justificar el desarrollo interno, incluso cuando ello suponga más trabajo de mantenimiento.
El «scraping» forma parte del producto
Para algunas empresas, el scraping no es solo una forma de recopilar datos de entrada. El propio sistema de extracción forma parte de lo que la empresa desarrolla y mantiene.
Un equipo que desarrolle su propio producto de datos, rastreador o plataforma de extracción puede tener razones de mayor peso para ser propietario de la tecnología subyacente.
En esa situación, el trabajo de ingeniería contribuye directamente al producto, en lugar de quedarse al margen de la labor principal del equipo.
La opción de hacerlo uno mismo es la más sensata cuando ese control adicional tiene un objetivo claro. Si el rastreador solo sirve para proporcionar datos a otro flujo de trabajo, resulta más difícil justificar el valor de disponer de la capa de extracción.
Cuándo resulta más conveniente utilizar un extractor gestionado de Google Maps
Un scraper gestionado resulta más práctico cuando el equipo necesita los datos de forma habitual, pero no quiere hacerse cargo de los sistemas que mantienen en marcha el proceso de extracción.
Ejecutas tareas periódicas
Una extracción de datos puntual es más fácil de gestionar que un flujo de trabajo que se ejecuta cada semana o cada día.
Las tareas recurrentes aumentan la probabilidad de que se produzcan solicitudes bloqueadas, resultados parciales, lotes fallidos y cambios en el análisis que interrumpan el proceso. Un scraper gestionado puede reducir la cantidad de trabajo interno necesario para mantener esas tareas en funcionamiento.
Necesitas conjuntos de datos repetidos o más amplios
La carga de mantenimiento aumenta cuando un mismo flujo de trabajo tiene que abarcar más búsquedas, ubicaciones o registros.
En ese momento, el reto ya no se limita a la lógica de extracción. El equipo también tiene que gestionar los reintentos, el seguimiento de los trabajos, la infraestructura y las comprobaciones de los resultados en un volumen de trabajo mayor.
Un servicio gestionado puede resultar más fácil de justificar cuando el equipo necesita un acceso constante a los datos de la empresa sin tener que ampliar la configuración de extracción de datos a nivel interno.
Tu equipo necesita los datos, no el rastreador
Muchos equipos utilizan los datos de empresas de Google Maps como información de partida para otra tarea.
Esto puede incluir la captación de clientes potenciales, los estudios de mercado, el análisis de empresas locales, las bases de datos internas o las funcionalidades de las aplicaciones. En esos flujos de trabajo, el mantenimiento del rastreador no mejora directamente el uso final de los datos.
Outscraper's servicio gestionado de extracción de datos de Google Maps Se adapta a este tipo de configuración al encargarse de la parte de extracción mientras el usuario trabaja con los datos empresariales resultantes.
Necesitas un acceso a los datos basado en una API
Las exportaciones manuales pueden ser suficientes para investigaciones puntuales, pero los flujos de trabajo recurrentes suelen requerir que los datos se transfieran automáticamente a otro sistema.
Una API permite que una aplicación o un proceso interno solicite datos mediante código y siga trabajando con los resultados una vez extraídos.
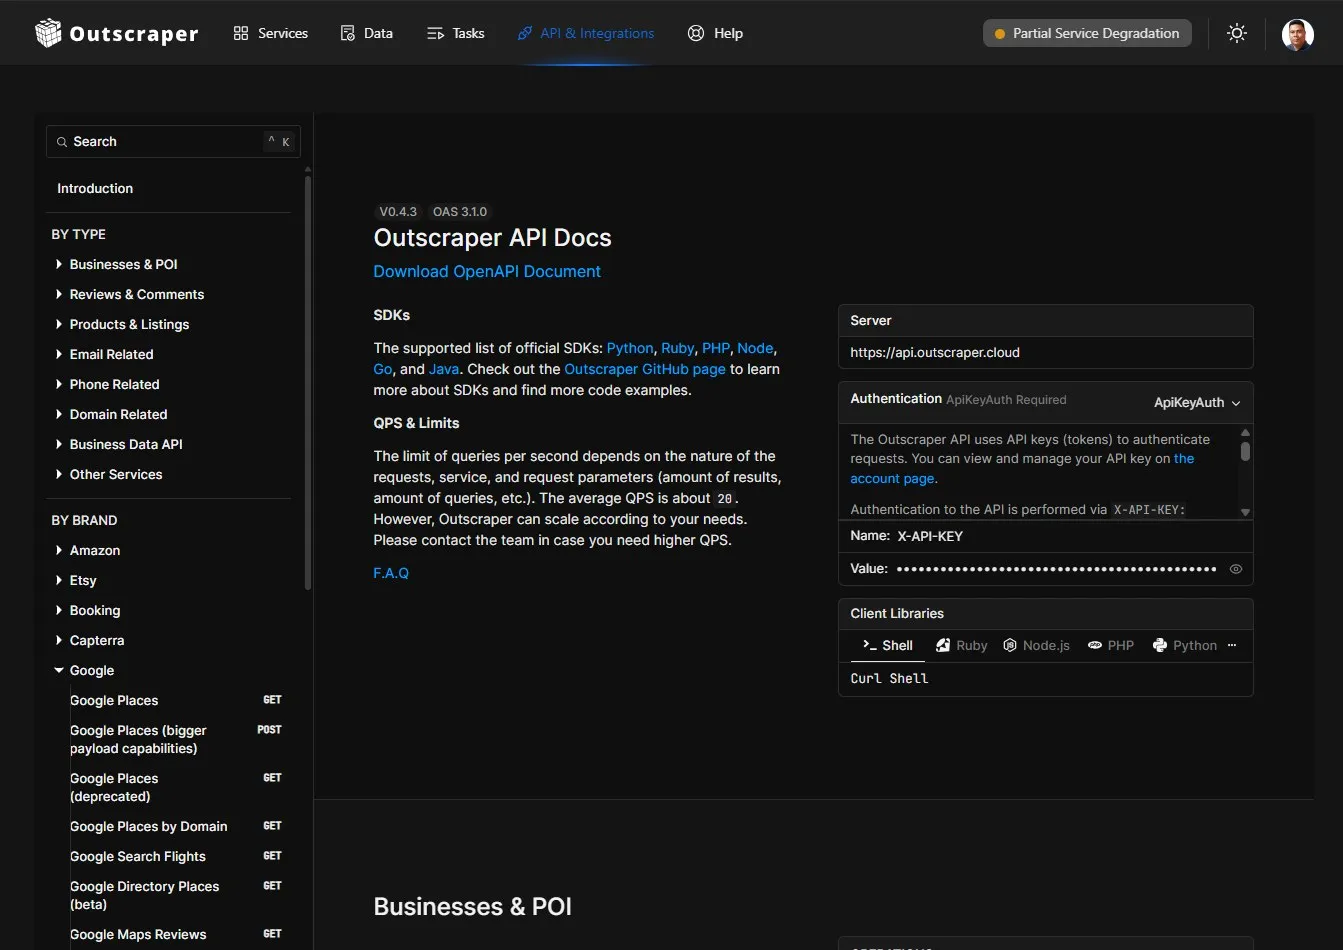
Los desarrolladores pueden consultar el Documentación de la API de Outscraper para conocer los puntos finales, los parámetros, las respuestas y los ejemplos de código actuales.
Esto permite a los desarrolladores controlar los aspectos importantes de su propio sistema sin que tengan que encargarse del mantenimiento del extractor de datos de Google Maps subyacente.
El tiempo dedicado a la ingeniería se aprovecha mejor en las fases posteriores
El coste de mantenimiento de un «scraper» también incluye el trabajo que los desarrolladores no están realizando en otras tareas.
Un equipo puede obtener mayores beneficios si dedica tiempo de ingeniería al diseño de bases de datos, a herramientas internas, a la elaboración de informes, al enriquecimiento de datos, al análisis o a las funcionalidades del producto desarrolladas en torno a los datos recopilados.
Un scraper gestionado resulta la mejor opción cuando la capa de extracción es necesaria, pero no es fundamental para lo que el equipo está intentando desarrollar.
Utiliza Outscraper para la recopilación periódica de datos de Google Maps sin dejar de lado tus procesos de generación de clientes potenciales, investigación, bases de datos o aplicaciones.
¿Deberías crear un rastreador de Google Maps o utilizar un servicio gestionado?
La elección resulta más sencilla cuando se compara quién es el responsable de cada parte del flujo de trabajo.
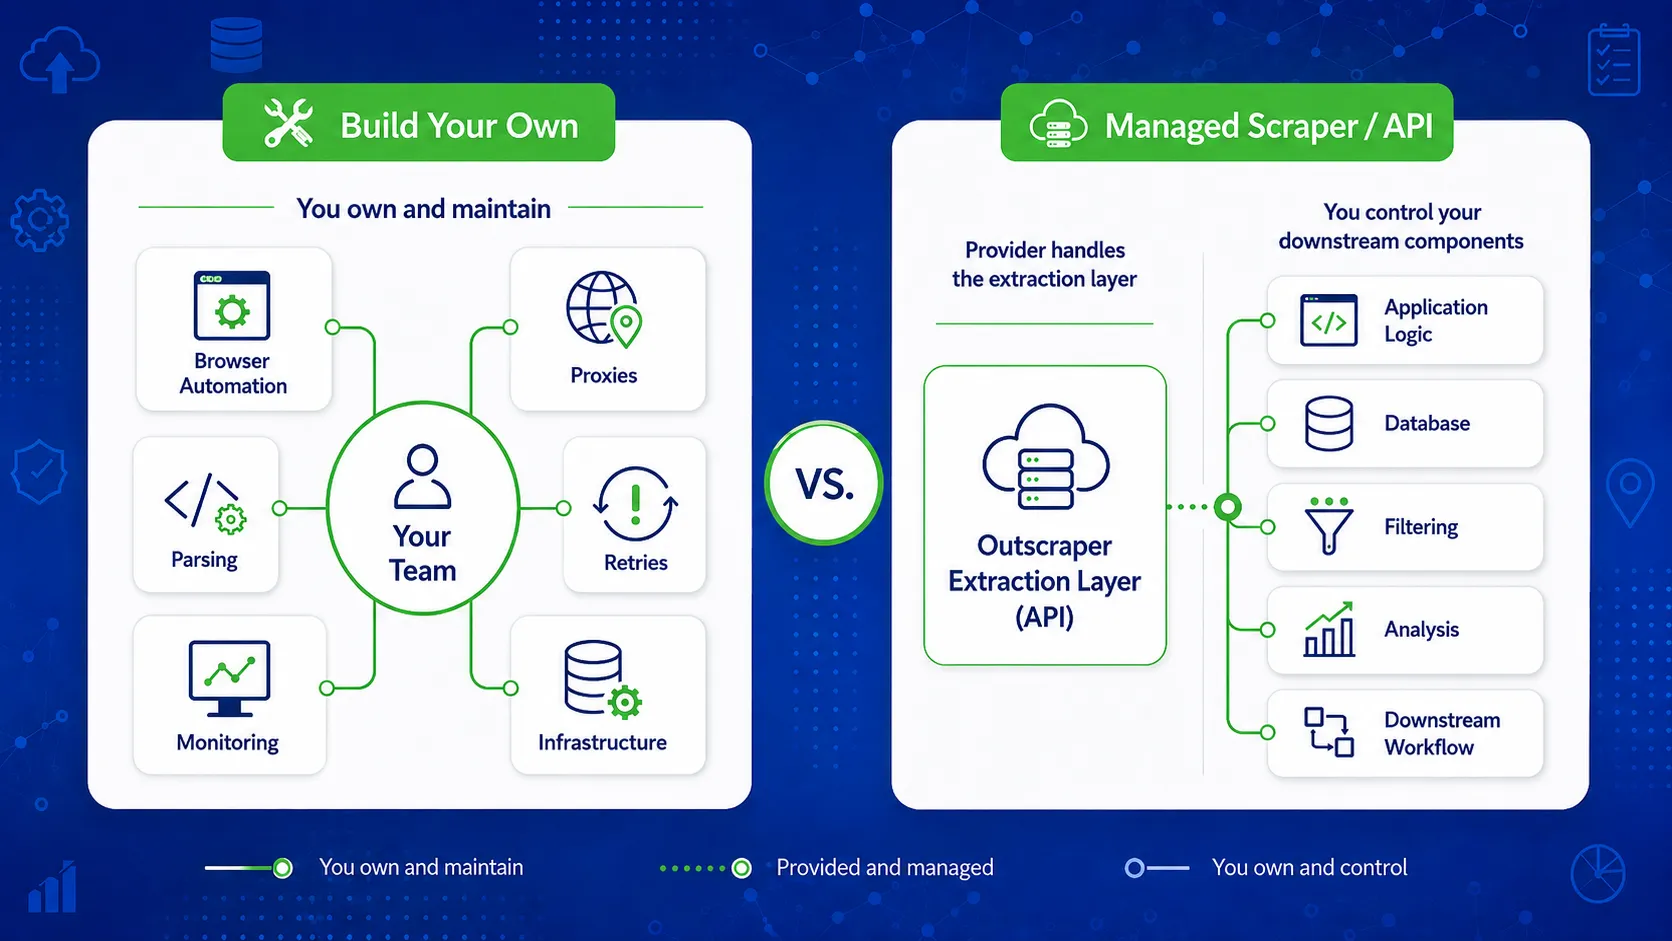
| Factor | Crea el tuyo propio | Scraper gestionado / API |
|---|---|---|
| Control de la extracción | Control total | Sujeto a las capacidades del proveedor |
| Trabajos iniciales de ingeniería | Más alto | Inferior |
| Mantenimiento del navegador | Tu equipo | Proveedor |
| Gestión de proxies | Tu equipo | Proveedor |
| Análisis de los cambios | Tu equipo | Proveedor |
| Gestión de reintentos | Tu equipo | Normalmente lo gestiona el proveedor |
| Seguimiento | Tu equipo | El proveedor se encarga de la capa de extracción |
| Personalización del flujo de trabajo | El más alto | Valores elevados en torno a la API y la producción |
| Escalado | Requiere más trabajo de ingeniería | Normalmente es más fácil ampliarlo |
| El más adecuado | Equipos con requisitos técnicos específicos | Equipos centrados en el uso de los datos |
Ninguna de las dos opciones es automáticamente mejor. La elección adecuada depende del grado de control que necesite tu equipo y de la cantidad de tareas de mantenimiento que quiera gestionar internamente.
Una tercera opción: crear el flujo de trabajo, no el rastreador
La decisión no tiene por qué limitarse a desarrollar todo por tu cuenta o a delegar todo el flujo de trabajo a un proveedor.
Un equipo puede mantener el control sobre su aplicación, la lógica de consulta, el almacenamiento, el filtrado, el enriquecimiento y el procesamiento posterior, al tiempo que utiliza una API de extracción gestionada para la fase de extracción.
Para conocer los aspectos técnicos de esta configuración, consulta cómo API de Outscraper se puede utilizar en el interior flujos de trabajo de datos personalizados.
Una configuración podría tener este aspecto:
Tu aplicación o automatización
→ API de scraper gestionada
→ Datos de empresas de Google Maps
→ Tu base de datos, CRM, herramienta de generación de informes o sistema interno.
Este enfoque puede resultar adecuado para desarrolladores y equipos de datos que deseen disponer de acceso programático sin tener que gestionar navegadores, proxies, lógica de análisis ni infraestructura de extracción.
El equipo sigue controlando cómo se utilizan los datos una vez recopilados. El proveedor se encarga de la parte relativa a su recopilación.
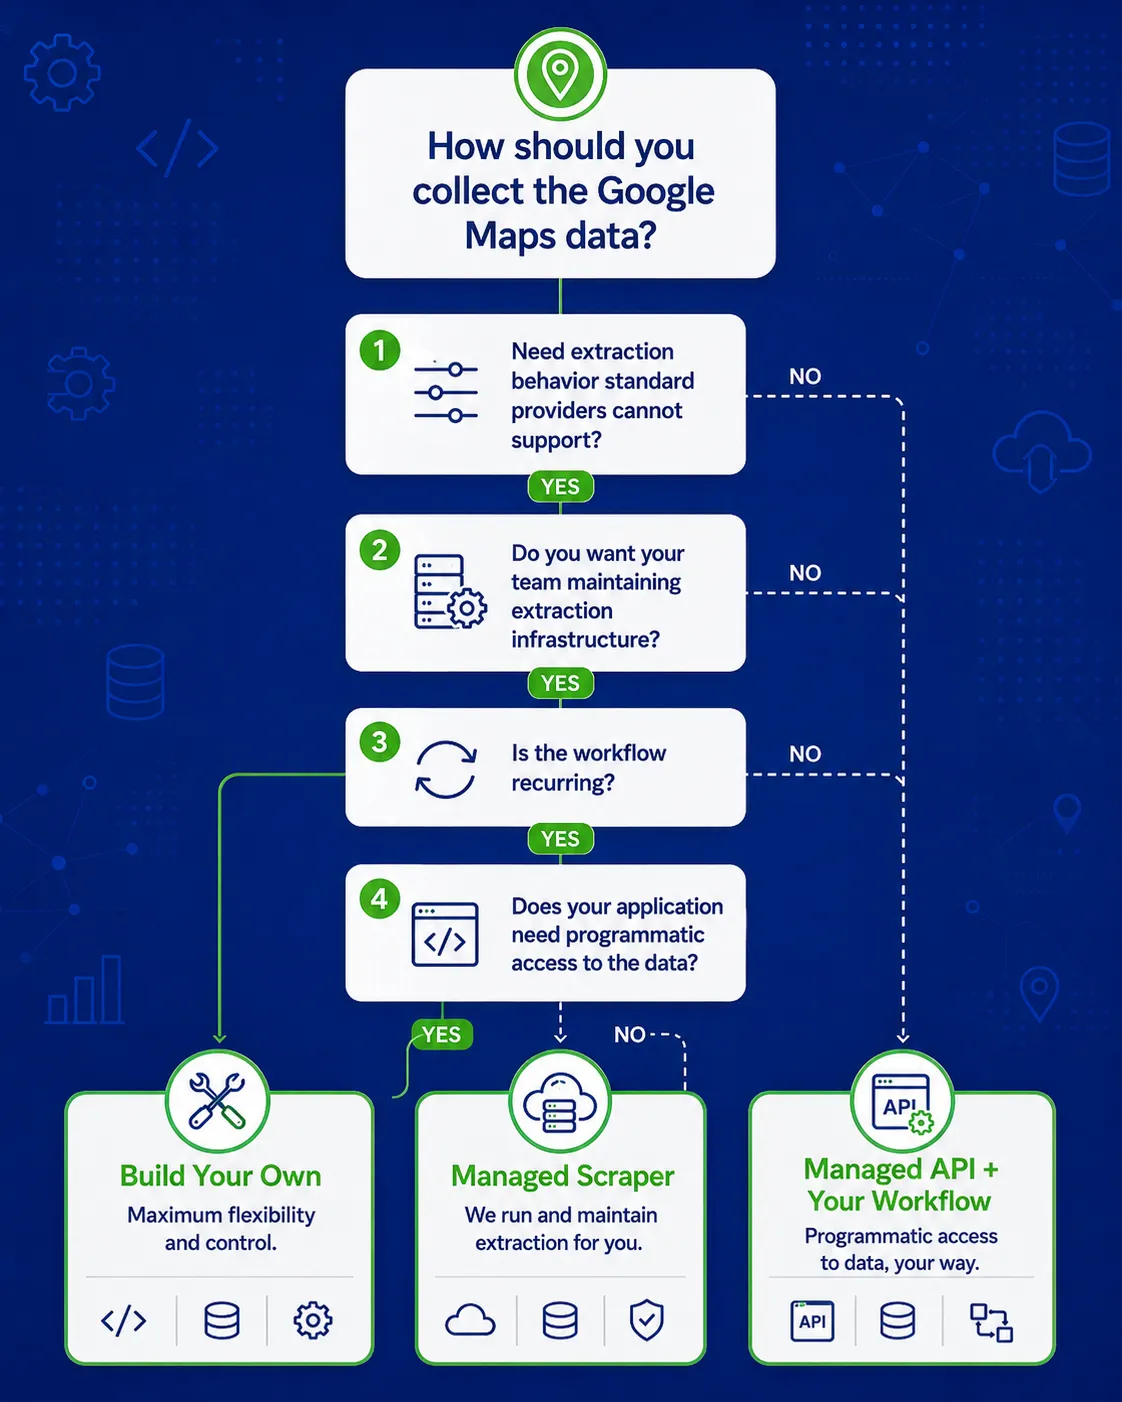
Mantén el control sobre la lógica de tu aplicación, el almacenamiento, el filtrado y el procesamiento posterior, mientras que Outscraper se encarga de la extracción de datos de Google Maps.
Preguntas que debes hacerte antes de elegir
La elección técnica resulta más sencilla cuando se define cómo se va a utilizar el scraper, quién se encargará de su mantenimiento y qué ocurre cuando el flujo de trabajo deja de funcionar como se esperaba.
¿Con qué frecuencia lo vas a utilizar?
Un rastreador que se utiliza para un trabajo de investigación puntual tiene requisitos distintos a los de uno que se ejecuta a diario o semanalmente.
Las tareas recurrentes generan más trabajo de mantenimiento, ya que los fallos, los cambios en el análisis sintáctico y los problemas de infraestructura tienen más posibilidades de interrumpir el proceso.
¿Cuántos datos necesitas?
Unas cuantas búsquedas para una prueba interna son más fáciles de gestionar que recopilar datos empresariales de cientos de ubicaciones o categorías.
A medida que aumenta el volumen, el seguimiento de tareas, los reintentos, el uso de proxies, el almacenamiento y la supervisión pasan a ocupar una parte cada vez mayor de la carga de trabajo.
¿Hasta qué punto son específicos tus requisitos de extracción?
Enumera los campos y las reglas de extracción que necesitas antes de decidirte a crear la aplicación.
Si tus necesidades dependen de un comportamiento inusual de la página o de campos que los proveedores gestionados no admiten, puede que resulte más fácil justificar el uso de un rastreador personalizado.
Si los datos empresariales necesarios ya están disponibles a través de un servicio gestionado, gestionar la lógica de extracción puede suponer un trabajo adicional sin aportar grandes beneficios.
¿Quién se encarga de repararlo cuando se estropea algo?
Alguien tiene que asumir la responsabilidad cuando se interrumpe un trabajo, desaparece un sector o cambia la producción.
Identifica a esa persona o equipo antes de dar por terminado un proyecto de raspador «hazlo tú mismo». El trabajo de mantenimiento necesita un responsable, igual que cualquier otro sistema de producción.
¿Necesitas una API?
Una API resulta importante cuando otra aplicación, base de datos o sistema de automatización necesita solicitar datos sin que sea necesario que alguien inicie y descargue manualmente cada tarea.
Es aquí también donde puede cambiar la decisión sobre la implementación. Un equipo puede seguir desarrollando su propia aplicación, aunque utilice una API gestionada para la fase de extracción.
¿Cuánto cuesta el tiempo de ingeniería?
Las tarifas de los servidores proxy son gastos visibles. El tiempo dedicado a la ingeniería es más fácil de pasar por alto.
Calcula el tiempo necesario para la supervisión, la depuración, las pruebas, la recuperación y los cambios futuros. A continuación, compara ese trabajo con otras tareas de las que se encargan los mismos ingenieros.
¿Qué ocurre cuando los trabajos fracasan?
Prepárate tanto para resultados parciales como para fracasos totales.
Pregunta cómo identificará el sistema los registros que falten, cómo volverá a intentar el trabajo que quede pendiente, cómo evitará la duplicación de datos y cómo avisará al equipo cuando un trabajo requiera atención.
Un scraper que funciona cuando todo va bien es solo una parte del flujo de trabajo de producción.
¿Qué requisitos legales, contractuales o relativos al uso de datos se aplican?
Las normas sobre la extracción de datos pueden depender de la fuente, sus condiciones, el tipo de datos recopilados, la jurisdicción y el uso que se vaya a dar a los datos.
Google también publica su propio Condiciones de uso de Google Maps Platform y las directrices normativas correspondientes, que deben revisarse cuando un flujo de trabajo dependa de los servicios de Google Maps Platform.
Revisa los requisitos que se aplican a tu flujo de trabajo concreto antes de decidir cómo se recopilarán o tratarán los datos. Esta sección no constituye asesoramiento jurídico.
Lista de comprobación para la toma de decisiones sobre el «scraper» de Google Maps
- Indica con qué frecuencia necesitas los datos.
- Indica los campos y las reglas de extracción que necesitas.
- Realiza un presupuesto de los trabajos de mantenimiento e ingeniería.
- Decide quién se hará responsable de los fallos y de su solución.
- Comprueba si es necesario el acceso a la API mediante programación.
- Compara el valor que aporta el control total del rascador con el trabajo que supone mantenerlo.
- Revisa las normas que se aplican a tu flujo de trabajo de datos.
Outscraper puede encargarse de la capa de extracción de datos de Google Maps mientras tu equipo se centra en utilizar esos datos para la generación de clientes potenciales, la investigación, las bases de datos o las aplicaciones.
Preguntas más frecuentes
Preguntas y respuestas más frecuentes
Crear un prototipo de un rastreador básico puede resultar relativamente sencillo. Lo más complicado es garantizar su fiabilidad ante trabajos repetidos, solicitudes bloqueadas, cambios en las páginas, reintentos y cargas de trabajo más voluminosas.
La dificultad depende de la frecuencia con la que se ejecute, de la cantidad de datos que recopile y del nivel de mantenimiento que requiera el flujo de trabajo.
No hay un coste único que se aplique a todos los proyectos.
El coste total depende del tiempo de ingeniería, los servidores proxy, los servidores, el almacenamiento, la supervisión, el mantenimiento y la recuperación de tareas fallidas. Una breve prueba interna puede costar mucho menos que un rastreador que se ejecute de forma continua como parte de un sistema de producción.
Depende de la carga de trabajo.
Un rastreador de creación propia puede suponer un coste inicial menor cuando el proyecto es pequeño y ya se dispone de recursos de ingeniería. Un rastreador gestionado puede resultar más práctico si se tienen en cuenta en la comparación el mantenimiento periódico, los costes de proxy, los trabajos fallidos y el tiempo de los desarrolladores.
Sí. Un desarrollador puede crear la aplicación, la base de datos, los filtros, las reglas de negocio y el procesamiento posterior, al tiempo que utiliza una API de scraper gestionada para la extracción de datos. Outscraper Admite este tipo de configuración a través de sus servicios de extracción de datos y API.
Este enfoque te permite mantener el control sobre la lógica de la aplicación sin que tu equipo tenga que encargarse del mantenimiento de la capa de extracción de datos.
“El término ”seguro» puede referirse a varios aspectos distintos.
Antes de elegir un proveedor, comprueba cómo se ejecutan las tareas, si queda expuesta tu propia dirección IP o tu cuenta de Google, cómo se gestionan las credenciales de la API y los datos recopilados, qué ocurre cuando fallan las tareas y qué requisitos legales o contractuales se aplican a tu caso concreto.
Un servicio de terceros debería evaluarse en función de esos aspectos, en lugar de considerarse seguro simplemente por el hecho de estar gestionado.
Sí, dependiendo de los datos y del flujo de trabajo que necesites.
Las API de Google Maps Platform y el web scraping son formas distintas de acceder a información relacionada con lugares, con diferentes campos, límites, costes y normas de uso. Si esa es la decisión principal que tienes que tomar, la guía específica Comparación entre la API de Google Maps y el web scraping Es el mejor lugar para analizar esas diferencias.