Índice
A identificar las cadenas de tiendas A la hora de trabajar con datos de Google Maps a gran escala, primero hay que diferenciar dos problemas distintos: identificar cada ubicación física y determinar si dicha ubicación pertenece a una cadena más amplia. La simple coincidencia de nombres no es suficiente, ya que negocios no relacionados pueden compartir nombres similares, mientras que los establecimientos que realmente forman parte de una cadena pueden utilizar una imagen de marca ligeramente diferente. Un flujo de trabajo fiable mantiene cada ubicación como un registro independiente, utiliza identificadores de ubicación estables siempre que sea posible, añade la clasificación de la cadena y valida las coincidencias dudosas mediante múltiples indicadores empresariales. Esta guía muestra cómo crear ese proceso sin tratar la detección de duplicados, la pertenencia a una cadena y la titularidad legal como si fueran lo mismo.
Antes de clasificar las cadenas, recopila registros estructurados de Google Maps que incluyan los campos de ubicación, categoría, página web, teléfono, dirección e identificador que necesitarás para la validación.
Respuesta rápida
Para identificar las empresas que forman parte de una cadena en los datos de Google Maps, mantén cada ubicación física como un registro independiente, clasifica si la empresa pertenece a una cadena y valida las coincidencias dudosas utilizando indicios como el nombre de la empresa, la categoría, la página web, el teléfono, la dirección y los patrones de ubicación. No fusiones registros simplemente porque los nombres coincidan, y no consideres la pertenencia a una cadena como prueba de una propiedad jurídica común.
Por qué identificar cadenas de tiendas es más difícil que buscar nombres de empresas
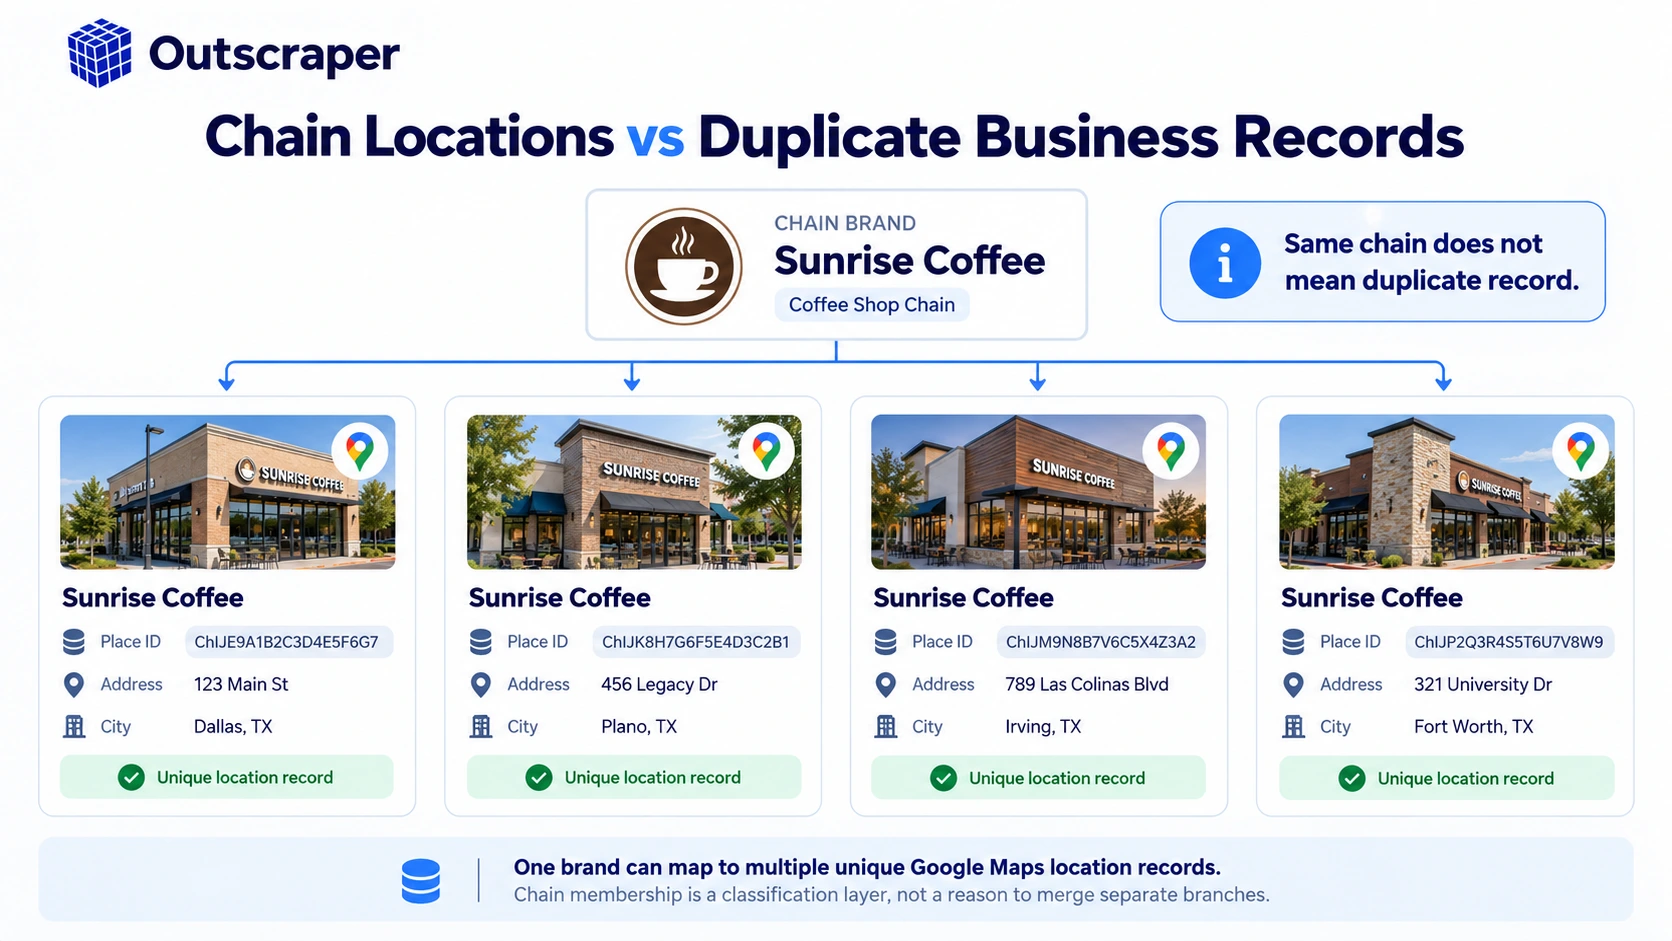
Un conjunto de datos de Google Maps se basa fundamentalmente en la ubicación. Una marca con 150 sucursales puede aparecer como 150 entradas válidas, ya que cada sucursal representa un lugar distinto. Al mismo tiempo, dos empresas que no guardan relación entre sí pueden tener nombres similares o incluso idénticos.
Esto supone una distinción importante:
registro duplicado ≠ ubicación en la cadena ≠ misma empresa
Supongamos que un conjunto de datos contiene cinco registros denominados “Central Coffee”. Esos registros podrían corresponder a cinco sucursales de una misma marca, a varias empresas no relacionadas entre sí que utilizan un nombre común, o a una combinación de ambas situaciones. Eliminar cuatro registros solo porque los nombres coinciden podría hacer que se eliminaran ubicaciones válidas.
También se da el problema contrario. Es posible que una cadena auténtica no utilice exactamente el mismo nombre visible en todos los sitios. Las directrices actuales de Google sobre perfiles de empresa recomiendan, en general, que los nombres y las categorías sean coherentes en todos los establecimientos de la cadena, pero también reconocen excepciones para submarcas, departamentos, diferentes formatos de funcionamiento y variaciones de nomenclatura en la vida real.
Esto significa que la coherencia en los nombres es un indicio útil, pero no constituye por sí sola una prueba suficiente.
Por lo tanto, es necesario definir la unidad de análisis antes de proceder a la clasificación. La guía actual de Outscraper sobre Datos empresariales de Google Maps para el análisis de mercado establece una distinción similar: es posible que los investigadores tengan que contabilizar establecimientos, empresas, marcas o áreas de servicio concretas, en función de la cuestión que se esté estudiando.
Para identificar una cadena, el punto de partida más seguro es:
una ubicación física válida = un registro a nivel de ubicación
A continuación, añade la pertenencia a la cadena como otra capa.
Empieza con un registro por cada ubicación de Google Maps
Antes de decidir si un negocio pertenece a una cadena, asegúrate de que el conjunto de datos permita distinguir de forma fiable un establecimiento de otro.
El nombre de la empresa no es un buen identificador principal, ya que no se garantiza que los nombres sean únicos. La dirección ayuda, pero las diferencias de formato pueden provocar falsos desajustes. Los números de teléfono y las páginas web son útiles, pero también pueden estar compartidos o faltar.
El «Place ID» de Google es un campo de ubicación más fiable, ya que Google describe los «Place ID» como identificadores de lugares en su base de datos de «Places». Google también señala dos limitaciones importantes: un mismo lugar puede tener, en ocasiones, varios «Place ID», y estos pueden cambiar con el tiempo. Google recomienda actualizar los «Place ID» almacenados que tengan más de 12 meses de antigüedad.
Por lo tanto, en este flujo de trabajo, el «Place ID» debe considerarse un identificador de ubicación sólido, y no un identificador corporativo permanente.
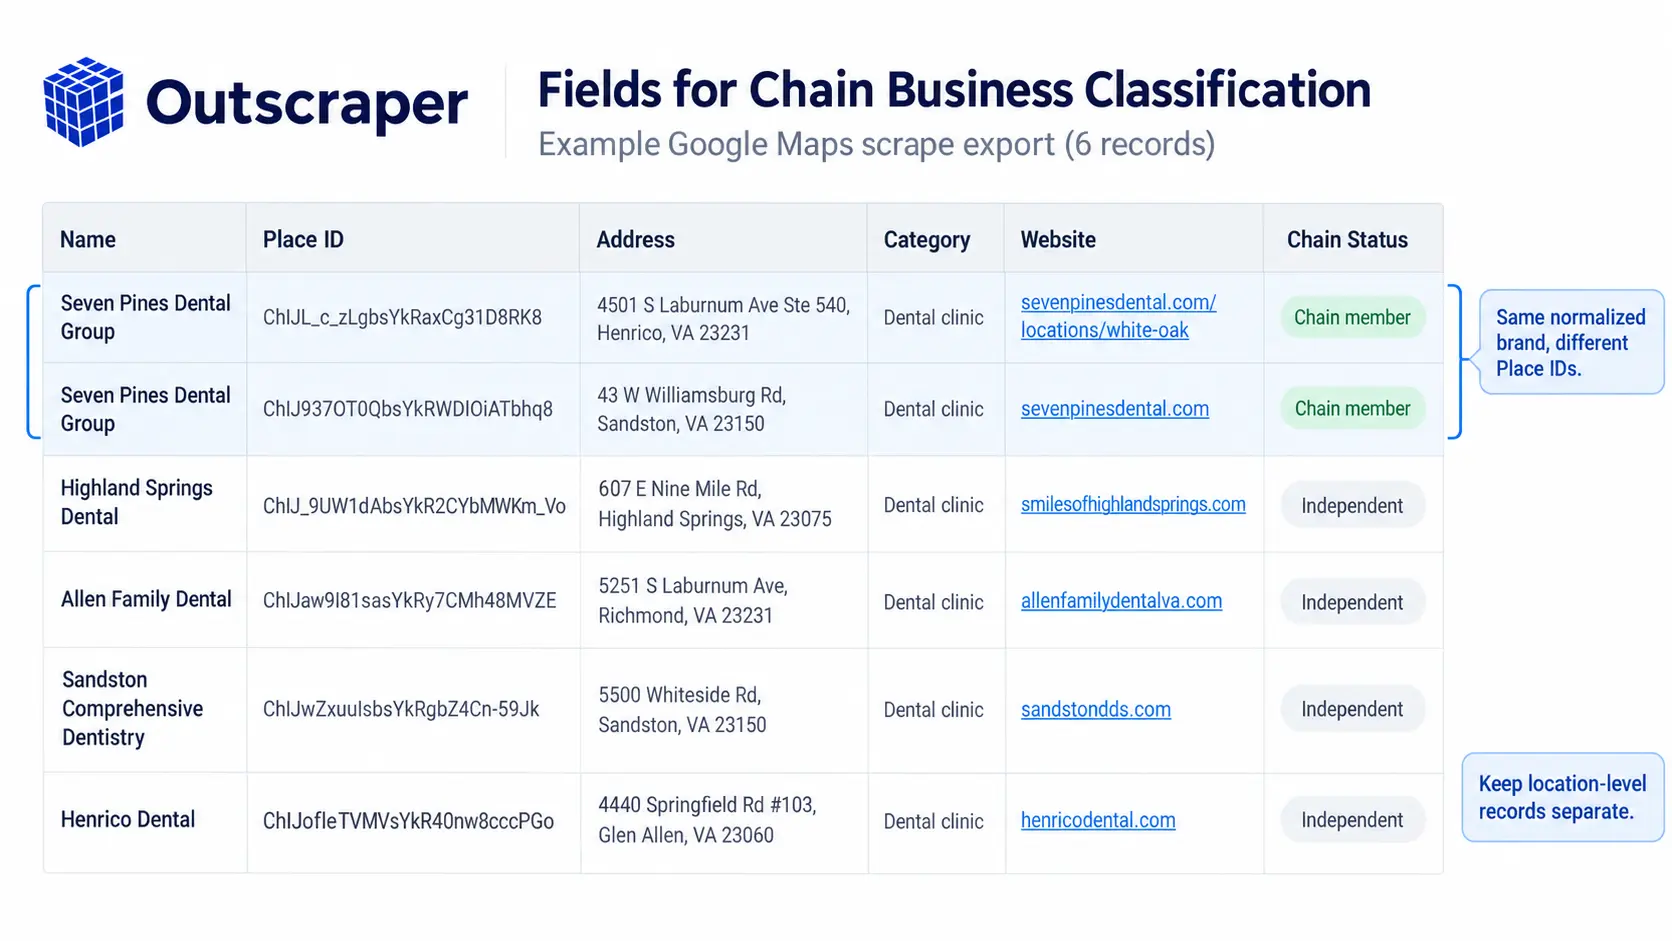
Un conjunto de datos práctico a nivel de ubicación debería incluir campos como:
| Campo | Función en el flujo de trabajo |
|---|---|
| Identificación del lugar | Distingue lugares concretos |
| Denominación social | Aporta pruebas sobre la marca o el nombre |
| Dirección | Confirma la ubicación física |
| Categoría | Ayuda a comparar los tipos de empresas |
| Sitio web | Admite la correspondencia entre marcas y dominios |
| Teléfono | Añade otra señal de identificación |
| Coordenadas | Confirma la separación geográfica |
| Estado de la cadena | Añade la clasificación en «con cadena» y «sin cadena» |
Si tus datos brutos siguen conteniendo resultados de búsqueda repetidos para un mismo lugar, elimina los registros de ubicaciones que se repitan realmente antes de intentar agrupar marcas. Se trata de una operación distinta a la de eliminar varias sucursales de la misma cadena.
Utiliza la clasificación por cadenas antes de intentar agrupar marcas
Una vez que se ha registrado correctamente cada establecimiento, la siguiente pregunta es si el negocio forma parte de una cadena.
La documentación actual de la API de Outscraper recoge los Información sobre la cadena enriquecimiento según el parámetro ai_chain_info. La documentación lo describe como una función que determina si un negocio forma parte de una cadena y añade un indicación de verdadero/falso a los datos devueltos.
Esto resulta útil porque separa dos tareas que a menudo se confunden:
Tarea 1: ¿Este negocio forma parte de una cadena?
Tarea 2: ¿Con qué marca, empresa matriz, red de franquicias o entidad jurídica concreta debería asociarse este establecimiento?
Chain Info respalda la primera pregunta. La documentación actual no indica que proporcione automáticamente una empresa matriz verificada, la identidad del franquiciado, la estructura jurídica de propiedad ni el recuento completo de ubicaciones a nivel mundial.
Esa frontera es importante.
A verdadero El valor de la cadena debe considerarse una señal de clasificación. No debe utilizarse para formular afirmaciones sin fundamento sobre la propiedad.
Por ejemplo:
| Récord | Estado de la cadena | Lo que puedes decir |
|---|---|---|
| Empresa A — Ubicación 1 | Verdadero | Clasificado como parte de una cadena |
| Negocios B | Falso | No está clasificado como parte de una cadena |
| Empresa C — Ubicación 2 | Verdadero | Clasificado como parte de una cadena |
Lo que aún no se puede determinar solo a partir de ese campo booleano es si la «Ubicación 1» es propiedad de la empresa, una franquicia, una licencia, está gestionada por una filial o está vinculada a una entidad jurídica concreta.
Es aquí donde la validación y la agrupación de entidades se convierten en pasos independientes.
Añadir la clasificación en cadena a los registros estructurados
Si tu flujo de trabajo utiliza la API Outscraper, revisa los parámetros de enriquecimiento actuales antes de diseñar el proceso de clasificación.
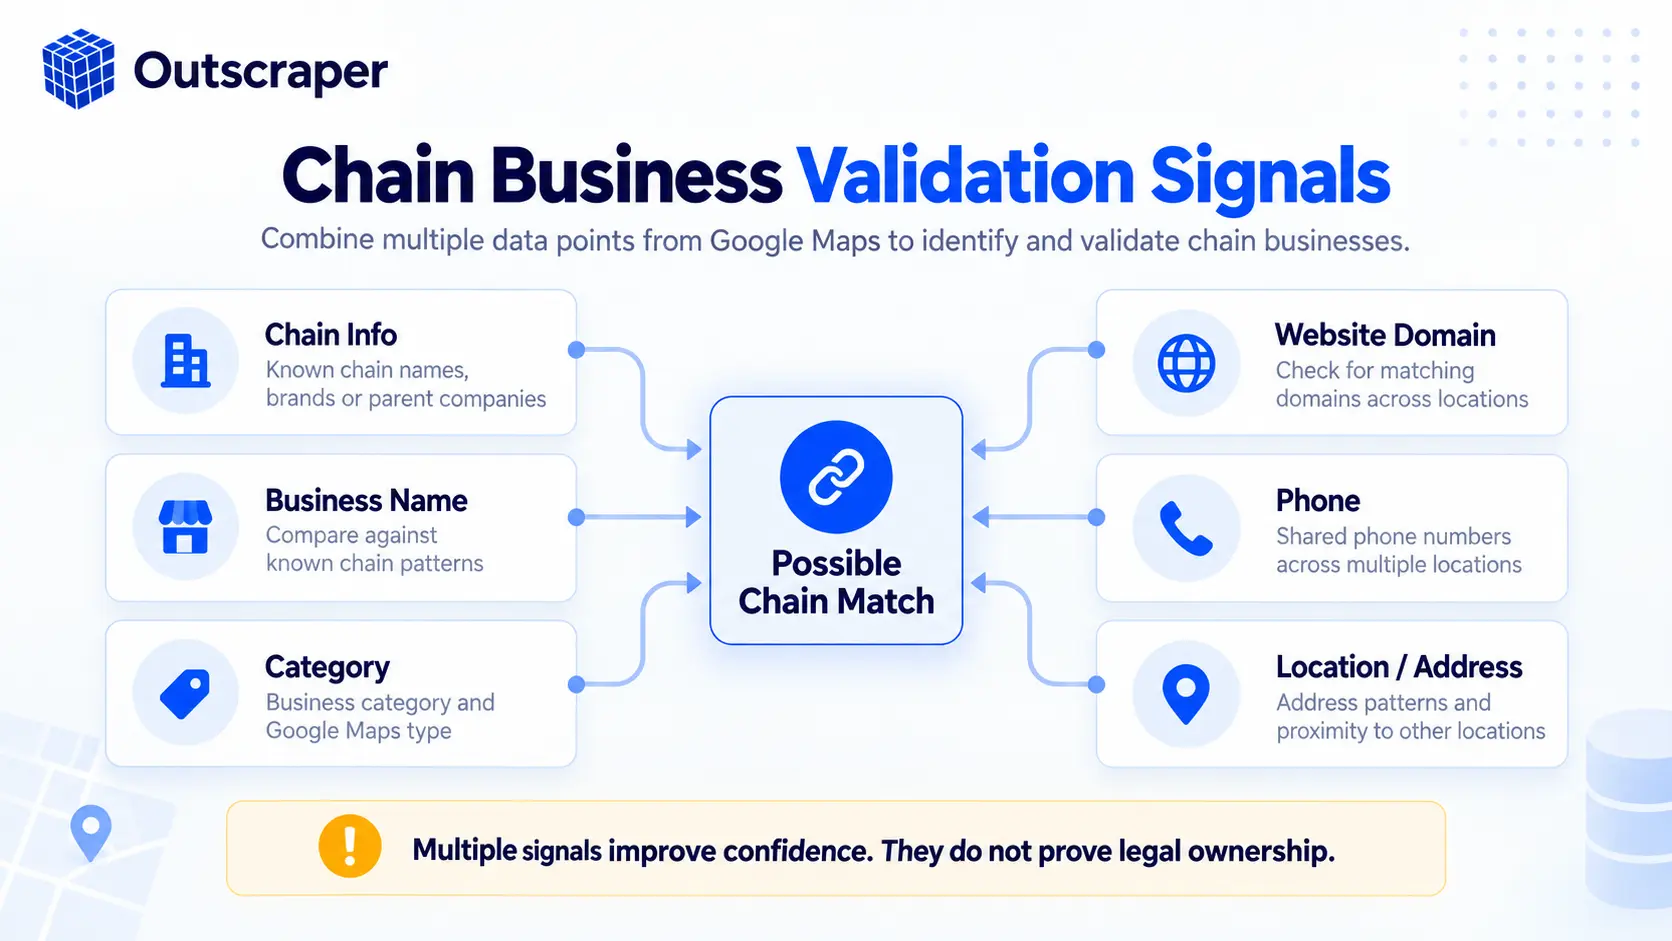
Validar coincidencias de cadenas con múltiples señales empresariales
La clasificación automatizada facilita la gestión de grandes conjuntos de datos, pero es posible que los registros inciertos o de gran valor sigan necesitando validación.
El proceso más eficaz utiliza varias señales a la vez, en lugar de considerar un único campo como definitivo.
Coherencia en los nombres y las categorías
Empieza por el nombre de la empresa y la categoría principal.
Las directrices de Google indican que, por lo general, los establecimientos de una cadena deben utilizar nombres y categorías coherentes cuando ofrecen el mismo servicio. Dichas directrices también recogen excepciones para submarcas, departamentos, diferentes formatos operativos y variaciones de nomenclatura en la práctica.
De ahí se derivan dos reglas útiles:
Un nombre coherente y una categoría coherente refuerzan la posibilidad de que coincidan en la cadena.
El hecho de que el nombre sea diferente no descarta automáticamente que exista una relación de cadena.
Una marca puede operar en varios formatos con diferencias legítimas en la denominación.
Página web y datos de contacto
Los sitios web pueden mejorar la relevancia de una búsqueda cuando varias sedes utilizan el mismo dominio corporativo o cuentan con páginas de sede dentro del mismo dominio.
No obstante, la coincidencia de dominios debe seguir considerándose una prueba complementaria.
Un establecimiento franquiciado puede gestionar su propia página web local. Una empresa puede redirigir varios dominios a una única página web de marca. Además, diferentes empresas pueden utilizar dominios comunes de mercados online o de reservas que revelen poca información sobre su titularidad.
Los datos telefónicos presentan limitaciones similares. Algunas cadenas utilizan números locales para cada sucursal, mientras que otras canalizan las llamadas de varios establecimientos a través de un número centralizado.
Identidad territorial y patrones geográficos
Las direcciones y las coordenadas ayudan a confirmar que los registros corresponden a ubicaciones físicas diferentes y no a exportaciones duplicadas.
La repetición geográfica también puede revelar un patrón típico de cadena: la misma identidad empresarial, o una similar, que se repite en varias ciudades o regiones.
Sin embargo, la escala geográfica no constituye una prueba de titularidad. Una red de licencias, un sistema de franquicias, una cooperativa o empresas independientes con nombres similares pueden dar lugar a patrones aparentemente similares.
Por lo tanto, una regla de validación sólida es:
Utiliza varias fuentes de información para aumentar la fiabilidad; no utilices un solo dato como prueba legal.
Separar la pertenencia a una cadena de la marca y la propiedad
Esta es la parte de la identificación de cadenas que resulta más fácil simplificar en exceso.
Una empresa puede formar parte de una cadena conocida sin que todos sus establecimientos tengan el mismo titular legal.
Los sistemas de franquicias son el ejemplo más evidente. Varios establecimientos pueden compartir una marca, un modelo de funcionamiento y una identidad de cara al cliente, aunque sean gestionados por franquiciados independientes.
Las submarcas plantean otro problema. Google permite expresamente que determinados establecimientos de cadenas utilicen nombres diferentes en el mundo real para formatos comerciales distintos y submarcas.
Ni siquiera dos marcas que operen desde la misma dirección tienen por qué corresponder a un único registro. Según las directrices de Google sobre perfiles de empresa, las marcas que operen de forma independiente en la misma ubicación pueden tener perfiles distintos.
En lo que respecta al trabajo con datos, mantén estos conceptos bien diferenciados:
| Capa de datos | Pregunta |
|---|---|
| Identidad de ubicación | ¿Se trata de un registro físico o de ubicación independiente? |
| Clasificación de cadenas | ¿Se considera que el negocio forma parte de una cadena? |
| Agrupación de marcas | ¿Parece que hay varias discográficas que operan bajo la misma identidad de marca? |
| Titularidad legal | ¿Qué entidad jurídica es propietaria o gestiona el local? |
Los datos de Google Maps pueden servir de base para las primeras capas. Para determinar la titularidad legal, puede ser necesario recurrir a registros corporativos adicionales, información sobre franquicias, datos de la empresa, información de primera mano u otras fuentes fidedignas.
Esta separación también protege el conjunto de datos contra la falsa precisión.
En lugar de escribir:
“Estos 47 establecimientos son propiedad de la empresa X”.”
Cuando no se haya comprobado la titularidad, utilice la conclusión más restrictiva:
“Estos 47 registros se clasificaron o agruparon como ubicaciones asociadas a Brand X basándose en los indicios comerciales disponibles”.”
Esa afirmación es más defendible.
Ampliar la clasificación a un amplio conjunto de datos de Google Maps
La revisión manual puede funcionar para 20 empresas. Sin embargo, deja de ser fiable cuando el conjunto de datos contiene miles de ubicaciones.
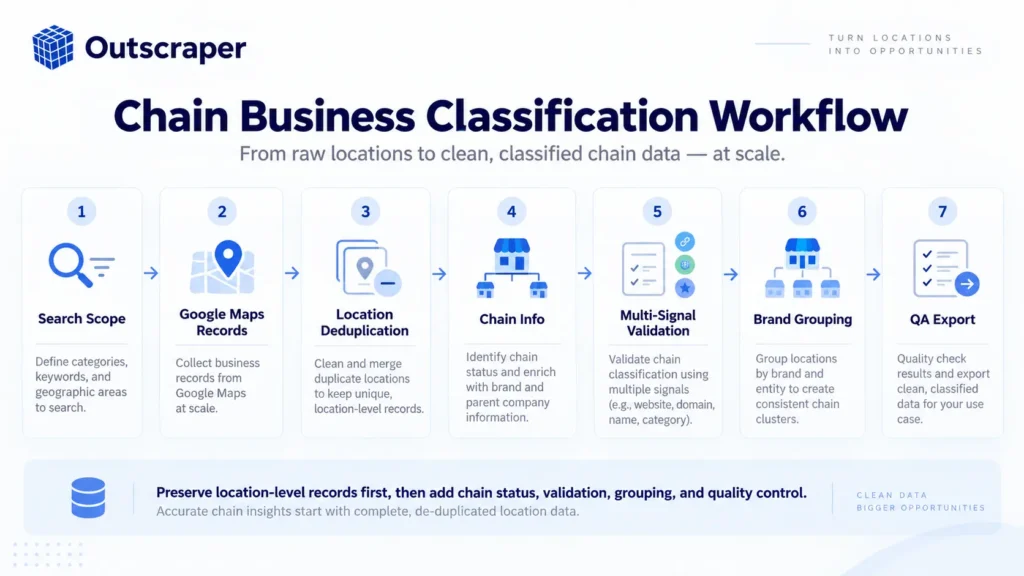
A gran escala, el proceso debería convertirse en un flujo de trabajo repetible.
Un flujo de trabajo práctico sería el siguiente:
Define el ámbito de la recopilación. Establece las categorías de empresas, los países, las ciudades u otros límites geográficos antes de iniciar la recopilación.
Recopila un registro por cada lugar. Conserva el ID del lugar, la dirección, el nombre, la categoría, la página web, el teléfono y las coordenadas.
Elimina los registros de lugares que se repiten. Elimina las exportaciones repetidas de la misma ubicación sin eliminar las ramificaciones legítimas de la cadena.
Añadir la clasificación por cadenas. Aplica «Chain Info» u otro método de clasificación definido.
Normaliza los campos para poder compararlos. Estandariza los nombres de las empresas, los dominios, el formato de los números de teléfono, las categorías y las direcciones cuando sea necesario.
Crea campos de agrupación a nivel de marca. Mantén estos datos separados de los datos de ubicación originales.
Marcar los registros dudosos. Deriva los resultados contradictorios o incompletos a revisión manual, en lugar de forzar una clasificación.
Conservar las columnas de pruebas. Conserva suficientes campos de origen para poder explicar más adelante por qué se agrupó o se rechazó un registro.
La salida podría contener campos como:
| place_id | name | category | sitio web | estado_de_la_cadena | marca_normalizada | estado_de_la_revisión |
|---|---|---|---|---|---|---|
| ID-A | Marca A en el centro de la ciudad | Restaurante | marca-a.ejemplo | Verdadero | Marca A | Confirmado |
| ID-B | Marca A Norte | Restaurante | marca-a.ejemplo | Verdadero | Marca A | Confirmado |
| ID-C | Servicios de la marca A | Consultor | diferente.ejemplo | Falso/Reseña | — | Revisión manual |
El esquema exacto puede variar, pero el principio no debería cambiar:
Nunca se deben sobrescribir los datos subyacentes a nivel de lugar simplemente para facilitar la agrupación.
Si la fase de recopilación de datos sigue realizándose de forma manual, estandariza ese proceso antes de incorporar la clasificación en cadena. Unas entradas coherentes facilitan considerablemente la justificación de las etapas posteriores de agrupación y control de calidad.
Realiza un control de calidad del conjunto de datos antes de utilizar la clasificación
Un proceso de clasificación debe someterse a pruebas antes de que sus resultados se consideren fiables.
Empieza con una muestra, en lugar de fiarte inmediatamente de todos los registros de una exportación de gran volumen.
Revisa los ejemplos de varios grupos:
Cadenas evidentes. Comprueba si las marcas con presencia en varias ubicaciones se están clasificando de forma coherente.
Empresas independientes. Asegúrate de que las empresas locales con nombres similares no se agrupen simplemente porque sus nombres se parezcan entre sí.
Marcas secundarias y departamentos. Busca diferencias legítimas en la denominación o en las categorías que puedan dividir una familia de marcas más amplia.
Registros con datos que faltan. Revisa los registros que no tengan página web, número de teléfono, categoría u otros campos de validación importantes.
Señales contradictorias. Señaliza los casos en los que los patrones de «Chain Info», el nombre de la empresa, el dominio, la categoría y la ubicación no coincidan.
Documenta la regla utilizada para cada campo final. Si el conjunto de datos contiene un marca_normalizada columna, define qué pruebas se requieren antes de rellenarla. Si hay un campo de confianza o de estado de revisión, define qué hace que un registro pase de la clasificación automática a la revisión manual.
También es útil conservar la fecha de recopilación. La información de Google Maps y del perfil de empresa cambia, y Google señala que los propios identificadores de lugar pueden cambiar con el tiempo.
El objetivo no es encasillar todos los discos en un grupo de marcas.
El objetivo es generar un conjunto de datos en el que se puedan explicar las clasificaciones.
Un conjunto de datos final sólido podría distinguir entre:
Clasificación confirmada — las señales coinciden.
Clasificación probable — Las pruebas apuntan claramente a esa relación, pero falta un aspecto importante.
Revisión manual — las pruebas son contradictorias o siguen siendo incompletas.
Sin clasificar — pruebas insuficientes.
Eso resulta más útil que dar por hecho que todos los registros tienen el mismo grado de certeza.
La identificación de cadenas a gran escala funciona mejor cuando la identidad de la ubicación, el estado de la cadena, la agrupación por marcas y la titularidad se tratan como capas independientes. Outscraper puede proporcionar registros estructurados de Google Maps y un enriquecimiento documentado de la información sobre la cadena, mientras que la lógica de agrupación final debe reflejar el nivel de evidencia disponible, en lugar de formular afirmaciones que los datos de origen no puedan respaldar.
Preguntas frecuentes
Preguntas y respuestas más frecuentes
Una cadena comercial es, por lo general, una empresa que opera bajo una marca común en múltiples establecimientos. En un conjunto de datos de Google Maps, cada sucursal debe conservarse como un registro de ubicación independiente. El estado de «cadena» añade una clasificación de nivel superior; no sustituye a los datos de ubicación subyacentes.
No. La coincidencia de nombres de empresas puede resultar útil, pero los nombres por sí solos no son lo suficientemente fiables para clasificar las cadenas. Empresas que no guardan relación entre sí pueden compartir nombres similares, mientras que los establecimientos legítimos de una cadena pueden utilizar formatos de denominación distintos. Combina los datos de los nombres con categorías, páginas web, datos de contacto, ubicaciones, identificadores e indicadores de clasificación de cadenas.
El enriquecimiento de la información sobre cadenas documentado por No. Outscraper indica, mediante un valor verdadero/falso, si una empresa se identifica como parte de una cadena. Esto por sí solo no determina cuál es la empresa matriz, el franquiciado, la propiedad corporativa, la entidad jurídica, ni si un establecimiento concreto es propiedad de la empresa o es una franquicia.
No. Si los registros corresponden a ubicaciones físicas distintas, normalmente deben seguir siendo registros independientes. La deduplicación debe eliminar los registros repetidos correspondientes a un mismo lugar, no las sucursales legítimas de la misma cadena. La agrupación por cadena o marca debe almacenarse como una capa de clasificación adicional.
Utiliza las opciones de eliminación de duplicados cuando estén disponibles, sobre todo al combinar varias búsquedas geográficas. Verifica el conjunto de datos final antes de enriquecerlo o importarlo a otro sistema.
No hay ningún límite máximo: Outscraper está diseñado para adaptarse a cualquier escala. Puedes recopilar todas las reseñas de una única ficha de empresa o ejecutar tareas masivas en cientos de ubicaciones a la vez. Los equipos que realizan análisis de opinión suelen recopilar decenas de miles de reseñas de sectores enteros. La plataforma se encarga del trabajo pesado en la nube, por lo que no es necesario que tu ordenador permanezca encendido mientras se ejecuta la tarea.
Empieza con registros de ubicación limpios, conserva los campos necesarios para la validación y añade la clasificación en cadena solo una vez que quede clara la unidad de análisis.