Índice
Copiar unas cuantas filas de una página web a una hoja de cálculo es fácil. Cuando esa misma tarea implica cientos o miles de páginas, un herramienta de extracción de datos puede recopilar los campos necesarios y convertirlos en registros estructurados mucho más rápido.
Esos datos pueden incluir detalles de productos, fichas de empresas, opiniones, información de contacto, tablas o enlaces. El problema es que no todos los sitios web presentan o cargan la información de la misma manera, por lo que un método de extracción que funcione en un sitio puede que no funcione igual de bien en otro.
En el caso de los equipos que recopilan datos de sitios web de forma habitual, la extracción también debe generar registros coherentes y útiles sin que ello suponga una labor innecesaria de limpieza o mantenimiento.
Para elegir el enfoque adecuado, lo primero es comprender qué datos necesitas, dónde se encuentran y cómo los presenta la página web. Si quieres tener una visión más amplia de cómo encaja la extracción en los flujos de trabajo empresariales, consulta nuestra guía sobre Herramientas de extracción de datos y casos de uso.
Respuesta rápida: ¿Cómo se extraen datos de una página web?
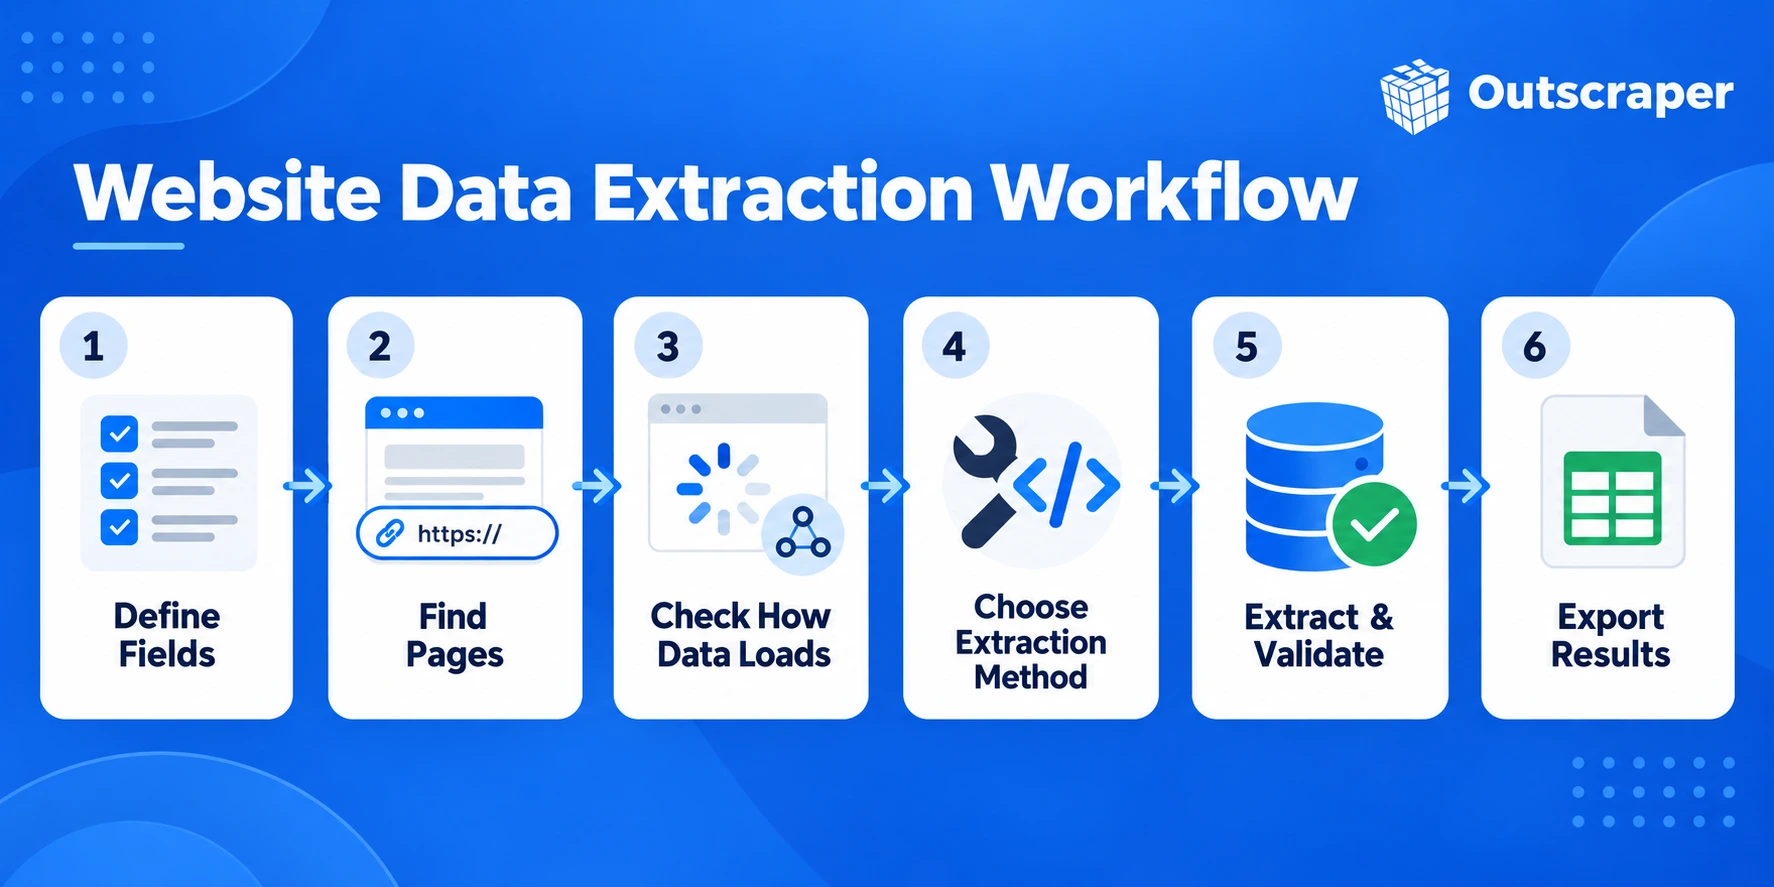
- Define los datos que necesitas.
- Busca las páginas que lo contengan.
- Comprueba cómo se carga el contenido de la página web.
- Elige un método de extracción.
- Prueba con una pequeña muestra.
- Extraer y validar los datos.
- Exporta los resultados en un formato que se pueda utilizar.
El mejor método depende de la estructura del sitio web, la cantidad de datos, la frecuencia con la que cambian y el nivel de mantenimiento que quieras asumir.
Watch: How a Data Scraper Turns Website Pages Into Structured Data
This short walkthrough shows the website data extraction process, from choosing the fields and pages to testing the scraper, checking the records, and exporting the results.
The right extraction method depends on the website, the fields you need, and how the pages load. Start by identifying the type of data you want to collect and how it appears on the page.
Outscraper’s Raspador web universal basado en inteligencia artificial extrae campos seleccionados de las URL de las páginas web sin que tengas que ocuparte de la configuración del scraping.
Cómo extraer datos de una página web paso a paso
La extracción de datos de sitios web resulta más fácil de gestionar si primero se define el resultado deseado y, después, se elige la herramienta. Céntrate en los campos que necesitas, en dónde aparecen en la página y en si el método de extracción puede recopilarlos de forma coherente.
Mira: Extrae información de cualquier página web y conviértela en datos limpios
1. Define los campos de datos que necesitas
Empieza teniendo en cuenta el conjunto de datos final.
En el caso de una página web dedicada a un producto, esto podría incluir:
- nombre del producto
- precio
- rating
- disponibilidad
- URL del producto
Para crear un directorio de empresas, es posible que necesites:
- razón social
- category
- número de teléfono
- sitio web
- dirección
Mantener la lista de campos específica evita extracciones innecesarias y facilita la comprobación de si el resultado final está completo.
2. Identifica las páginas o las URL
A continuación, busca las páginas que contengan la información.
Los datos pueden aparecer en:
- páginas de anuncios
- páginas de productos
- páginas de perfil
- páginas de categorías
- resultados de la búsqueda
- tablas
- secciones paginadas
Algunos trabajos solo requieren datos de un tipo de página. Otros necesitan primero información de una página de listado, seguida de páginas de detalles individuales.
3. Comprueba cómo carga los datos la página web
Fíjate en si la información aparece inmediatamente al cargarse la página o solo tras realizar una acción.
Algunas páginas muestran el contenido directamente en el código HTML. Otras pueden cargar registros mediante JavaScript y solicitudes de red asíncronas, así como la paginación, los filtros o el desplazamiento infinito.
Esto significa que parte de la información puede aparecer una vez que se ha cargado la página inicial, por lo que un rastreador que solo lea el código HTML original podría pasársela por alto.
4. Elegir y probar un método de extracción
Elige un método en función de la estructura del sitio web y de la cantidad de datos que necesites.
Las opciones pueden incluir:
- extracción visual o sin código
- Extracción de datos basada en selectores HTML o CSS
- scripts personalizados
- API
- Extracción asistida por IA
Antes de ejecutar el proceso en cientos o miles de páginas, prueba primero con una pequeña muestra. Comprueba si los campos esperados aparecen correctamente y si el mismo método funciona en diferentes páginas.
5. Extraer y validar los datos
Una vez que la prueba funcione, ejecuta la extracción en las páginas necesarias.
No des por sentado que los resultados son correctos solo porque el proceso haya finalizado. Comprueba lo siguiente:
- valores que faltan
- registros duplicados
- campos incorrectos
- formatos inconsistentes
- páginas que no devolvieron ningún dato
La validación es especialmente importante cuando las páginas no siguen todas el mismo diseño.
6. Exportar y preparar los resultados
Guarda los registros en un formato adecuado para el siguiente paso.
Entre las opciones más habituales se encuentran CSV, Excel y JSON. Dependiendo del flujo de trabajo, es posible que los datos resultantes aún necesiten una limpieza, una deduplicación o un formateo antes de estar listos para su análisis o para su uso en otro sistema.
¿Qué datos puede extraer un rastreador de datos de una página web?
El tipo de datos que se pueden recopilar depende de la información que la página web ponga a disposición en sus páginas. En la mayoría de los casos, un rastreador se configura para capturar campos específicos en lugar de copiar la página completa.
Listas y directorios
Los directorios suelen contener registros repetidos con el mismo conjunto de campos.
Plataformas como mapas de Google y la Páginas Amarillas Son ejemplos habituales de fuentes tipo directorio en las que se pueden recopilar nombres de empresas, categorías, direcciones, números de teléfono, sitios web y datos de ubicación en forma de registros estructurados.
Entre los ejemplos típicos se incluyen:
- razones sociales
- categorías
- direcciones
- números de teléfono
- enlaces a sitios web
- detalles de la ubicación
Estas páginas suelen ser más fáciles de estructurar, ya que los mismos campos aparecen en muchos anuncios.
Información sobre el producto y el anuncio
Las páginas de productos y los mercados pueden incluir campos como:
- nombre del producto
- precio
- description
- rating
- disponibilidad
- Información sobre el vendedor
- URL del producto
Parte de esta información puede aparecer en las páginas de listados, mientras que otros detalles solo están disponibles en la página de cada producto.
Como ejemplo concreto de una fuente, el de Outscraper… El Scraping de productos Amazon puede recopilar datos estructurados sobre productos y fichas de producto de las páginas de Amazon.
Tablas y registros estructurados
Los sitios web suelen publicar información en tablas, cuadros comparativos, calendarios u otros diseños recurrentes.
Un rastreador puede recopilar los valores de cada fila o columna y convertirlos en registros que resulten más fáciles de ordenar, filtrar o analizar.
Opiniones y valoraciones
Las páginas de reseñas pueden incluir:
- texto de la reseña
- rating
- fecha de revisión
- nombre del revisor
- texto de respuesta
- otros detalles visibles de la reseña
Outscraper's El Scraping de reseñas de Google Maps puede proporcionar datos estructurados sobre reseñas para el seguimiento de la reputación, el análisis de las opiniones de los clientes y el estudio de la competencia.
Los campos disponibles varían según el sitio web, por lo que la configuración de la extracción debe ajustarse a la estructura de la página de reseñas.

Utiliza Outscraper’s El Scraping de reseñas de Google Maps para recopilar datos de opiniones de clientes sobre las empresas que estás investigando.
Contacto para el público e información sobre la empresa
Las páginas web de las empresas, los directorios y las páginas de perfil pueden mostrar:
- razones sociales
- direcciones
- números de teléfono
- direcciones de correo electrónico
- URL de sitios web
- enlaces a redes sociales
- otros datos sobre la sociedad anónima
No todas las páginas contienen todos los campos, por lo que es de esperar que haya valores que falten al trabajar con conjuntos de datos más grandes.
Cuando lo que más te interesa son los datos de contacto, la solución de Outscraper El Scraping de correos electrónicos y contactos puede recopilar direcciones de correo electrónico, números de teléfono y perfiles en redes sociales de acceso público de sitios web.

Outscraper Ofrece herramientas de extracción de datos para fichas de empresas, opiniones, productos, directorios y datos de contacto públicos.
Por qué algunos sitios web son más difíciles de extraer que otros
Dos páginas web pueden mostrar información similar, pero requerir métodos de extracción muy distintos. La dificultad suele radicar en cómo se carga el contenido de la página, cómo se distribuyen los registros por el sitio web y en qué medida la estructura de la página es coherente.
Contenido generado mediante JavaScript
Algunos sitios web no incluyen toda la información visible en el código HTML inicial. En su lugar, JavaScript carga parte de la página tras la primera solicitud.
Un sencillo rastreador puede recopilar la página, pero es posible que no detecte los campos que el usuario ve en el navegador. En estos casos, el método de extracción debe tener en cuenta el contenido que aparece una vez que se ha cargado la página.
Paginación y desplazamiento infinito
Una lista puede contener cientos de registros, pero solo un pequeño número aparece en la primera página.
La paginación divide esos registros entre varias URL o estados de página. El desplazamiento infinito carga más resultados a medida que el visitante se desplaza hacia abajo en la página.
En ambos casos, el rastreador debe seguir solicitando o cargando registros adicionales, en lugar de detenerse tras el primer conjunto visible.
Diferentes diseños de página
No todas las páginas de un mismo sitio web siguen la misma estructura.
Por ejemplo, algunas páginas de productos pueden incluir un campo de precio, otro de valoración y otro de disponibilidad, mientras que otras utilizan un diseño diferente u omiten por completo determinados campos.
Por lo tanto, es posible que las reglas de extracción que funcionan en una página tengan que adaptarse a varias variaciones.
Campos que faltan o que no coinciden
Es poco habitual que los registros de un sitio web estén completos en todas las páginas.
Es posible que en el perfil de una empresa aparezca un número de teléfono, pero no una dirección de correo electrónico. Puede que un producto tenga una valoración, mientras que otro aún no tenga opiniones.
El rastreador debe conservar el registro incluso cuando falten algunos campos esperados.
Modificación de las estructuras de los sitios web
Las páginas web se van actualizando con el tiempo. El rediseño de una página, el cambio de nombre de un elemento o una modificación en el comportamiento de carga pueden hacer que deje de funcionar una configuración de extracción que antes funcionaba correctamente.
Esta es una de las razones por las que la extracción periódica de contenidos de una página web suele requerir más mantenimiento que un trabajo puntual. Cuantas más páginas y tipos de páginas haya, más importante resulta comprobar que los resultados sigan siendo coherentes.
Formas de extraer datos estructurados de una página web
No existe un único método de extracción que se adapte a todas las páginas web. El enfoque adecuado depende de cómo esté estructurada la página, de la cantidad de datos que necesites y de si el proceso se va a ejecutar una sola vez o de forma repetida.
Extracción visual y sin código
Los extractores visuales permiten a los usuarios seleccionar los campos que desean directamente desde una página web sin necesidad de escribir código.
Esto funciona bien para páginas más sencillas con diseños repetitivos, como directorios, listados de productos o tablas. También resulta útil cuando la tarea de extracción es pequeña o cuando un usuario sin conocimientos técnicos necesita configurar el flujo de trabajo.
Extracción de selectores HTML y CSS
Muchos rastreadores identifican los elementos de una página a través de la estructura HTML, Selectores CSS, o normas similares.
Este enfoque permite un mayor control sobre los campos que se recogen y funciona bien cuando las páginas de destino siguen un diseño coherente.
Su principal inconveniente es el mantenimiento. Si la página web cambia su estructura, es posible que haya que actualizar los selectores.
Código personalizado
Los desarrolladores pueden crear su propia lógica de extracción utilizando lenguajes como Python o JavaScript.
El código personalizado resulta útil cuando la página web presenta un comportamiento inusual, los datos requieren un tratamiento especial o la extracción debe estar estrechamente vinculada a otro sistema.
La contrapartida es que el equipo también asume la responsabilidad de las pruebas, el mantenimiento, la gestión de errores y los cambios en la página web.
API
Algunos flujos de trabajo pueden recopilar datos de sitios web a través de una API, en lugar de gestionar directamente la lógica de extracción.
Una API puede resultar útil cuando es necesario alimentar con datos una aplicación, una base de datos o un flujo de trabajo recurrente. Los desarrolladores que utilicen Outscraper pueden consultar la Documentación de la API de Universal Scraper para consultar los parámetros disponibles, las respuestas y los ejemplos de solicitudes.
En cuanto a los datos empresariales basados en la ubicación, Outscraper ofrece API de Places de Google Maps Se puede utilizar para solicitar información estructurada sobre lugares y empresas para aplicaciones, bases de datos o flujos de trabajo recurrentes.
Los campos disponibles, los límites y el comportamiento dependen de la API que se utilice.
Extracción asistida por IA
La extracción asistida por IA permite identificar campos en función de la información que solicita el usuario, en lugar de basarse únicamente en selectores fijos.
Esto puede resultar útil cuando las páginas tienen diseños menos uniformes o cuando definir cada regla de extracción manualmente llevaría demasiado tiempo.
La Guía de Universal AI Scraper muestra cómo Outscraper aplica este enfoque para extraer campos seleccionados de las URL de sitios web.
Aún hay que someterla a pruebas. Antes de utilizar la extracción basada en IA a gran escala, hay que comprobar que no haya campos que falten, valores incorrectos ni resultados incoherentes.
Ejemplos de extracción de datos de sitios web asistida por IA
La extracción asistida por IA puede utilizarse para diferentes tipos de páginas, en función de la información disponible en el sitio web.
Ejemplo de directorio de empresas
En el caso de un directorio de empresas, podrías solicitar campos como el nombre de la empresa, la página web, el número de teléfono, la categoría y la dirección.
Ejemplo de página de producto
En el caso de las páginas de productos, los campos obligatorios podrían incluir el nombre del producto, el precio, la disponibilidad, la valoración y la URL del producto.
Ejemplo de artículo o anuncio
En el caso de las páginas de contenido o de listados, puedes extraer campos como el título, el autor, la fecha de publicación, la categoría y la URL de la página.
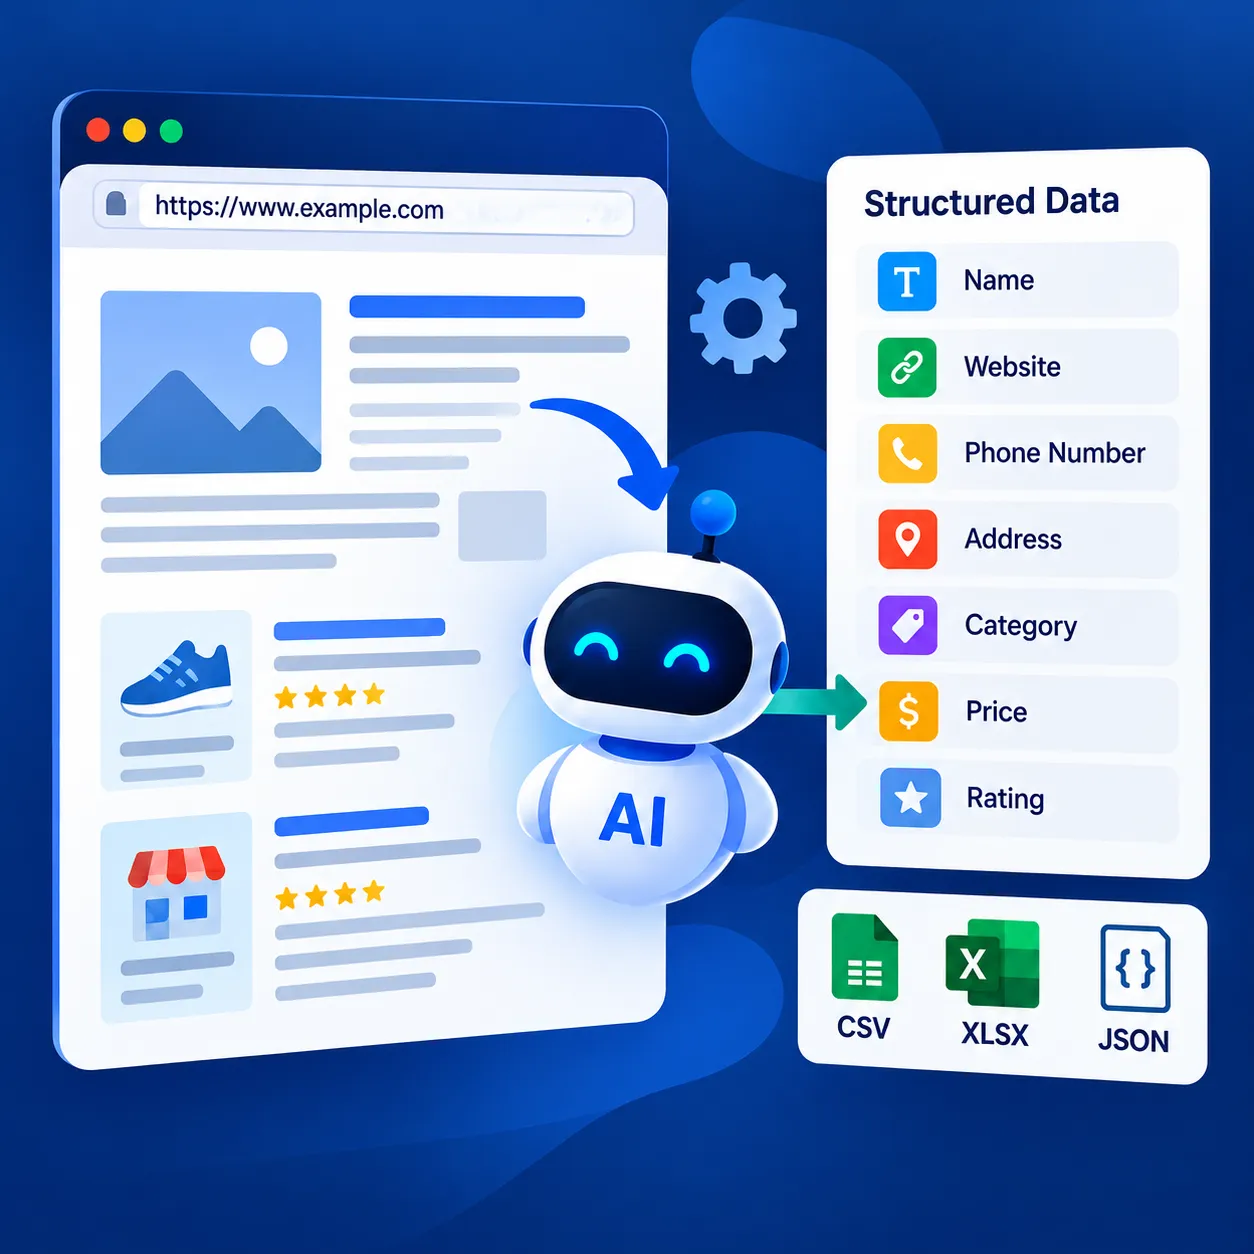
Utiliza Outscraper’s Raspador web universal basado en inteligencia artificial para recopilar los campos que necesitas de las páginas web y devolverlos como datos estructurados.
Cómo elegir el método adecuado para la extracción de datos de una página web
El mejor método de extracción depende del sitio web, de la cantidad de datos en cuestión y de la frecuencia con la que deba ejecutarse el proceso. Una página sencilla puede que solo necesite un rastreador visual, mientras que un trabajo de gran envergadura o recurrente puede requerir código, una API o un servicio de extracción gestionado.

Adapta el método al sitio web
Empieza por la forma en que la página web presenta sus datos.
Una página con un diseño estable y campos que se repiten puede funcionar bien con selectores o con un extractor sin código. Un sitio web que dependa en gran medida de JavaScript, de la carga dinámica o de diseños cambiantes puede requerir un enfoque más flexible.
Cuanto más complejo sea el comportamiento de la página, más importante resulta probar el método antes de ampliar la extracción.
Ten en cuenta la escala, la frecuencia y el mantenimiento
Un método que funciona para 20 páginas puede que no sea la mejor opción para 20.000.
En el caso de una extracción puntual, la configuración manual puede ser una opción válida. Sin embargo, cuando se trata de una recopilación periódica, el mantenimiento cobra mayor importancia a la hora de tomar la decisión.
Piensa en lo siguiente:
- ¿Cuántas páginas hay que procesar?
- con qué frecuencia hay que actualizar los datos
- si la estructura de la página cambia con frecuencia
- cuánto control requiere el flujo de trabajo
- si tu equipo puede mantener la lógica de extracción personalizada
Cuanto más grande y frecuente sea el trabajo, más importante resulta reducir las comprobaciones manuales y las configuraciones repetidas.
Comprueba los requisitos de salida y de uso de datos
El método de extracción también debe adaptarse a lo que ocurre una vez recopilados los datos.
Si es necesario transferir los resultados a una hoja de cálculo, una base de datos, una aplicación o un flujo de trabajo automatizado, comprueba si el método admite el formato y la estructura de salida requeridos.
También es importante revisar las normas de acceso al sitio web, el tipo de información que se recopila y los requisitos que se aplican al uso que se hará de los datos.
Al extraer datos de un sitio web, comprueba también si la información es de acceso público, si el sitio tiene condiciones de uso o restricciones de acceso que se apliquen, y si existen normas de privacidad o de protección de datos que afecten a la forma en que se puede almacenar o utilizar la información recopilada. Los requisitos pueden variar en función del sitio web, el tipo de datos, el uso previsto y la jurisdicción.
Un buen método de extracción debe adaptarse tanto al sitio web como al flujo de trabajo posterior.
El papel de Outscraper en el flujo de trabajo de extracción de datos de un sitio web
Crear tu propio rastreador te da control, pero también implica que tendrás que encargarte tú mismo de las pruebas, el mantenimiento, los cambios en las páginas y los trabajos de extracción fallidos.
Equipos que comparan el el mejor programa de extracción de datos A la hora de elegir un proyecto, hay que tener en cuenta la fuente de datos, los campos obligatorios, la escala, la frecuencia de actualización y la cantidad de infraestructura de extracción de datos que se desea mantener.
Outscraper ofrece herramientas de extracción de datos y API para recopilar datos públicos estructurados de sitios web y directorios en línea, incluyendo opciones específicas para cada fuente en plataformas como Google Maps, Google Maps Reviews, Amazon, Trustpilot y Yellow Pages.
Para una extracción más amplia de contenidos de sitios web, Outscraper ofrece Raspador web universal basado en inteligencia artificial Se puede utilizar cuando se necesitan datos estructurados sin tener que gestionar internamente toda la configuración de extracción de datos.
Si tu proyecto de extracción de datos de una página web incluye campos definidos y varias páginas, el «Universal AI-Powered Web Scraper» de Outscraper puede ser una opción a tener en cuenta.
Cómo extrae datos un rastreador de datos de una página web
A herramienta de extracción de datos Funciona leyendo una página web, localizando la información que se le ha indicado que recopile y convirtiendo esos valores en registros estructurados.
Cargando la página
En primer lugar, el rastreador necesita tener acceso al contenido de la página web.
En el caso de las páginas web más sencillas, es posible que la información necesaria ya figure en el código HTML devuelto por el servidor. Otras páginas cargan parte del contenido más tarde mediante JavaScript o solicitudes adicionales.
La forma en que se carga la página influye en lo que el rastreador puede ver y en el momento en que los datos están disponibles.
Cómo encontrar los elementos adecuados de la página
Una vez que la página esté disponible, el rastreador debe identificar los elementos que contienen los campos necesarios.
Entre ellos podrían figurar:
- título de un producto
- un precio
- un nombre comercial
- una valoración de una reseña
- un número de teléfono
- un enlace
- una fila de la tabla
Dependiendo del método, esos campos pueden identificarse mediante selectores, la estructura de la página, reglas de extracción o instrucciones asistidas por IA.
Extracción de los valores
A continuación, el rastreador recoge los valores de esos elementos.
Por ejemplo, una página de producto podría mostrar:
- Nombre del producto: Producto de ejemplo
- precio: $49
- valoración: 4,6
- Disponibilidad: En stock
Las mismas reglas de extracción pueden aplicarse a páginas similares siempre que la estructura se mantenga coherente.
Convertir los resultados en registros estructurados
El contenido sin procesar de una página web no resulta muy útil por sí solo. Los valores extraídos deben organizarse en campos coherentes para que cada registro siga la misma estructura.
En el caso de una página de producto, el resultado podría tener este aspecto:
| Nombre del producto | Precio | Clasificación | Disponibilidad | URL del producto |
|---|---|---|---|---|
| Ejemplo de producto A | $49 | 4.6 | En stock | example.com/product-a |
| Ejemplo de producto B | $72 | 4.3 | Agotado | example.com/product-b |
| Ejemplo de producto C | $35 | 4.8 | En stock | example.com/product-c |
Una vez estructurados los campos, los registros se pueden exportar, analizar, almacenar en una base de datos o transferir a otro flujo de trabajo.
La fiabilidad del conjunto de datos final depende de la coherencia con la que el rastreador pueda encontrar los mismos campos en todas las páginas de destino.
Lista de comprobación final antes de extraer datos de una página web
- Define los campos que necesites.
- Busca las páginas o las URL adecuadas.
- Comprueba cómo carga los datos la página web.
- Elige el método de extracción.
- Prueba con una pequeña muestra.
- Valida los registros.
- Confirma el formato de salida y los requisitos de uso de los datos.
¿Necesitas un herramienta de extracción de datos ¿Para tu proyecto de extracción de datos de sitios web? Outscraper te ayuda a recopilar datos públicos estructurados de sitios web, directorios, listados y reseñas sin que tengas que gestionar tú mismo toda la configuración del scraping.
Preguntas más frecuentes
Preguntas y respuestas más frecuentes
Un programa de extracción de datos de sitios web recopila información específica de las páginas web y la convierte en registros estructurados. Dependiendo de la página, dicha información puede incluir texto, precios, enlaces, opiniones, datos de contacto, tablas, listados u otros campos visibles.
Sí. Las herramientas de scraping visuales y sin código permiten a los usuarios seleccionar campos de una página web sin necesidad de escribir un script. Estos métodos funcionan mejor cuando las páginas de destino siguen una estructura clara y repetitiva.
Sí. Un rastreador puede recorrer varias URL, páginas de listado, paginación o páginas de detalles enlazadas. La configuración debe tener en cuenta cómo organiza y carga el sitio web esas páginas.
El «web scraping» recopila información de páginas web, mientras que una API proporciona datos estructurados a través de una interfaz definida. Las API suelen ser más fáciles de integrar en las aplicaciones, pero los campos disponibles dependen de lo que exponga el proveedor.
Sí, siempre que la herramienta de extracción sea compatible con esos formatos. Los formatos CSV y Excel son opciones habituales cuando es necesario revisar, filtrar, depurar o compartir los datos en una hoja de cálculo.
Pueden producirse datos faltantes cuando el contenido se carga mediante JavaScript, faltan campos en algunas páginas, los diseños varían o el sitio web cambia de estructura. Probar varias páginas antes de realizar una extracción a mayor escala puede ayudar a identificar estos problemas a tiempo.