Índice
Copiar algumas linhas de um site para uma planilha é fácil. Quando a mesma tarefa envolve centenas ou milhares de páginas, um extrator de dados pode coletar os campos necessários e transformá-los em registros estruturados com muito mais rapidez.
Esses dados podem incluir detalhes de produtos, fichas de empresas, avaliações, informações de contato, tabelas ou links. O desafio é que nem todos os sites apresentam ou carregam as informações da mesma maneira; portanto, um método de extração que funcione em um site pode não funcionar tão bem em outro.
Para equipes que coletam dados de sites regularmente, a extração também precisa gerar registros consistentes e úteis, sem exigir trabalho desnecessário de limpeza ou manutenção.
A escolha da abordagem correta começa com a compreensão de quais dados você precisa, onde eles aparecem e como o site os apresenta. Para uma visão mais ampla de como a extração se encaixa nos fluxos de trabalho da empresa, consulte nosso guia sobre ferramentas de extração de dados e casos de uso.
Resposta rápida: Como extrair dados de um site?
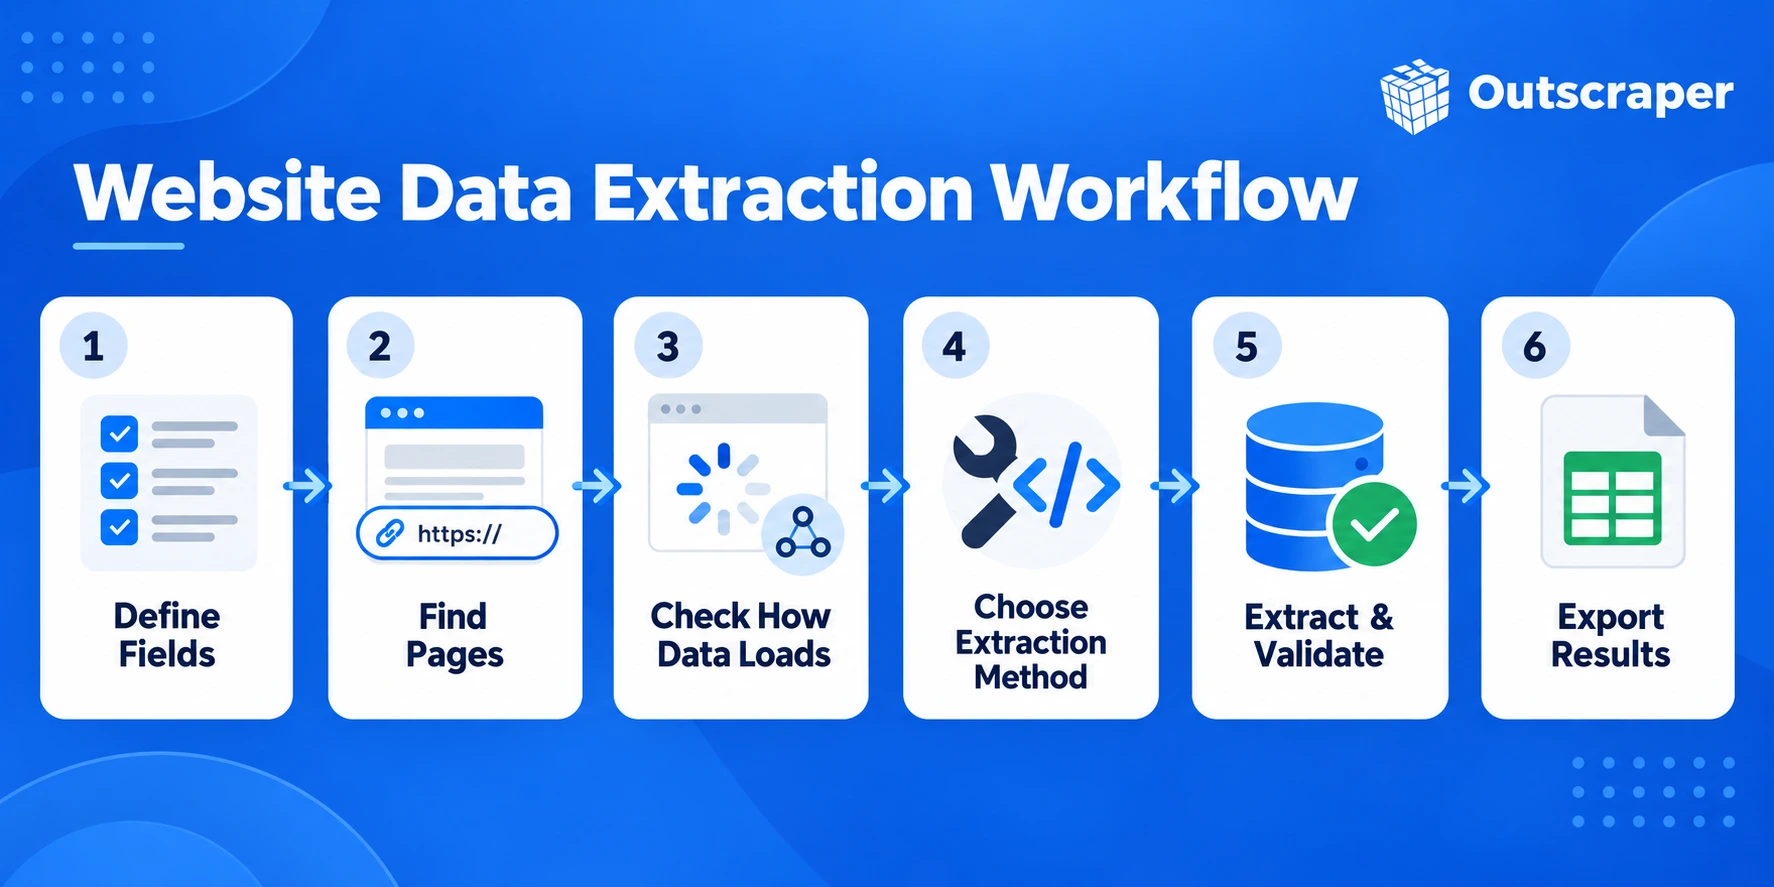
- Defina os dados de que você precisa.
- Encontre as páginas que contêm isso.
- Verifique como o site carrega o conteúdo.
- Escolha um método de extração.
- Teste uma pequena amostra.
- Extraia e valide os dados.
- Exporte os resultados em um formato prático.
O melhor método depende da estrutura do site, da quantidade de dados, da frequência com que eles são atualizados e do nível de manutenção que você deseja realizar.
Outscraper's Raspador da Web universal com inteligência artificial extraia campos selecionados de URLs de sites sem que você precise manter a configuração de extração.
Como extrair dados de um site, passo a passo
A extração de dados de sites é mais fácil de gerenciar quando você define primeiro o resultado desejado e, em seguida, escolhe a ferramenta. Concentre-se nos campos de que precisa, onde eles aparecem na página e se o método de extração é capaz de coletá-los de maneira consistente.
Watch: Scrape Any Website into Clean Data
1. Defina os campos de dados de que você precisa
Comece tendo em mente o conjunto de dados final.
No caso de um site de produtos, isso pode incluir:
- nome do produto
- preço
- rating
- disponibilidade
- URL do produto
Para um diretório de empresas, você pode precisar de:
- nome da empresa
- category
- número de telefone
- site
- endereço
Manter a lista de campos específica evita extrações desnecessárias e facilita a verificação se o resultado final está completo.
2. Identifique as páginas ou URLs
Em seguida, encontre as páginas que contêm essas informações.
Os dados podem aparecer em:
- páginas de listagem
- páginas de produtos
- páginas de perfil
- páginas de categorias
- resultados da pesquisa
- tabelas
- seções paginadas
Algumas tarefas exigem apenas dados de um tipo de página. Outras precisam, primeiro, de informações de uma página de lista, seguidas por páginas de detalhes individuais.
3. Verifique como o site carrega os dados
Verifique se as informações aparecem imediatamente assim que a página é carregada ou somente após uma ação.
Algumas páginas exibem o conteúdo diretamente no HTML. Outras podem carregar registros por meio de JavaScript e solicitações de rede assíncronas, bem como paginação, filtros ou rolagem infinita.
Isso significa que algumas informações podem aparecer depois que a página inicial for carregada; portanto, um scraper que leia apenas o HTML original pode deixá-las de fora.
4. Escolha e teste um método de extração
Escolha um método com base na estrutura do site e na quantidade de dados de que você precisa.
As opções podem incluir:
- extração visual ou sem código
- Extracção de dados com base em seletores HTML ou CSS
- scripts personalizados
- APIs
- Extração assistida por IA
Antes de executar o processo em centenas ou milhares de páginas, teste primeiro uma pequena amostra. Verifique se os campos esperados aparecem corretamente e se o mesmo método funciona em páginas diferentes.
5. Extrair e validar os dados
Assim que o teste funcionar, execute a extração nas páginas necessárias.
Não presuma que os resultados estão corretos só porque o processo foi concluído. Verifique se:
- valores ausentes
- registros duplicados
- campos incorretos
- formatos inconsistentes
- páginas que não retornaram dados
A validação é especialmente importante quando nem todas as páginas seguem o mesmo layout.
6. Exportar e preparar os resultados
Salve os registros em um formato adequado para a próxima etapa.
As opções mais comuns incluem CSV, Excel e JSON. Dependendo do fluxo de trabalho, os dados gerados podem ainda precisar de limpeza, remoção de duplicatas ou formatação antes de estarem prontos para análise ou para serem enviados a outro sistema.
Que tipos de dados um scraper pode extrair de um site?
O tipo de dados que você pode coletar depende do que o site disponibiliza em suas páginas. Na maioria dos casos, um scraper é configurado para capturar campos específicos, em vez de copiar a página inteira.
Listas e diretórios
Os diretórios costumam conter registros repetidos com o mesmo conjunto de campos.
Plataformas como Google Maps e Páginas Amarelas são exemplos comuns de fontes do tipo diretório, nas quais nomes de empresas, categorias, endereços, números de telefone, sites e detalhes de localização podem ser coletados como registros estruturados.
Entre os exemplos típicos estão:
- nomes comerciais
- categorias
- endereços
- números de telefone
- links para sites
- detalhes do local
Essas páginas costumam ser mais fáceis de estruturar, pois os mesmos campos aparecem em várias listagens.
Informações sobre o produto e a listagem
As páginas de produtos e os marketplaces podem conter campos como:
- nome do produto
- preço
- description
- rating
- disponibilidade
- informações sobre o vendedor
- URL do produto
Algumas dessas informações podem aparecer nas páginas de listagem, enquanto detalhes adicionais estão disponíveis apenas na página de cada produto.
Para um exemplo específico da fonte, o Outscraper’s Coletor de produtos Amazon pode coletar dados estruturados sobre produtos e listagens das páginas da Amazon.
Tabelas e registros estruturados
Os sites costumam publicar informações em tabelas, quadros comparativos, cronogramas ou outros layouts recorrentes.
Um scraper pode coletar os valores de cada linha ou coluna e convertê-los em registros mais fáceis de classificar, filtrar ou analisar.
Avaliações e classificações
As páginas de avaliação podem incluir:
- texto da resenha
- rating
- data de revisão
- nome do revisor
- texto da resposta
- outros detalhes visíveis da avaliação
Outscraper's Coletor de avaliações do Google Maps pode fornecer dados estruturados de avaliações para o monitoramento da reputação, a análise de feedback dos clientes e a pesquisa sobre a concorrência.
Os campos disponíveis variam de acordo com o site, portanto, a configuração da extração precisa corresponder à estrutura da página de avaliações.

Use o Outscraper’s Coletor de avaliações do Google Maps para coletar dados de avaliações de clientes sobre as empresas que você está pesquisando.
Contato com o público e informações sobre a empresa
Os sites das empresas, diretórios e páginas de perfil podem exibir:
- nomes comerciais
- endereços
- números de telefone
- endereços de e-mail
- URLs de sites
- links sociais
- outros detalhes sobre a empresa de capital aberto
Nem todas as páginas contêm todos os campos; portanto, é de se esperar que haja valores ausentes ao trabalhar com conjuntos de dados maiores.
Quando os dados de contato são os principais campos de que você precisa, o Outscraper’s Coletor de e-mails e contatos pode coletar e-mails, números de telefone e perfis em redes sociais de domínio público a partir de sites.

Outscraper oferece ferramentas de extração de dados para listagens de empresas, avaliações, produtos, diretórios e dados de contato públicos.
Por que alguns sites são mais difíceis de extrair do que outros
Dois sites podem apresentar informações semelhantes, mas exigir métodos de extração muito diferentes. A dificuldade geralmente decorre da forma como a página carrega o conteúdo, de como os registros estão distribuídos pelo site e do grau de consistência da estrutura da página.
Conteúdo gerado por JavaScript
Alguns sites não incluem todas as informações visíveis no código HTML inicial. Em vez disso, o JavaScript carrega parte da página após a primeira solicitação.
Um scraper simples pode coletar a página, mas ainda assim deixar de capturar os campos que o usuário vê no navegador. Nesses casos, o método de extração precisa levar em conta o conteúdo que aparece após o carregamento da página.
Paginação e rolagem infinita
Uma lista pode conter centenas de registros, mas apenas um pequeno número aparece na primeira página.
A paginação divide esses registros entre várias URLs ou estados de página. A rolagem infinita carrega mais resultados à medida que o visitante desce pela página.
Ambas exigem que o scraper continue solicitando ou carregando registros adicionais, em vez de parar após o primeiro conjunto visível.
Diferentes layouts de página
Nem todas as páginas de um mesmo site seguem a mesma estrutura.
Por exemplo, algumas páginas de produtos podem incluir campos de preço, avaliação e disponibilidade, enquanto outras utilizam um layout diferente ou omitem completamente certos campos.
As regras de extração que funcionam em uma página podem, portanto, precisar lidar com várias variações.
Campos ausentes ou inconsistentes
Os registros de sites raramente estão completos em todas as páginas.
Um perfil de empresa pode conter um número de telefone, mas não um endereço de e-mail. Um produto pode ter uma avaliação, enquanto outro ainda não tem avaliações.
O scraper precisa preservar o registro mesmo quando alguns campos esperados estiverem faltando.
Alterações nas estruturas dos sites
Os sites são atualizados ao longo do tempo. Uma página redesenhada, um elemento renomeado ou uma alteração no comportamento de carregamento podem comprometer uma configuração de extração que antes funcionava.
Essa é uma das razões pelas quais a extração recorrente de sites geralmente exige mais manutenção do que um trabalho pontual. Quanto mais páginas e tipos de páginas estiverem envolvidos, mais importante se torna verificar se os resultados permanecem consistentes.
Formas de extrair dados estruturados de um site
Não existe um método único de extração que sirva para todos os sites. A abordagem correta depende de como a página foi construída, da quantidade de dados necessária e se o processo será executado uma única vez ou repetidamente.
Extração visual e sem código
Os scrapers visuais permitem que os usuários selecionem os campos desejados diretamente de uma página da web, sem precisar escrever código.
Isso funciona bem para páginas mais simples com layouts repetidos, como diretórios, listas de produtos ou tabelas. Também é útil quando a tarefa de extração é pequena ou quando um usuário sem conhecimentos técnicos precisa configurar o fluxo de trabalho.
Extração de seletores HTML e CSS
Muitos scrapers identificam os elementos da página por meio da estrutura HTML, Seletores CSS, ou regras semelhantes.
Essa abordagem oferece maior controle sobre quais campos são coletados e funciona bem quando as páginas de destino seguem um layout consistente.
Sua principal desvantagem é a manutenção. Se o site alterar a estrutura das páginas, talvez seja necessário atualizar os seletores.
Código personalizado
Os desenvolvedores podem criar sua própria lógica de extração usando linguagens como Python ou JavaScript.
O código personalizado é útil quando o site apresenta um comportamento incomum, os dados exigem um processamento especial ou a extração precisa estar intimamente integrada a outro sistema.
A contrapartida é que a equipe também assume a responsabilidade pelos testes, pela manutenção, pelo tratamento de erros e pelas alterações no site.
APIs
Alguns fluxos de trabalho podem coletar dados de sites por meio de uma API, em vez de gerenciar diretamente a lógica de extração.
Uma API pode ser útil quando os dados precisam alimentar um aplicativo, um banco de dados ou um fluxo de trabalho recorrente. Os desenvolvedores que utilizam o Outscraper podem consultar o Documentação da API do Universal Scraper para conhecer os parâmetros disponíveis, as respostas e os exemplos de solicitações.
Para dados comerciais baseados em localização, a Outscraper’s API Places do Google Maps pode ser usado para solicitar informações estruturadas sobre locais e empresas para aplicativos, bancos de dados ou fluxos de trabalho recorrentes.
Os campos disponíveis, os limites e o comportamento dependem da API utilizada.
Extração assistida por IA
A extração assistida por IA pode identificar campos com base nas informações solicitadas pelo usuário, em vez de depender apenas de seletores fixos.
Isso pode ser útil quando as páginas têm layouts menos consistentes ou quando definir cada regra de extração manualmente levaria muito tempo.
As Guia do Universal AI Scraper mostra como a Outscraper aplica essa abordagem para extrair campos selecionados de URLs de sites.
Ainda é preciso testá-la. A extração baseada em IA deve ser verificada quanto à ausência de campos, valores incorretos e resultados inconsistentes antes de ser utilizada em grande escala.
Exemplos de extração de dados de sites com o auxílio da IA
A extração assistida por IA pode ser utilizada para diferentes tipos de páginas, dependendo das informações disponíveis no site.
Exemplo de diretório de empresas
Para um diretório de empresas, você pode solicitar campos como nome da empresa, site, número de telefone, categoria e endereço.
Exemplo de página de produto
Para as páginas de produtos, os campos solicitados podem incluir nome do produto, preço, disponibilidade, avaliação e URL do produto.
Exemplo de artigo ou anúncio
No caso de páginas de conteúdo ou de listagem, você pode extrair campos como título, autor, data de publicação, categoria e URL da página.
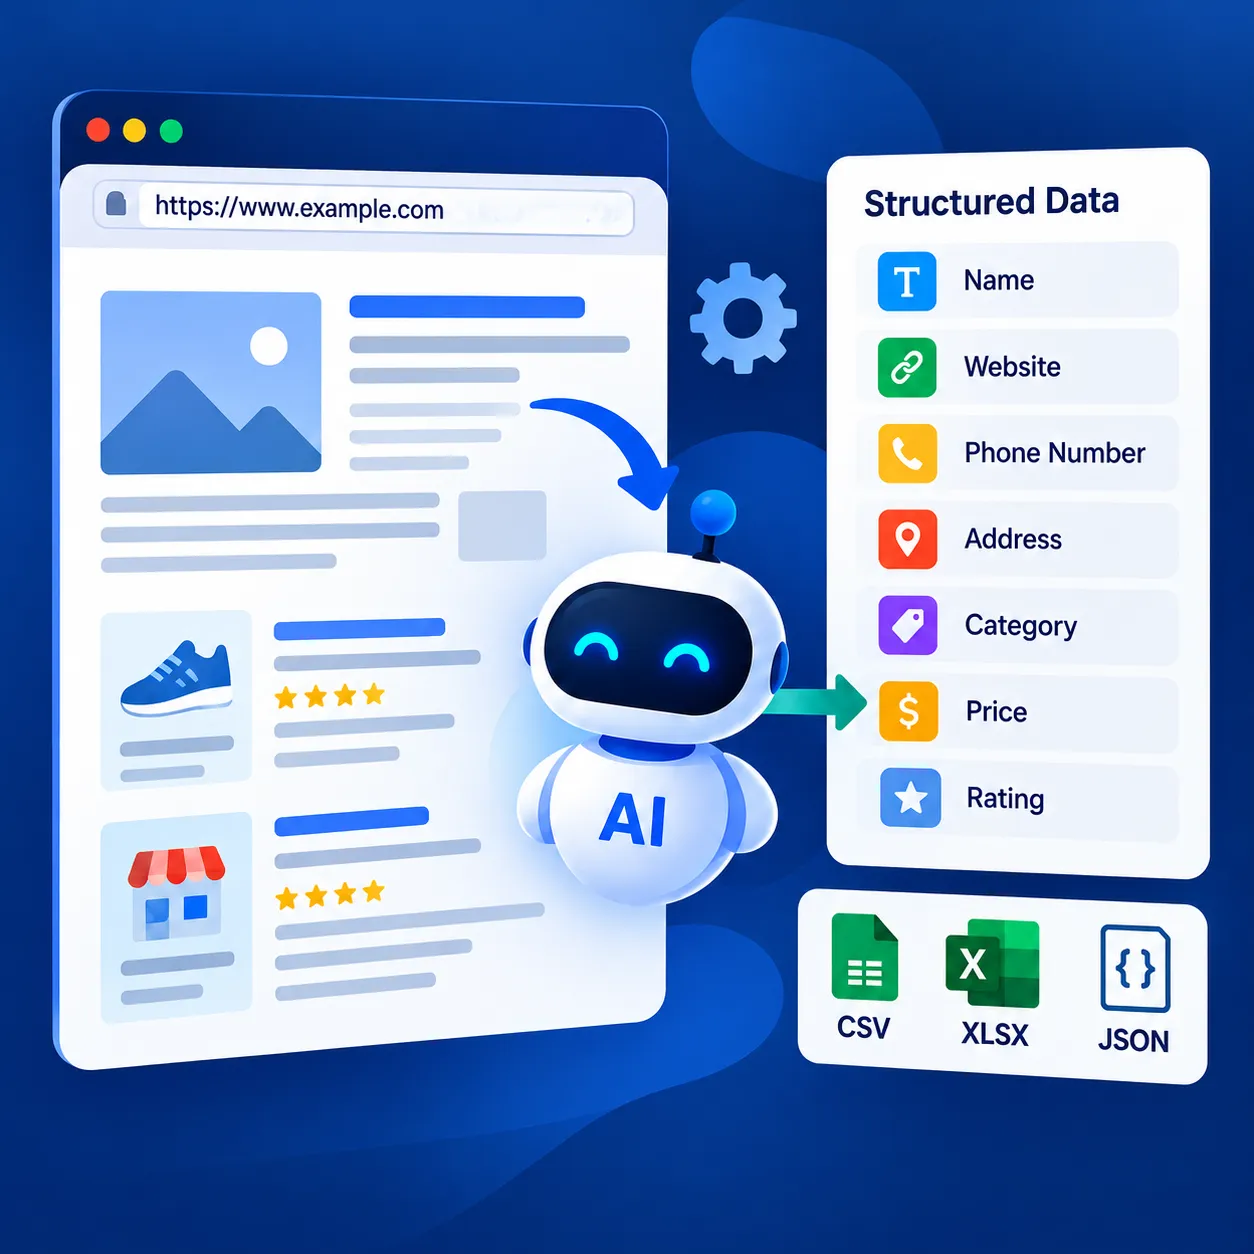
Use o Outscraper’s Raspador da Web universal com inteligência artificial para coletar os campos necessários das páginas do site e retorná-los como dados estruturados.
Como escolher o método certo de extração de dados de sites
O melhor método de extração depende do site, da quantidade de dados envolvidos e da frequência com que o processo precisa ser executado. Uma página simples pode precisar apenas de um scraper visual, enquanto uma tarefa de grande porte ou recorrente pode exigir código, uma API ou um serviço de extração gerenciado.

Adapte o método ao site
Comece analisando a forma como o site apresenta seus dados.
Uma página com layout estável e campos repetidos pode funcionar bem com seletores ou um scraper sem código. Um site que dependa fortemente de JavaScript, carregamento dinâmico ou layouts variáveis pode exigir uma abordagem mais flexível.
Quanto mais complexo for o comportamento da página, mais importante será testar o método antes de ampliar a extração.
Leve em consideração a escala, a frequência e a manutenção
Um método que funciona para 20 páginas pode não ser a melhor opção para 20.000.
Para uma extração única, a configuração manual pode ser aceitável. Para coletas recorrentes, a manutenção passa a ter um peso maior na decisão.
Considere o seguinte:
- quantas páginas precisam ser processadas
- com que frequência os dados precisam ser atualizados
- se a estrutura da página muda com frequência
- quanto monitoramento o fluxo de trabalho exige
- se sua equipe consegue manter uma lógica personalizada de extração de dados
Quanto maior e mais frequente for o trabalho, mais importante se torna reduzir as verificações manuais e as configurações repetitivas.
Verifique os requisitos de saída e de uso de dados
O método de extração também deve estar adequado ao que ocorre após a coleta dos dados.
Se for necessário transferir os resultados para uma planilha, banco de dados, aplicativo ou fluxo de trabalho automatizado, verifique se o método suporta a saída e a estrutura necessárias.
Também é importante verificar as regras de acesso ao site, o tipo de informação que está sendo coletada e os requisitos que se aplicam à forma como os dados serão utilizados.
Ao extrair dados de sites, verifique também se as informações são de acesso público, se o site possui termos ou restrições de acesso aplicáveis e se regras de privacidade ou proteção de dados afetam a forma como as informações coletadas podem ser armazenadas ou utilizadas. Os requisitos podem variar de acordo com o site, o tipo de dados, a finalidade de uso e a jurisdição.
Um bom método de extração deve ser adequado tanto ao site quanto ao fluxo de trabalho que se segue a ele.
O papel do Outscraper no fluxo de trabalho de extração de dados de um site
Criar seu próprio scraper lhe dá controle, mas também significa que você mesmo terá que lidar com testes, manutenção, alterações nas páginas e tarefas de extração com falha.
Equipes que comparam o o melhor extrator de dados Ao planejar um projeto, deve-se levar em consideração a fonte de dados, os campos obrigatórios, a escala, a frequência de atualização e o nível de infraestrutura de extração de dados que se deseja manter.
O Outscraper oferece ferramentas de scraping e APIs para a coleta de dados públicos estruturados de sites e diretórios on-line, incluindo opções específicas para plataformas como Google Maps, Avaliações do Google Maps, Amazon, Trustpilot e Páginas Amarelas.
Para uma extração mais abrangente de sites, o Outscraper’s Raspador da Web universal com inteligência artificial pode ser usado quando você precisa de dados estruturados sem precisar manter toda a configuração de extração internamente.
Se o seu projeto de extração de dados de um site envolver campos definidos e várias páginas, o Universal AI-Powered Web Scraper da Outscraper pode ser uma opção a ser considerada.
Como um extrator de dados extrai dados de um site
A extrator de dados funciona lendo uma página da web, localizando as informações que recebeu a instrução de coletar e transformando esses valores em registros estruturados.
Carregando a página
Primeiramente, o scraper precisa ter acesso ao conteúdo da página da web.
Em sites mais simples, as informações necessárias podem já estar presentes no código HTML retornado pelo servidor. Outros sites carregam parte do conteúdo posteriormente, por meio de JavaScript ou de solicitações adicionais.
A forma como a página é carregada influencia o que o scraper consegue visualizar e quando os dados ficam disponíveis.
Como identificar os elementos certos da página
Assim que a página estiver disponível, o scraper precisa identificar os elementos que contêm os campos necessários.
Isso pode incluir:
- título de um produto
- um preço
- um nome comercial
- uma nota de avaliação
- um número de telefone
- um link
- uma linha da tabela
Dependendo do método, esses campos podem ser identificados por meio de seletores, da estrutura da página, de regras de extração ou de instruções assistidas por IA.
Extraindo os valores
Em seguida, o scraper coleta os valores desses elementos.
Por exemplo, uma página de produto pode exibir:
- nome do produto: Produto de Exemplo
- preço: $49
- avaliação: 4,6
- disponibilidade: Em estoque
As mesmas regras de extração podem, então, ser aplicadas a páginas semelhantes, desde que a estrutura permaneça consistente.
Transformando os resultados em registros estruturados
O conteúdo bruto de uma página da web não é muito útil por si só. Os valores extraídos precisam ser organizados em campos consistentes, de modo que cada registro siga a mesma estrutura.
No caso de uma página de produto, o resultado pode ficar assim:
| Nome do produto | Preço | Classificação | Disponibilidade | URL do produto |
|---|---|---|---|---|
| Exemplo de produto A | $49 | 4.6 | Em estoque | example.com/product-a |
| Exemplo de produto B | $72 | 4.3 | Esgotado | example.com/product-b |
| Exemplo de produto C | $35 | 4.8 | Em estoque | example.com/product-c |
Depois que os campos estiverem estruturados, os registros poderão ser exportados, analisados, armazenados em um banco de dados ou encaminhados para outro fluxo de trabalho.
A confiabilidade do conjunto de dados final depende da consistência com que o scraper consegue identificar os mesmos campos em todas as páginas-alvo.
Lista de verificação final antes de extrair dados de um site
- Defina os campos de que você precisa.
- Encontre as páginas ou URLs corretas.
- Verifique como o site carrega os dados.
- Escolha o método de extração.
- Teste uma pequena amostra.
- Valide os registros.
- Confirme o formato de saída e os requisitos de uso dos dados.
Precisa de um extrator de dados para o seu projeto de extração de dados de sites? O Outscraper ajuda você a coletar dados públicos estruturados de sites, diretórios, listagens e avaliações sem precisar gerenciar sozinho toda a configuração do scraping.
Perguntas frequentes
Perguntas e respostas mais frequentes
Um extrator de dados de sites coleta informações específicas de páginas da web e as converte em registros estruturados. Dependendo da página, isso pode incluir texto, preços, links, avaliações, dados de contato, tabelas, listagens ou outros campos visíveis.
Sim. As ferramentas de scraping visuais e sem código permitem que os usuários selecionem campos de uma página da web sem precisar escrever um script. Esses métodos funcionam melhor quando as páginas-alvo seguem uma estrutura clara e repetitiva.
Sim. Um scraper pode percorrer várias URLs, páginas de listagem, paginação ou páginas de detalhes vinculadas. A configuração precisa levar em conta a forma como o site organiza e carrega essas páginas.
O web scraping coleta informações de páginas da web, enquanto uma API fornece dados estruturados por meio de uma interface definida. As APIs costumam ser mais fáceis de integrar a aplicativos, mas os campos disponíveis dependem do que o provedor expõe.
Sim, desde que a ferramenta de extração seja compatível com esses formatos. CSV e Excel são opções comuns quando os dados precisam ser analisados, filtrados, limpos ou compartilhados em uma planilha.
Pode haver dados ausentes quando o conteúdo é carregado por meio de JavaScript, quando alguns campos não aparecem em determinadas páginas, quando os layouts variam ou quando o site altera sua estrutura. Testar várias páginas antes de realizar uma extração em maior escala pode ajudar a identificar esses problemas antecipadamente.