Indice
Copiare alcune righe da un sito web in un foglio di calcolo è facile. Quando lo stesso lavoro riguarda centinaia o migliaia di pagine, un strumento di estrazione dati può raccogliere i campi necessari e trasformarli in record strutturati in modo molto più rapido.
Tali dati potrebbero includere dettagli sui prodotti, schede aziendali, recensioni, informazioni di contatto, tabelle o link. La difficoltà sta nel fatto che i siti web non presentano né caricano le informazioni tutti allo stesso modo, quindi un metodo di estrazione che funziona su un sito potrebbe non funzionare altrettanto bene su un altro.
Per i team che raccolgono regolarmente dati dai siti web, l'estrazione deve inoltre produrre record coerenti e utilizzabili senza comportare operazioni di pulizia o manutenzione superflue.
Per scegliere l'approccio giusto, occorre innanzitutto capire di quali dati si ha bisogno, dove si trovano e in che modo il sito web li fornisce. Per una panoramica più ampia su come l'estrazione dei dati si inserisca nei flussi di lavoro aziendali, consulta la nostra guida su strumenti di data scraping e casi d'uso.
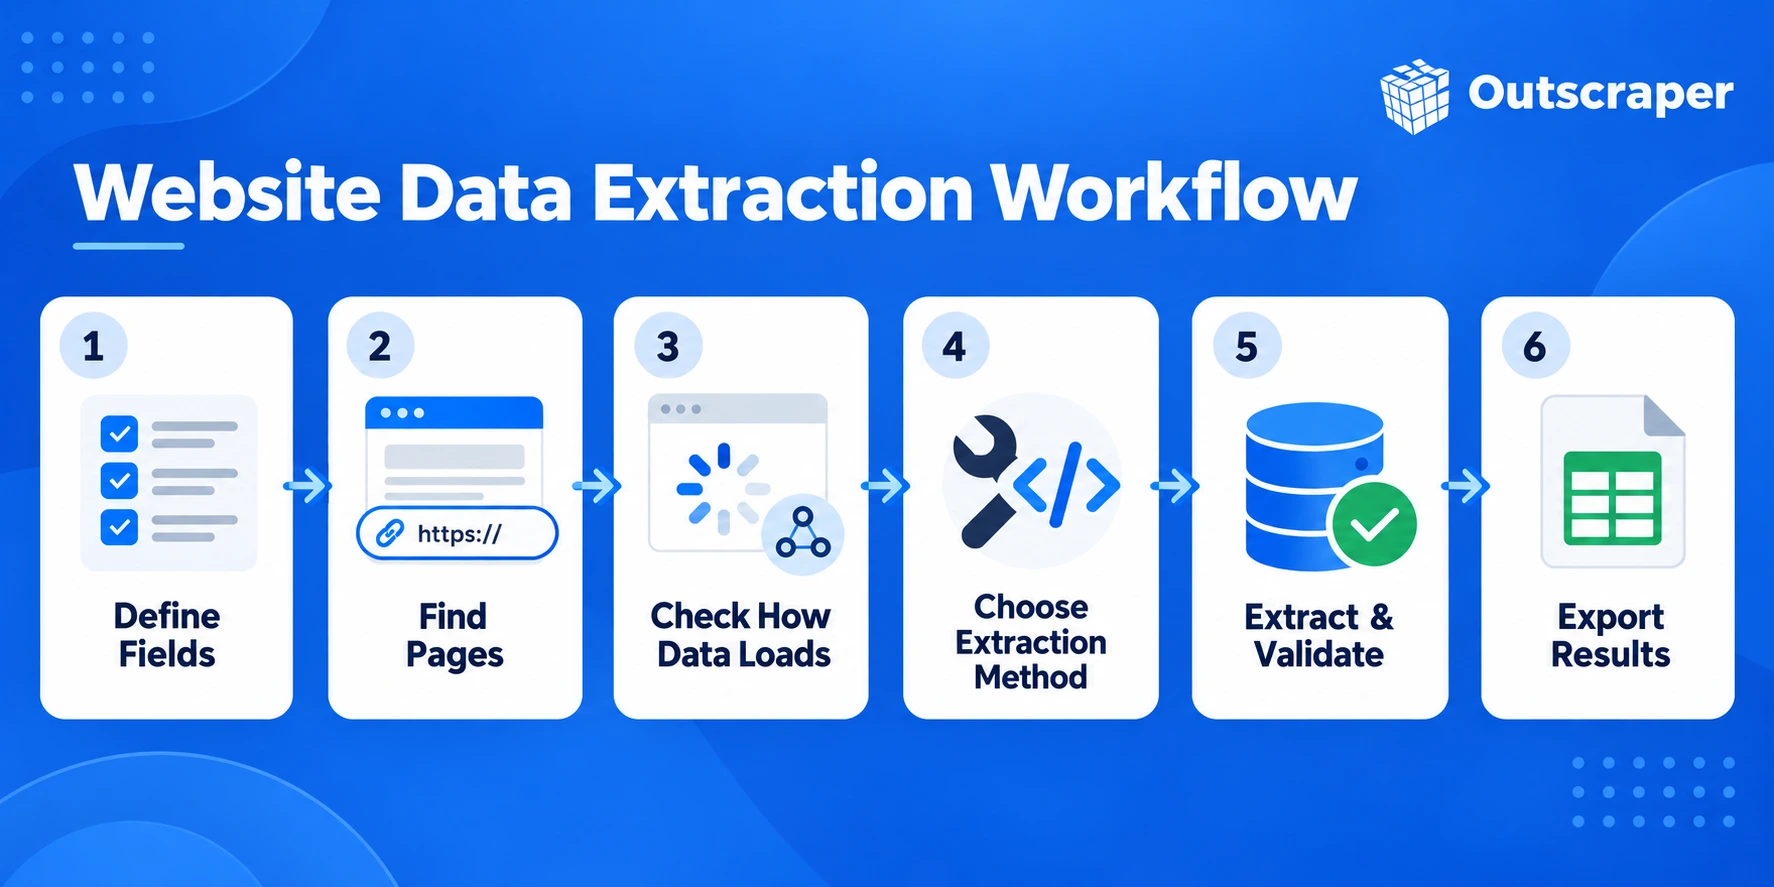
Risposta rapida: come si estraggono i dati da un sito web?
- Definisci i dati di cui hai bisogno.
- Trova le pagine che lo contengono.
- Verifica come il sito web carica i contenuti.
- Scegli un metodo di estrazione.
- Prova con un piccolo campione.
- Estrarre e convalidare i dati.
- Esporta i risultati in un formato utilizzabile.
Il metodo migliore dipende dalla struttura del sito web, dalla quantità di dati, dalla frequenza con cui questi cambiano e dal livello di manutenzione che si desidera gestire.
Outscraper’s Raschietto web universale con intelligenza artificiale estrae i campi selezionati dagli URL dei siti web senza che tu debba occuparti della configurazione dello scraping.
Come estrarre dati da un sito web, passo dopo passo
L'estrazione dei dati dai siti web è più facile da gestire se si definisce prima il formato di output e poi si sceglie lo strumento. Concentrati sui campi che ti servono, sulla loro posizione nella pagina e sulla capacità del metodo di estrazione di raccoglierli in modo coerente.
Watch: Scrape Any Website into Clean Data
1. Definire i campi dati necessari
Parti tenendo già in mente il set di dati finale.
Nel caso di un sito dedicato a un prodotto, ciò potrebbe includere:
- nome del prodotto
- prezzo
- rating
- disponibilità
- URL del prodotto
Per un elenco di aziende, potrebbero servirti:
- ragione sociale
- category
- numero di telefono
- sito web
- indirizzo
Specificare l'elenco dei campi evita estrazioni superflue e rende più facile verificare se l'output finale è completo.
2. Individuare le pagine o gli URL
A questo punto, individua le pagine che contengono le informazioni.
I dati potrebbero comparire su:
- pagine di elenco
- pagine dei prodotti
- pagine dei profili
- pagine delle categorie
- risultati della ricerca
- tabelle
- sezioni impaginate
Alcuni lavori richiedono solo i dati di un tipo di pagina. Altri necessitano invece prima delle informazioni provenienti da una pagina di elenco, seguite poi dalle singole pagine di dettaglio.
3. Verifica come il sito web carica i dati
Verifica se le informazioni vengono visualizzate immediatamente al caricamento della pagina o solo dopo aver eseguito un'azione.
Alcune pagine mostrano il contenuto direttamente nel codice HTML. Altre possono caricare i record tramite JavaScript e richieste di rete asincrone, oltre alla paginazione, ai filtri o allo scorrimento infinito.
Ciò significa che alcune informazioni potrebbero apparire dopo il caricamento della pagina iniziale, quindi uno scraper che legge solo l'HTML originale potrebbe non rilevarle.
4. Scegliere e testare un metodo di estrazione
Scegli un metodo in base alla struttura del sito web e alla quantità di dati di cui hai bisogno.
Le opzioni possono includere:
- estrazione visiva o senza codice
- Scraping basato su selettori HTML o CSS
- script personalizzati
- API
- Estrazione assistita dall'intelligenza artificiale
Prima di eseguire il processo su centinaia o migliaia di pagine, prova prima su un piccolo campione. Verifica che i campi previsti vengano visualizzati correttamente e che lo stesso metodo funzioni su pagine diverse.
5. Estrazione e verifica dei dati
Una volta che il test funziona, esegui l'estrazione sulle pagine richieste.
Non dare per scontato che i risultati siano corretti solo perché il processo è stato completato. Verifica quanto segue:
- valori mancanti
- record duplicati
- campi non corretti
- formati non uniformi
- pagine che non hanno restituito dati
La convalida è particolarmente importante quando le pagine non seguono tutte lo stesso layout.
6. Esportazione e preparazione dei risultati
Salva i dati in un formato adatto alla fase successiva.
Tra le opzioni più comuni figurano CSV, Excel e JSON. A seconda del flusso di lavoro, potrebbe comunque essere necessario sottoporre i dati in uscita a operazioni di pulizia, deduplicazione o formattazione prima che siano pronti per l'analisi o per essere trasferiti a un altro sistema.
Quali dati può estrarre uno “data scraper” da un sito web?
Il tipo di dati che è possibile raccogliere dipende da ciò che il sito web mette a disposizione nelle sue pagine. Nella maggior parte dei casi, uno scraper viene configurato per acquisire campi specifici anziché copiare l'intera pagina.
Elenchi e repertori
Gli elenchi contengono spesso record ripetuti con lo stesso insieme di campi.
Piattaforme come Google Maps e l' Pagine Gialle sono esempi comuni di fonti di tipo "directory" in cui è possibile raccogliere nomi di aziende, categorie, indirizzi, numeri di telefono, siti web e dettagli sulla posizione sotto forma di record strutturati.
Tra gli esempi tipici figurano:
- ragioni sociali
- categorie
- indirizzi
- numeri di telefono
- link a siti web
- dettagli sulla posizione
Queste pagine sono solitamente più facili da strutturare, poiché gli stessi campi ricorrono in molte schede.
Informazioni sul prodotto e sull'inserzione
Le pagine dei prodotti e i marketplace possono contenere campi quali:
- nome del prodotto
- prezzo
- description
- rating
- disponibilità
- informazioni sul venditore
- URL del prodotto
Alcune di queste informazioni potrebbero essere riportate nelle pagine degli elenchi, mentre ulteriori dettagli sono disponibili solo nella pagina dedicata al singolo prodotto.
Per un esempio specifico relativo a una fonte, quello di Outscraper Scraper di prodotti Amazon è in grado di raccogliere dati strutturati relativi ai prodotti e alle inserzioni dalle pagine di Amazon.
Tabelle e record strutturati
I siti web pubblicano spesso informazioni sotto forma di tabelle, griglie comparative, calendari o altri layout ricorrenti.
Uno scraper può raccogliere i valori di ogni riga o colonna e convertirli in record più facili da ordinare, filtrare o analizzare.
Recensioni e valutazioni
Le pagine delle recensioni possono includere:
- testo della recensione
- rating
- data di revisione
- nome del recensore
- testo della risposta
- altri dettagli visibili della recensione
Outscraper Scraper di recensioni di Google Maps può fornire dati di analisi strutturati per il monitoraggio della reputazione, l'analisi dei feedback dei clienti e lo studio della concorrenza.
I campi disponibili variano a seconda del sito web, pertanto la configurazione dell'estrazione deve corrispondere alla struttura della pagina delle recensioni.

Utilizza Outscraper Scraper di recensioni di Google Maps per raccogliere i dati relativi alle recensioni dei clienti sulle aziende che stai analizzando.
Contatti per il pubblico e informazioni sull'azienda
I siti web aziendali, gli elenchi e le pagine di profilo possono riportare:
- ragioni sociali
- indirizzi
- numeri di telefono
- indirizzi e-mail
- URL dei siti web
- collegamenti social
- altri dettagli relativi alla società quotata in borsa
Non tutte le pagine contengono tutti i campi, pertanto è normale che si verifichino valori mancanti quando si lavora con set di dati di grandi dimensioni.
Quando i dati di contatto sono i campi principali di cui hai bisogno, Outscraper’s Scraper di e-mail e contatti è in grado di raccogliere indirizzi e-mail, numeri di telefono e profili social pubblici dai siti web.

Outscraper offre strumenti di scraping per schede aziendali, recensioni, prodotti, elenchi e dati di contatto pubblici.
Perché alcuni siti web sono più difficili da sottoporre a scraping rispetto ad altri
Due siti web possono presentare informazioni simili, ma richiedere metodi di estrazione molto diversi. La difficoltà deriva solitamente dal modo in cui la pagina carica i contenuti, dalla distribuzione dei record all’interno del sito e dal grado di coerenza della struttura della pagina.
Contenuto generato tramite JavaScript
Alcuni siti web non inseriscono tutte le informazioni visibili nel codice HTML iniziale. Al contrario, JavaScript carica parte della pagina dopo la prima richiesta.
Un semplice scraper potrebbe raccogliere la pagina, ma tralasciare comunque i campi visibili all'utente nel browser. In questi casi, il metodo di estrazione deve tenere conto dei contenuti che compaiono dopo il caricamento della pagina.
Impaginazione e scorrimento infinito
Un elenco può contenere centinaia di voci, ma solo un numero esiguo di esse compare nella prima pagina.
L'impaginazione suddivide tali record tra più URL o stati di pagina. Lo scorrimento infinito carica ulteriori risultati man mano che il visitatore scorre la pagina verso il basso.
In entrambi i casi, lo scraper deve continuare a richiedere o caricare ulteriori record, anziché fermarsi dopo il primo insieme visibile.
Diversi layout di pagina
Non tutte le pagine dello stesso sito web seguono la stessa struttura.
Ad esempio, alcune pagine dei prodotti possono includere un campo relativo al prezzo, alla valutazione e alla disponibilità, mentre altre utilizzano un layout diverso o omettono del tutto determinati campi.
Le regole di estrazione che funzionano su una pagina potrebbero quindi dover gestire diverse varianti.
Campi mancanti o incoerenti
I dati dei siti web sono raramente completi in tutte le pagine.
Un profilo aziendale può riportare un numero di telefono ma nessun indirizzo e-mail. Un prodotto può avere una valutazione, mentre un altro non ha ancora recensioni.
Lo scraper deve conservare il record anche quando mancano alcuni campi previsti.
Modifica delle strutture dei siti web
I siti web vengono aggiornati nel corso del tempo. Una pagina riprogettata, un elemento rinominato o un cambiamento nel comportamento di caricamento possono compromettere una configurazione di estrazione che in precedenza funzionava correttamente.
Questo è uno dei motivi per cui l'estrazione ricorrente di dati da un sito web richiede solitamente una manutenzione maggiore rispetto a un'operazione una tantum. Maggiore è il numero di pagine e di tipi di pagina coinvolti, più diventa importante verificare che i risultati rimangano coerenti.
Metodi per estrarre dati strutturati da un sito web
Non esiste un unico metodo di estrazione adatto a tutti i siti web. L'approccio corretto dipende da come è strutturata la pagina, dalla quantità di dati necessari e dal fatto che il processo venga eseguito una sola volta o ripetutamente.
Estrazione visiva e senza codice
Gli scraper visivi consentono agli utenti di selezionare i campi desiderati direttamente da una pagina web senza dover scrivere codice.
Questo metodo funziona bene per pagine più semplici con layout ripetitivi, come elenchi, schede prodotto o tabelle. È utile anche quando il processo di estrazione è di piccole dimensioni o quando un utente senza competenze tecniche deve configurare il flusso di lavoro.
Estrazione dei selettori HTML e CSS
Molti scraper identificano gli elementi delle pagine attraverso la struttura HTML, Selettori CSS, o norme simili.
Questo approccio offre un maggiore controllo sui campi da raccogliere e funziona bene quando le pagine di destinazione presentano un layout coerente.
Il suo principale punto debole è la manutenzione. Se il sito web modifica la struttura delle pagine, potrebbe essere necessario aggiornare i selettori.
Codice personalizzato
Gli sviluppatori possono creare la propria logica di estrazione utilizzando linguaggi come Python o JavaScript.
Il codice personalizzato è utile quando il sito web presenta un comportamento anomalo, i dati richiedono un trattamento speciale o l'estrazione deve integrarsi perfettamente con un altro sistema.
Il compromesso è che il team si assume anche la responsabilità dei test, della manutenzione, della gestione degli errori e delle modifiche al sito web.
API
Alcuni flussi di lavoro possono raccogliere dati dai siti web tramite un'API, anziché gestire direttamente la logica di estrazione.
Un'API può rivelarsi utile quando i dati devono alimentare un'applicazione, un database o un flusso di lavoro ricorrente. Gli sviluppatori che utilizzano Outscraper possono fare riferimento al Documentazione dell'API di Universal Scraper per i parametri disponibili, le risposte e gli esempi di richiesta.
Per i dati aziendali basati sulla posizione, Outscraper’s API Places di Google Maps può essere utilizzato per richiedere informazioni strutturate relative a luoghi e attività commerciali per applicazioni, database o flussi di lavoro ricorrenti.
I campi disponibili, i limiti e il comportamento dipendono dall'API utilizzata.
Estrazione assistita dall'intelligenza artificiale
L'estrazione assistita dall'intelligenza artificiale è in grado di identificare i campi in base alle informazioni richieste dall'utente, anziché basarsi esclusivamente su selettori fissi.
Ciò può essere utile quando le pagine presentano layout meno uniformi o quando definire manualmente ogni regola di estrazione richiederebbe troppo tempo.
Le Guida universale a Universal AI Scraper mostra come Outscraper applichi questo approccio per estrarre campi selezionati dagli URL dei siti web.
È ancora necessario sottoporla a dei test. Prima di utilizzarla su larga scala, l’estrazione basata sull’intelligenza artificiale dovrebbe essere verificata per individuare eventuali campi mancanti, valori errati e risultati incoerenti.
Esempi di estrazione di dati da siti web con l'ausilio dell'intelligenza artificiale
L'estrazione assistita dall'intelligenza artificiale può essere utilizzata per diversi tipi di pagine, a seconda delle informazioni disponibili sul sito web.
Esempio di elenco di aziende
Per un elenco di aziende, potresti richiedere campi quali nome dell'azienda, sito web, numero di telefono, categoria e indirizzo.
Esempio di pagina di prodotto
Per le pagine dei prodotti, i campi richiesti potrebbero includere il nome del prodotto, il prezzo, la disponibilità, la valutazione e l'URL del prodotto.
Esempio di articolo o annuncio
Per le pagine di contenuto o di elenco, è possibile estrarre campi quali titolo, autore, data di pubblicazione, categoria e URL della pagina.
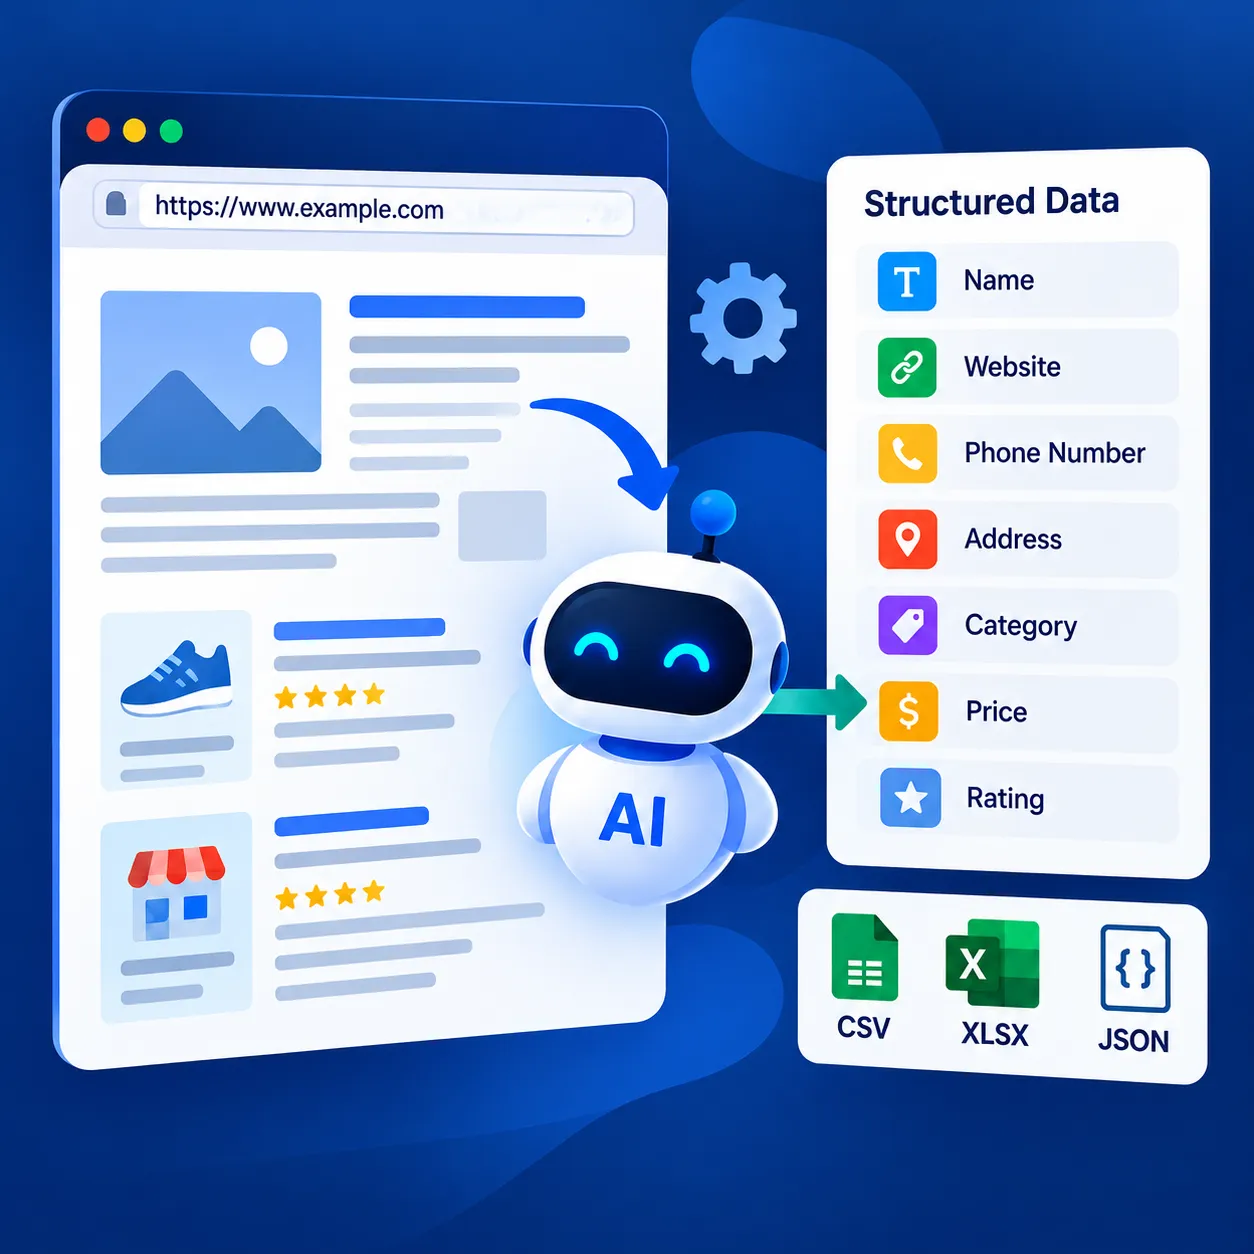
Utilizza Outscraper Raschietto web universale con intelligenza artificiale per estrarre i campi necessari dalle pagine del sito web e restituirli sotto forma di dati strutturati.
Come scegliere il metodo giusto per l'estrazione dei dati da un sito web
Il metodo di estrazione più adatto dipende dal sito web, dalla quantità di dati coinvolti e dalla frequenza con cui il processo deve essere eseguito. Una pagina semplice potrebbe richiedere solo uno scraper visivo, mentre un’operazione di grandi dimensioni o ricorrente potrebbe richiedere l’uso di codice, un’API o un servizio di estrazione gestito.

Adattare il metodo al sito web
Iniziamo dal modo in cui il sito web presenta i propri dati.
Una pagina con un layout stabile e campi ricorrenti può essere gestita efficacemente con i selettori o uno scraper no-code. Un sito che fa ampio ricorso a JavaScript, al caricamento dinamico o a layout variabili potrebbe richiedere un approccio più flessibile.
Più complesso è il comportamento della pagina, più è importante testare il metodo prima di estenderne l'applicazione.
Considerare la portata, la frequenza e la manutenzione
Un metodo che funziona per 20 pagine potrebbe non essere la scelta migliore per 20.000.
Per un'estrazione una tantum, la configurazione manuale può essere accettabile. In caso di raccolta ricorrente, la manutenzione assume un peso maggiore nella decisione.
Si consideri quanto segue:
- quante pagine devono essere elaborate
- con quale frequenza è necessario aggiornare i dati
- se la struttura della pagina cambia spesso
- quanto monitoraggio richiede il flusso di lavoro
- se il vostro team è in grado di mantenere una logica di scraping personalizzata
Più il lavoro è ampio e frequente, tanto più diventa importante ridurre i controlli manuali e le configurazioni ripetitive.
Verifica i requisiti relativi all'output e all'utilizzo dei dati
Il metodo di estrazione dovrebbe inoltre essere adeguato a ciò che avviene dopo la raccolta dei dati.
Se i risultati devono essere trasferiti in un foglio di calcolo, in un database, in un'applicazione o in un flusso di lavoro automatizzato, verificare che il metodo supporti il formato e la struttura richiesti.
È inoltre importante prendere visione delle norme di accesso al sito web, del tipo di informazioni raccolte e dei requisiti relativi alle modalità di utilizzo dei dati.
Quando si estraggono dati da un sito web, verificare anche se le informazioni sono accessibili al pubblico, se il sito prevede termini e condizioni o restrizioni di accesso e se le norme in materia di privacy o protezione dei dati incidono sulle modalità di archiviazione o utilizzo delle informazioni raccolte. I requisiti possono variare a seconda del sito web, del tipo di dati, dell’uso previsto e della giurisdizione.
Un buon metodo di estrazione dovrebbe adattarsi sia al sito web che al flusso di lavoro che ne consegue.
Il ruolo di Outscraper nel flusso di lavoro di estrazione dei dati da un sito web
Realizzare uno scraper personalizzato ti garantisce il pieno controllo, ma comporta anche dover gestire autonomamente i test, la manutenzione, le modifiche alle pagine e i processi di estrazione non riusciti.
I team che mettono a confronto il il miglior strumento per l'estrazione dei dati Per un progetto è opportuno valutare la fonte dei dati, i campi obbligatori, la portata, la frequenza di aggiornamento e l'entità dell'infrastruttura di scraping che si intende mantenere.
Outscraper offre strumenti di scraping e API per la raccolta di dati pubblici strutturati da siti web e elenchi online, comprese opzioni specifiche per piattaforme quali Google Maps, Google Maps Reviews, Amazon, Trustpilot e Yellow Pages.
Per un’estrazione più ampia dai siti web, Outscraper’s Raschietto web universale con intelligenza artificiale può essere utilizzato quando si hanno bisogno di dati strutturati senza dover gestire internamente l'intera configurazione di scraping.
Se il tuo progetto di estrazione dati da siti web prevede campi definiti e più pagine, lo “Universal AI-Powered Web Scraper” di Outscraper può essere una delle opzioni da prendere in considerazione.
Come uno scraper estrae i dati da un sito web
A strumento di estrazione dati funziona leggendo una pagina web, individuando le informazioni che gli è stato chiesto di raccogliere e trasformando tali valori in record strutturati.
Caricamento della pagina
Lo scraper deve innanzitutto poter accedere ai contenuti della pagina web.
Nel caso di siti più semplici, le informazioni richieste potrebbero essere già presenti nel codice HTML restituito dal server. Altri siti caricano parte dei contenuti in un secondo momento tramite JavaScript o richieste aggiuntive.
Il modo in cui la pagina viene caricata influisce su ciò che lo scraper è in grado di rilevare e sul momento in cui i dati diventano disponibili.
Individuare gli elementi giusti della pagina
Una volta che la pagina è disponibile, lo scraper deve identificare gli elementi che contengono i campi richiesti.
Tra questi potrebbero figurare:
- titolo di un prodotto
- un prezzo
- una ragione sociale
- una valutazione
- un numero di telefono
- un link
- una riga della tabella
A seconda del metodo, tali campi possono essere identificati tramite selettori, struttura della pagina, regole di estrazione o istruzioni assistite dall'intelligenza artificiale.
Estrazione dei valori
Lo scraper raccoglie quindi i valori di tali elementi.
Ad esempio, una pagina di prodotto potrebbe restituire:
- nome del prodotto: Prodotto di esempio
- prezzo: $49
- valutazione: 4,6
- disponibilità: Disponibile
Le stesse regole di estrazione possono quindi essere applicate a pagine simili, purché la struttura rimanga coerente.
Trasformare i risultati in registrazioni strutturate
Il contenuto grezzo di una pagina web non è di per sé molto utile. I valori estratti devono essere organizzati in campi coerenti, in modo che ogni record segua la stessa struttura.
Per una pagina di prodotto, il risultato potrebbe essere simile a questo:
| Nome del prodotto | Prezzo | Valutazione | Disponibilità | URL del prodotto |
|---|---|---|---|---|
| Esempio di prodotto A | $49 | 4.6 | Disponibile | example.com/product-a |
| Esempio di prodotto B | $72 | 4.3 | Esaurito | example.com/product-b |
| Esempio di prodotto C | $35 | 4.8 | Disponibile | example.com/product-c |
Una volta strutturati i campi, i record possono essere esportati, analizzati, archiviati in un database o trasferiti a un altro flusso di lavoro.
L'affidabilità del set di dati finale dipende dalla capacità dello scraper di individuare con costanza gli stessi campi in tutte le pagine di destinazione.
Lista di controllo finale prima di estrarre dati da un sito web
- Definisci i campi che ti servono.
- Trova le pagine o gli URL giusti.
- Verifica come il sito carica i dati.
- Scegli il metodo di estrazione.
- Prova con un piccolo campione.
- Verificare la validità dei record.
- Verificare il formato di output e i requisiti relativi all'utilizzo dei dati.
Hai bisogno di un strumento di estrazione dati per il tuo progetto di estrazione dati dai siti web? Outscraper ti aiuta a raccogliere dati pubblici strutturati da siti web, elenchi, directory e recensioni senza dover gestire autonomamente l'intera configurazione dello scraping.
Domande frequenti
Domande e risposte più frequenti
Uno strumento di data scraping per siti web raccoglie informazioni specifiche dalle pagine web e le converte in record strutturati. A seconda della pagina, tali informazioni possono includere testo, prezzi, link, recensioni, recapiti, tabelle, elenchi o altri campi visibili.
Sì. Gli strumenti di scraping visivi e "no-code" consentono agli utenti di selezionare i campi da una pagina web senza dover scrivere uno script. Questi metodi funzionano al meglio quando le pagine di destinazione seguono una struttura chiara e ricorrente.
Sì. Uno scraper può passare da un URL all'altro, tra elenchi di pagine, impaginazione o pagine di dettaglio collegate. La configurazione deve tenere conto di come il sito web organizza e carica tali pagine.
Il web scraping raccoglie informazioni dalle pagine web, mentre un'API fornisce dati strutturati attraverso un'interfaccia definita. Le API sono spesso più facili da integrare nelle applicazioni, ma i campi disponibili dipendono da ciò che il fornitore rende accessibile.
Sì, se lo strumento di estrazione supporta tali formati. I formati CSV ed Excel sono le scelte più comuni quando è necessario esaminare, filtrare, pulire o condividere i dati in un foglio di calcolo.
I dati mancanti possono verificarsi quando i contenuti vengono caricati tramite JavaScript, quando in alcune pagine mancano dei campi, quando i layout variano o quando il sito web modifica la propria struttura. Testare diverse pagine prima di eseguire un’estrazione su larga scala può aiutare a individuare tempestivamente questi problemi.