Das Inhaltsverzeichnis
An Kettenunternehmen identifizieren Bei der Auswertung von Google Maps-Daten in großem Maßstab müssen Sie zunächst zwei verschiedene Probleme voneinander trennen: die Identifizierung jedes einzelnen physischen Standorts und die Feststellung, ob dieser Standort zu einer größeren Kette gehört. Ein bloßer Namensabgleich reicht nicht aus, da auch unabhängige Unternehmen ähnliche Namen tragen können, während echte Filialen einer Kette unter Umständen ein leicht abweichendes Branding verwenden. Ein zuverlässiger Arbeitsablauf speichert jeden Standort als eigenen Datensatz, verwendet nach Möglichkeit stabile Standortkennungen, fügt eine Kettenklassifizierung hinzu und validiert unklare Übereinstimmungen anhand mehrerer Unternehmensmerkmale. Dieser Leitfaden zeigt, wie man diesen Prozess aufbaut, ohne die Erkennung von Duplikaten, die Zugehörigkeit zu einer Kette und die rechtliche Eigentümerschaft als ein und dasselbe zu behandeln.
Bevor Sie die Ketten klassifizieren, sammeln Sie strukturierte Google-Maps-Datensätze mit den Feldern „Standort“, „Kategorie“, „Website“, „Telefonnummer“, „Adresse“ und „Kennung“, die Sie für die Validierung benötigen.
Kurze Antwort
Um Kettenunternehmen in den Google Maps-Daten zu identifizieren, sollten Sie jeden physischen Standort als separaten Datensatz führen, angeben, ob das Unternehmen zu einer Kette gehört, und unklare Übereinstimmungen anhand von Merkmalen wie Firmenname, Kategorie, Website, Telefonnummer, Adresse und Standortmustern überprüfen. Führen Sie Datensätze nicht einfach deshalb zusammen, weil die Namen übereinstimmen, und betrachten Sie die Zugehörigkeit zu einer Kette nicht als Beweis für eine gemeinsame rechtliche Eigentümerschaft.
Warum die Identifizierung von Ketten schwieriger ist als der Abgleich von Firmennamen
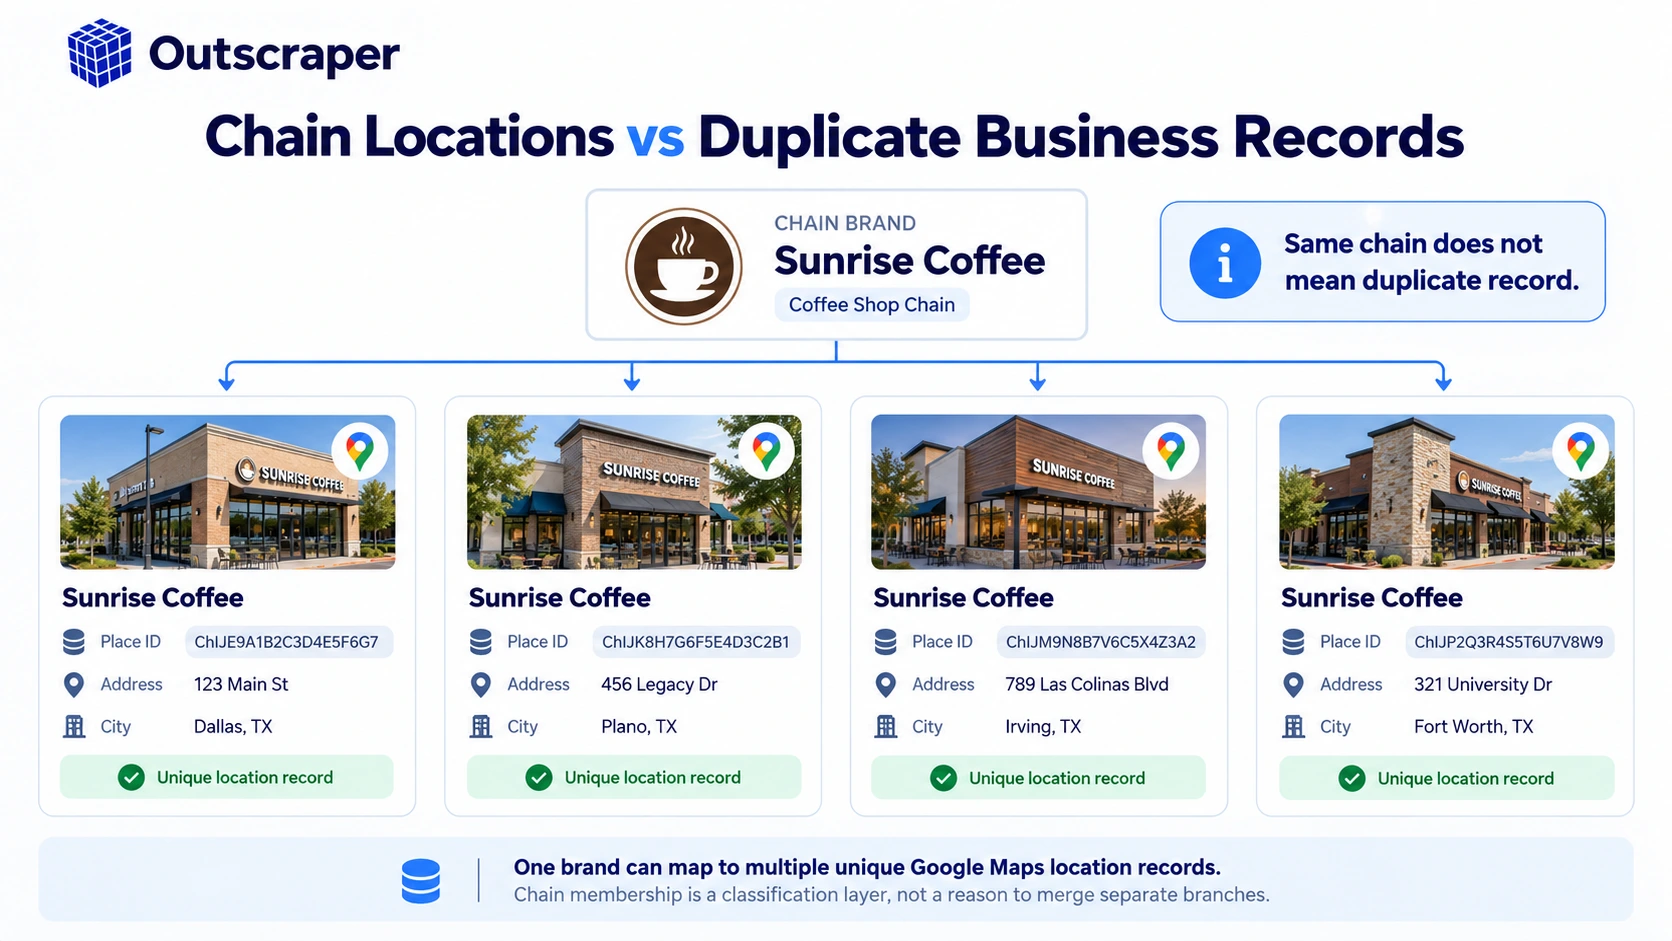
Ein Google Maps-Datensatz ist grundsätzlich standortbezogen. Eine Marke mit 150 Filialen kann als 150 eigenständige Einträge erscheinen, da jede Filiale einen separaten Standort darstellt. Gleichzeitig können zwei Unternehmen, die in keiner Verbindung zueinander stehen, ähnliche oder sogar identische Namen haben.
Dadurch ergibt sich ein wichtiger Unterschied:
Doppelte Datensätze ≠ Standort in der Kette ≠ dasselbe Unternehmen
Angenommen, ein Datensatz enthält fünf Datensätze mit dem Namen “Central Coffee”. Diese Datensätze könnten fünf Filialen einer Marke darstellen, mehrere unabhängige Unternehmen, die denselben Namen verwenden, oder eine Mischung aus beidem. Würden vier Datensätze gelöscht, weil die Namen übereinstimmen, könnten dadurch gültige Standorte entfernt werden.
Das gegenteilige Problem tritt ebenfalls auf. Eine echte Kette verwendet möglicherweise nicht überall genau denselben sichtbaren Namen. Die aktuellen Richtlinien von Google für Unternehmensprofile sehen grundsätzlich einheitliche Namen und Kategorien für alle Standorte einer Kette vor, lassen jedoch auch Ausnahmen für Untermarken, Abteilungen, unterschiedliche Betriebsformate und tatsächliche Namensvarianten zu.
Das bedeutet, dass die Übereinstimmung der Namen zwar ein nützlicher Anhaltspunkt ist, für sich genommen jedoch kein ausreichender Beweis darstellt.
Die Analyseeinheit muss daher vor der Klassifizierung definiert werden. Der aktuelle Leitfaden von Outscraper zu Google Maps-Unternehmensdaten für die Marktanalyse macht eine ähnliche Unterscheidung: Je nach der zu untersuchenden Fragestellung müssen Forscher möglicherweise einzelne Standorte, Unternehmen, Marken oder Dienstleistungsbereiche zählen.
Für die Identifizierung von Ketten ist der sicherste Ausgangspunkt:
ein gültiger physischer Standort = ein Datensatz auf Standortebene
Fügen Sie dann die Kettenzugehörigkeit als weitere Ebene hinzu.
Beginnen Sie mit einem Datensatz pro Standort in Google Maps
Bevor Sie entscheiden, ob ein Unternehmen zu einer Kette gehört, sollten Sie sicherstellen, dass der Datensatz zuverlässig zwischen den einzelnen Standorten unterscheiden kann.
Der Firmenname eignet sich nur bedingt als primäres Identifikationsmerkmal, da die Eindeutigkeit von Namen nicht gewährleistet ist. Die Adresse ist zwar hilfreich, doch Formatierungsunterschiede können zu falschen Übereinstimmungen führen. Telefonnummern und Websites sind nützlich, können jedoch auch weitergegeben werden oder fehlen.
Die Google Place-ID ist ein aussagekräftigeres Feld auf Standortebene, da Google Place-IDs als Kennungen für Orte in seiner Places-Datenbank beschreibt. Google weist zudem auf zwei wichtige Einschränkungen hin: Ein und derselbe Ort kann manchmal mehrere Place-IDs haben, und Place-IDs können sich im Laufe der Zeit ändern. Google empfiehlt, gespeicherte IDs, die älter als 12 Monate sind, zu aktualisieren.
In diesem Arbeitsablauf sollte die Standort-ID daher als eindeutiger Standortbezeichner betrachtet werden – und nicht als dauerhafter Unternehmensbezeichner.
Ein praxisorientierter Datensatz auf Standortebene sollte folgende Felder enthalten:
| Feld | Rolle im Arbeitsablauf |
|---|---|
| Ortskennung | Unterscheidet einzelne Orte |
| Firmenname | Liefert Nachweise zur Marke/zum Namen |
| Adresse | Bestätigt den physischen Standort |
| Kategorie | Erleichtert den Vergleich von Unternehmensformen |
| Webseite | Unterstützt den Abgleich von Marken und Domains |
| Telefon | Fügt ein weiteres Identitätssignal hinzu |
| Koordinaten | Bestätigt die geografische Trennung |
| Kettenstatus | Fügt die Klassifizierung „Kette/keine Kette“ hinzu |
Falls Ihre Rohdaten noch doppelte Suchergebnisse für denselben Ort enthalten, entfernen Sie bitte die tatsächlich doppelten Ortsdatensätze, bevor Sie versuchen, Marken zu gruppieren. Dies ist ein anderer Vorgang als das Entfernen mehrerer Filialen derselben Kette.
Verwenden Sie die Kettenklassifizierung, bevor Sie versuchen, Marken zu gruppieren
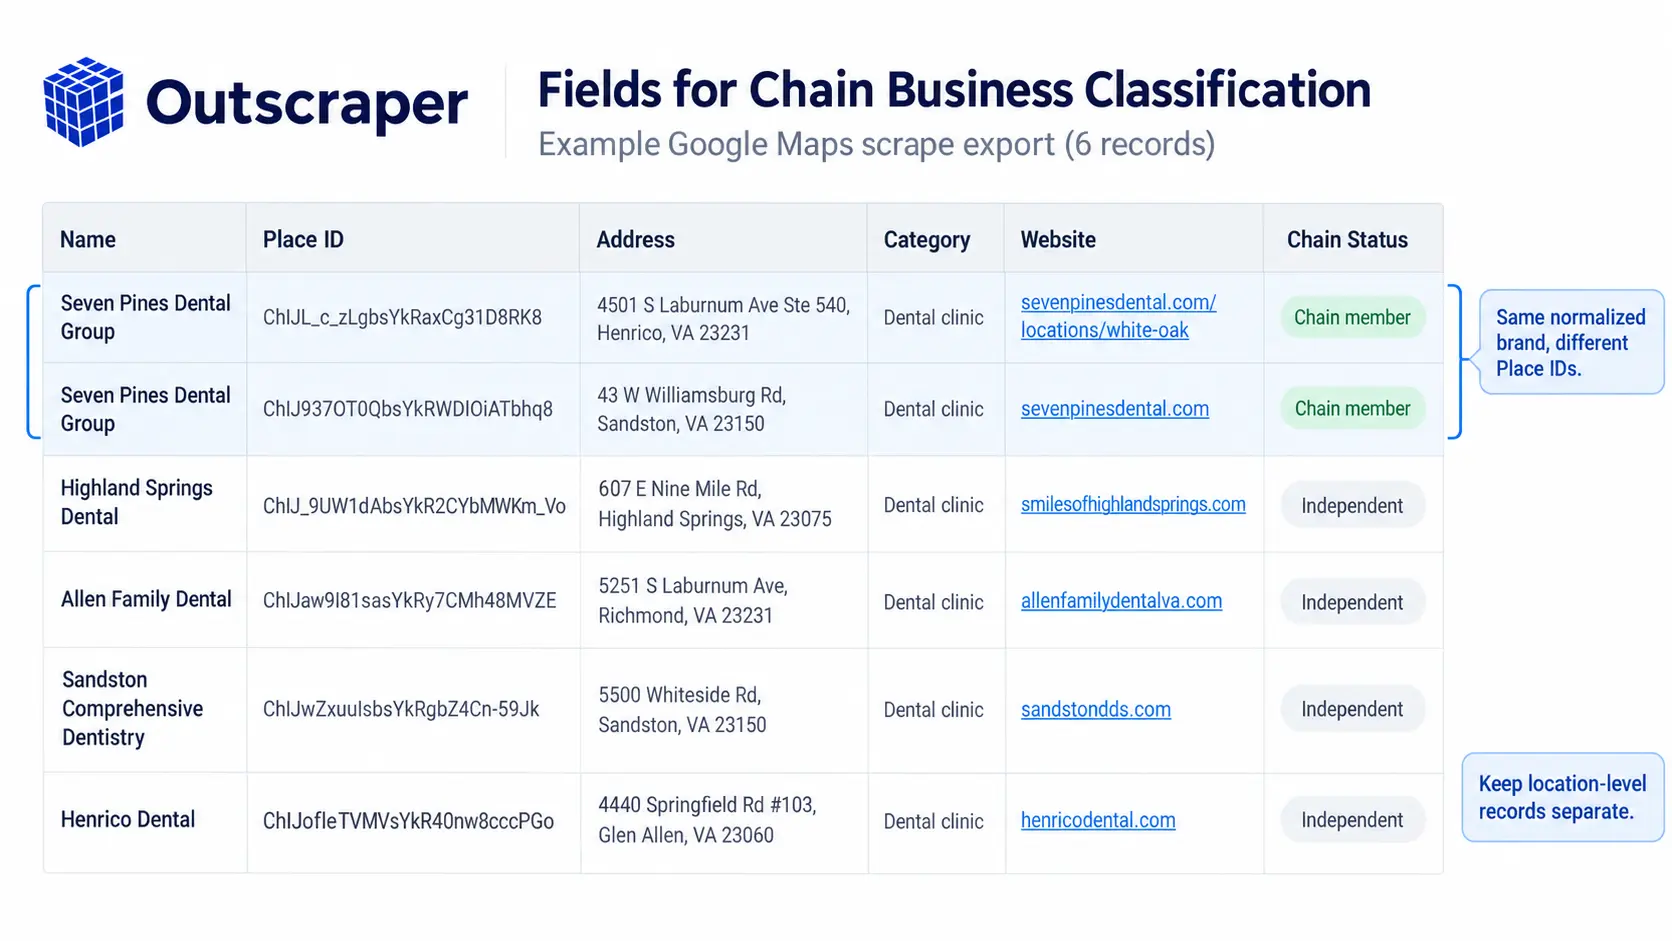
Sobald jeder Standort korrekt erfasst ist, stellt sich als Nächstes die Frage, ob das Unternehmen Teil einer Kette ist.
In der aktuellen API-Dokumentation von Outscraper sind die Informationen zur Kette Anreicherung unter dem Parameter ai_chain_info. In der Dokumentation wird beschrieben, dass dabei ermittelt wird, ob ein Unternehmen Teil einer Kette ist, und dass ein Wahr/Falsch-Anzeige zu den zurückgegebenen Daten.
Das ist nützlich, weil dadurch zwei Aufgaben voneinander getrennt werden, die oft miteinander vermischt werden:
Aufgabe 1: Is this business part of a chain?
Task 2: Which exact brand, parent company, franchise system, or legal entity should this location be associated with?
Chain Info supports the first question. The current documentation does not state that it automatically supplies a verified parent company, franchisee identity, legal ownership structure, or complete global location count.
That boundary matters.
A wahr chain value should be treated as a classification signal. It should not be converted into unsupported claims about ownership.
Zum Beispiel:
| Record | Kettenstatus | What you can say |
|---|---|---|
| Business A — Location 1 | True | Classified as part of a chain |
| Business B | False | Not classified as part of a chain |
| Business C — Location 2 | True | Classified as part of a chain |
What you still cannot determine from that boolean field alone is whether Location 1 is corporate-owned, franchised, licensed, operated by a subsidiary, or connected to a particular legal entity.
This is where validation and entity grouping become separate steps.
Add chain classification to structured records
If your workflow uses the Outscraper API, review the current enrichment parameters before designing the classification pipeline.
Validate Chain Matches With Multiple Business Signals
Automated classification makes large datasets manageable, but uncertain or high-value records may still need validation.
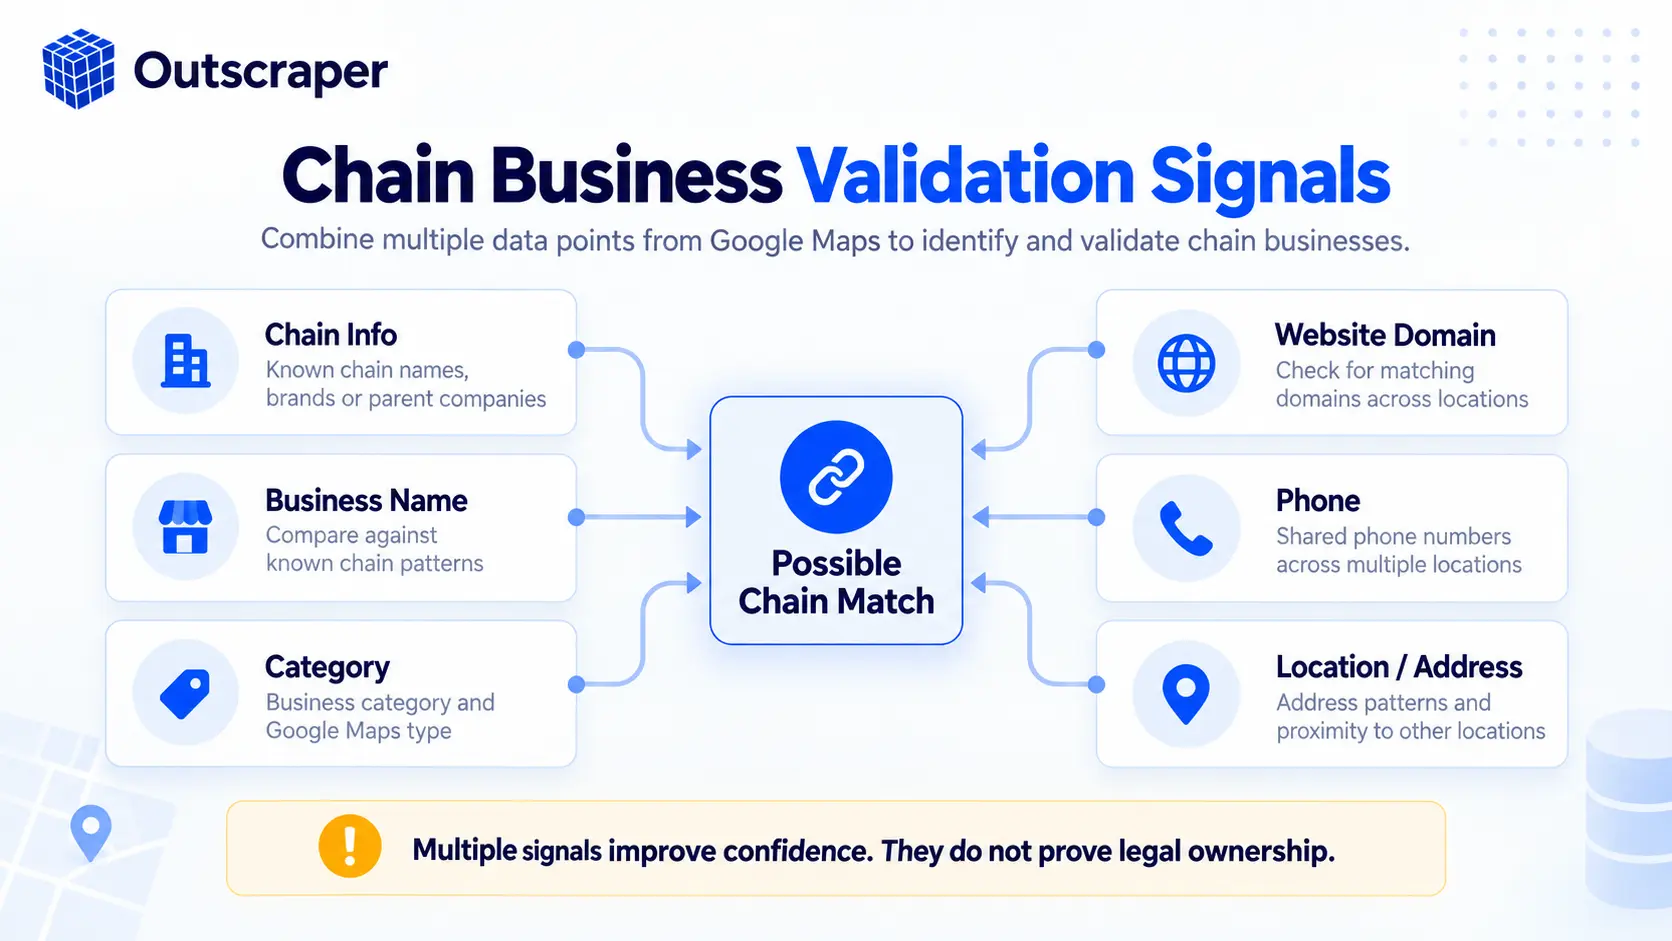
The strongest process uses several signals together rather than treating one field as definitive.
Name and category consistency
Start with the business name and primary category.
Google’s guidelines say chain locations should generally use consistent names and categories when they provide the same service. The same guidance also documents exceptions for sub-brands, departments, different operational formats, and real-world naming variations.
That produces two useful rules:
Consistent name + consistent category strengthens a possible chain match.
Different name does not automatically disprove a chain relationship.
A brand may operate multiple formats with legitimate naming differences.
Website and contact signals
Websites can strengthen a match when multiple locations use the same corporate domain or location pages underneath the same domain.
However, domain matching should still be treated as supporting evidence.
A franchise location may operate its own local website. A business can redirect multiple domains into one brand site. Different businesses can also use common marketplace or booking domains that reveal little about ownership.
Phone data has similar limitations. Some chains use local numbers for every branch, while others route several locations through a centralized number.
Location identity and geographic patterns
Addresses and coordinates help confirm that records represent different physical locations rather than duplicate exports.
Geographic repetition can also reveal an expected chain pattern: the same or similar business identity repeated across several cities or regions.
But geographic scale is not proof of ownership. A licensing network, franchise system, cooperative, or unrelated businesses with similar naming can produce superficially similar patterns.
A strong validation rule is therefore:
Use multiple signals to increase confidence; do not use one field as legal proof.
Separate Chain Membership From Brand and Ownership
This is the part of chain identification that is easiest to oversimplify.
A business can be part of a recognizable chain without every location having the same legal owner.
Franchise systems are the obvious example. Several locations may share a brand, operating model, and customer-facing identity while being operated by separate franchisees.
Sub-brands create another problem. Google explicitly allows certain chain locations to use different real-world names for distinct business formats and sub-brands.
Even two brands operating from the same address do not necessarily represent one record. Google’s Business Profile guidance says independently operating brands at the same location may have separate profiles.
For data work, keep these concepts separate:
| Data layer | Question |
|---|---|
| Location identity | Is this a distinct physical/place record? |
| Chain classification | Is the business classified as part of a chain? |
| Brand grouping | Do several records appear to operate under the same brand identity? |
| Legal ownership | Which legal entity owns or operates the location? |
Google Maps data can support the first layers well. Legal ownership may require additional corporate records, franchise disclosures, company data, first-party information, or other authoritative sources.
This separation also protects the dataset from false precision.
Instead of writing:
“These 47 locations are owned by Company X.”
when ownership has not been verified, use the narrower conclusion:
“These 47 records were classified or grouped as locations associated with Brand X based on the available business signals.”
That is a more defensible statement.
Scale the Classification Across a Large Google Maps Dataset
Manual review can work for 20 businesses. It becomes inconsistent when the dataset contains thousands of locations.
At scale, the process should become a repeatable pipeline.
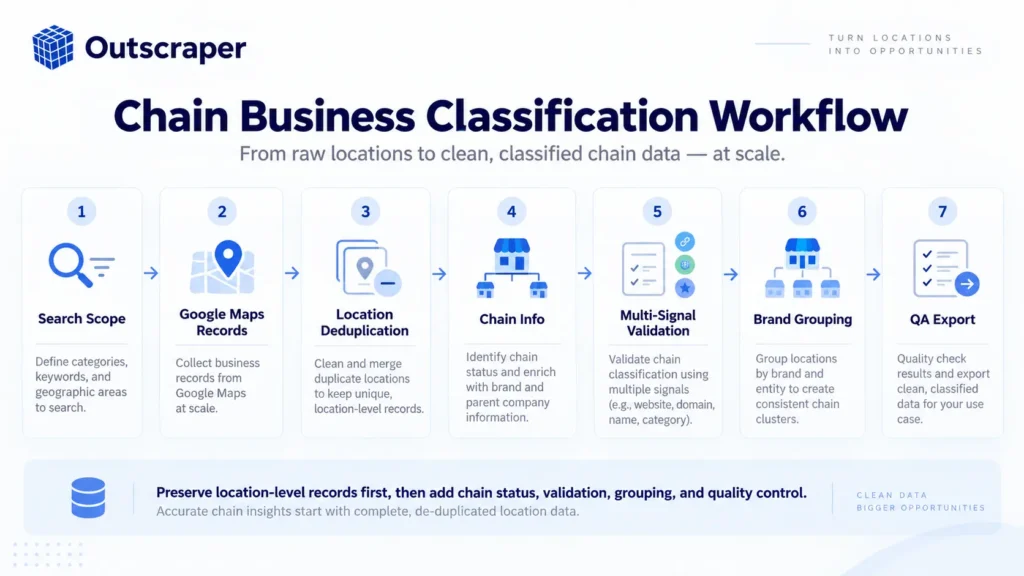
A practical workflow looks like this:
Define the collection scope. Set the business categories, countries, cities, or other geographic boundaries before collection.
Collect one location-level record per place. Preserve Place ID, address, name, category, website, phone, and coordinates.
Remove actual repeated place records. Deduplicate repeated exports of the same location without collapsing legitimate chain branches.
Add chain classification. Apply Chain Info or another defined classification method.
Normalize fields for comparison. Standardize business names, domains, phone formatting, categories, and addresses where necessary.
Create brand-level grouping fields. Keep these separate from the original location data.
Flag uncertain records. Route conflicting or incomplete matches to manual review rather than forcing a classification.
Preserve evidence columns. Keep enough source fields to explain later why a record was grouped or rejected.
The output might contain fields such as:
| ort_id | Name | Kategorie | Website | chain_status | normalisierte_Marke | review_status |
|---|---|---|---|---|---|---|
| ID-A | Brand A Downtown | Restaurant | brand-a.example | True | Brand A | Confirmed |
| ID-B | Brand A North | Restaurant | brand-a.example | True | Brand A | Confirmed |
| ID-C | Brand A Services | Berater | different.example | False/Review | — | Manual review |
The exact schema can change, but the principle should not:
never overwrite the underlying place-level evidence simply to make grouping easier.
If the data-collection stage is still manual, standardize that process before adding chain classification. Consistent inputs make the later grouping and QA steps much easier to defend.
Quality-Control the Dataset Before Using the Classification
A classification process should be tested before its results are treated as reliable.
Start with a sample rather than immediately trusting every record in a large export.
Review examples from several groups:
Obvious chains. Check whether expected multi-location brands are being classified consistently.
Independent businesses. Confirm that similarly named local companies are not being grouped simply because their names resemble one another.
Sub-brands and departments. Look for legitimate naming or category differences that could split one broader brand family.
Missing-data records. Review records with no website, phone, category, or other important validation field.
Conflicting signals. Flag cases where Chain Info, business name, domain, category, and location patterns disagree.
Document the rule used for each final field. If the dataset contains a normalisierte_Marke column, define what evidence is required before populating it. If there is a confidence or review-status field, define what moves a record from automatic classification to manual review.
It is also useful to preserve the collection date. Google Maps and Business Profile information changes, and Google notes that Place IDs themselves can change over time.
The goal is not to force every record into a brand group.
The goal is to produce a dataset where the classifications can be explained.
A strong final dataset might distinguish:
Confirmed classification — signals agree.
Probable classification — evidence strongly suggests the relationship but one important field is missing.
Manual review — evidence conflicts or remains incomplete.
Unclassified — insufficient evidence.
That is more useful than pretending every record has the same level of certainty.
Identifying chains at scale works best when location identity, chain status, brand grouping, and ownership are treated as separate layers. Outscraper can provide structured Google Maps records and a documented Chain Info enrichment, while the final grouping logic should reflect the level of evidence available rather than making claims the source data cannot support.
Häufig gestellte Fragen
Häufigste Fragen und Antworten
Ein Kettenunternehmen ist im Allgemeinen ein Unternehmen, das unter einer gemeinsamen Marke an mehreren Standorten tätig ist. In einem Google Maps-Datensatz sollte jede Filiale weiterhin als eigener Standortdatensatz erhalten bleiben. Der Status „Kette“ fügt eine übergeordnete Klassifizierung hinzu; er ersetzt nicht die zugrunde liegenden Standortdaten.
Nein. Übereinstimmende Firmennamen können zwar hilfreich sein, sind jedoch für die Einordnung in eine Kette allein nicht zuverlässig genug. Auch Unternehmen, die in keinem Zusammenhang zueinander stehen, können ähnliche Namen haben, während Filialen einer legitimen Kette unterschiedliche Namenskonventionen verwenden können. Kombinieren Sie Namensdaten mit Kategorien, Websites, Telefonnummern, Standorten, Identifikatoren und Anhaltspunkten für die Einordnung in eine Kette.
Die von Nr. Outscraper dokumentierte Ergänzung der Ketteninformationen gibt anhand eines Wahr/Falsch-Werts an, ob ein Unternehmen als Teil einer Kette identifiziert wurde. Dies allein liefert jedoch keine Auskunft über die Muttergesellschaft, den Franchisenehmer, die Unternehmensbeteiligungen, die Rechtsform oder darüber, ob ein einzelner Standort im Besitz des Unternehmens ist oder als Franchise betrieben wird.
Nein. Wenn die Datensätze unterschiedliche physische Standorte darstellen, sollten sie in der Regel als separate Datensätze erhalten bleiben. Bei der Dublettenbereinigung sollten doppelte Datensätze für denselben Standort entfernt werden, nicht jedoch legitime Filialen derselben Kette. Die Gruppierung nach Kette oder Marke sollte als zusätzliche Klassifizierungsebene gespeichert werden.
Nutzen Sie die Optionen zur Duplikatsbereinigung, sofern diese verfügbar sind, insbesondere wenn Sie mehrere geografische Suchanfragen kombinieren. Überprüfen Sie den endgültigen Datensatz vor der Anreicherung oder dem Import in ein anderes System.
Es gibt keine feste Obergrenze – Outscraper ist auf Skalierbarkeit ausgelegt. Sie können alle Bewertungen für einen einzelnen Brancheneintrag erfassen oder Massenaufgaben für Hunderte von Standorten gleichzeitig ausführen. Teams, die Stimmungsanalysen durchführen, greifen häufig auf Zehntausende von Bewertungen aus ganzen Branchen zurück. Die Plattform übernimmt die rechenintensive Arbeit in der Cloud, sodass Ihr Computer während der Ausführung der Aufgabe nicht eingeschaltet bleiben muss.
tart with clean location records, preserve the fields needed for validation, and add chain classification only after the unit of analysis is clear.