Spis treści
Do zidentyfikować sieci sklepów W przypadku danych z Google Maps na dużą skalę należy najpierw rozróżnić dwa odrębne problemy: identyfikację każdej fizycznej lokalizacji oraz ustalenie, czy dana lokalizacja należy do większej sieci. Samo dopasowanie nazw nie wystarczy, ponieważ niepowiązane firmy mogą mieć podobne nazwy, a prawdziwe placówki sieciowe mogą stosować nieco odmienne oznaczenia marki. Niezawodny proces pracy zakłada, że każda lokalizacja jest traktowana jako oddzielny rekord, wykorzystuje stabilne identyfikatory lokalizacji tam, gdzie to możliwe, dodaje klasyfikację sieciową oraz weryfikuje niepewne dopasowania na podstawie wielu sygnałów biznesowych. Niniejszy przewodnik pokazuje, jak zbudować taki proces, nie traktując wykrywania duplikatów, przynależności do sieci i prawnej własności jako tej samej kwestii.
Przed przystąpieniem do klasyfikacji łańcuchów należy zebrać uporządkowane dane z Google Maps, zawierające pola dotyczące lokalizacji, kategorii, strony internetowej, numeru telefonu, adresu oraz identyfikatora, które będą potrzebne do weryfikacji.
Krótka odpowiedź
Aby zidentyfikować firmy należące do sieci w danych Google Maps, należy traktować każdą fizyczną lokalizację jako oddzielny wpis, określić, czy dana firma należy do sieci, oraz zweryfikować niepewne dopasowania na podstawie takich wskazówek, jak nazwa firmy, kategoria, strona internetowa, numer telefonu, adres i wzorce lokalizacji. Nie należy łączyć wpisów wyłącznie na podstawie zbieżności nazw, ani traktować przynależności do sieci jako dowodu wspólnej własności prawnej.
Dlaczego identyfikacja sieci jest trudniejsza niż dopasowywanie nazw firm
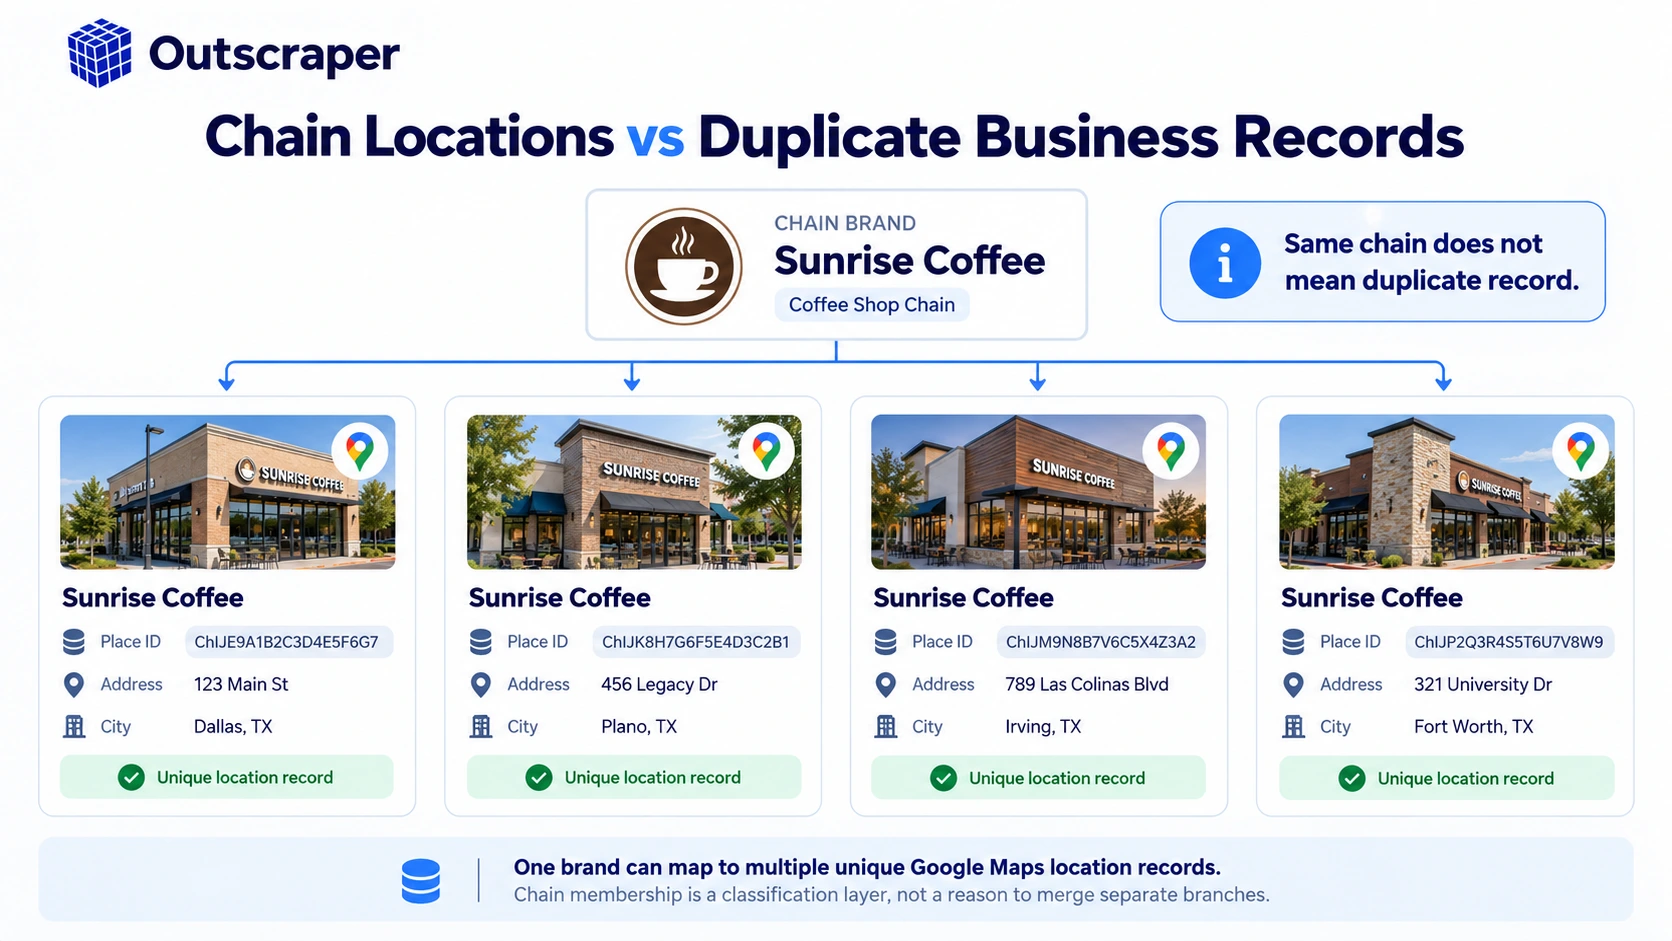
Zbiór danych Google Maps ma zasadniczo charakter lokalizacyjny. Jedna marka posiadająca 150 oddziałów może pojawić się jako 150 odrębnych wpisów, ponieważ każdy oddział stanowi odrębną lokalizację. Jednocześnie dwie niepowiązane ze sobą firmy mogą mieć podobne, a nawet identyczne nazwy.
To prowadzi do istotnego rozróżnienia:
zduplikowany wpis ≠ lokalizacja w łańcuchu ≠ ta sama firma
Załóżmy, że zbiór danych zawiera pięć rekordów o nazwie “Central Coffee”. Rekordy te mogą odnosić się do pięciu oddziałów jednej marki, kilku niepowiązanych ze sobą firm posługujących się tą samą nazwą lub do połączenia obu tych przypadków. Usunięcie czterech rekordów tylko dlatego, że nazwy są identyczne, mogłoby spowodować usunięcie prawidłowych lokalizacji.
Zdarza się również sytuacja odwrotna. Prawdziwa sieć może nie używać wszędzie dokładnie tej samej nazwy widocznej dla użytkowników. Aktualne wytyczne Google dotyczące profili firmowych zasadniczo wymagają spójności nazw i kategorii we wszystkich lokalizacjach sieci, ale dopuszczają również wyjątki w przypadku marek podrzędnych, działów, różnych formatów działalności oraz rzeczywistych różnic w nazewnictwie.
Oznacza to, że spójność nazw stanowi przydatny dowód, ale sama w sobie nie jest wystarczająca.
Przed przystąpieniem do klasyfikacji należy zatem zdefiniować jednostkę analizy. Aktualny przewodnik Outscraper dotyczący Dane firmowe z Google Maps do analizy rynku wprowadza podobne rozróżnienie: w zależności od badanego zagadnienia naukowcy mogą być zmuszeni do zliczania poszczególnych lokalizacji, firm, marek lub obszarów świadczenia usług.
Jeśli chodzi o identyfikację łańcucha, najbezpieczniejszym punktem wyjścia jest:
jedna prawidłowa lokalizacja fizyczna = jeden rekord na poziomie lokalizacji
Następnie dodaj przynależność do łańcucha jako kolejną warstwę.
Zacznij od jednego wpisu na każdą lokalizację w Google Maps
Zanim zdecydujesz, czy dana firma należy do sieci, upewnij się, że zbiór danych pozwala w sposób wiarygodny odróżnić jedną lokalizację od drugiej.
Nazwa firmy nie jest dobrym podstawowym identyfikatorem, ponieważ nie ma gwarancji, że nazwy są niepowtarzalne. Adres jest pomocny, ale różnice w formatowaniu mogą powodować fałszywe niedopasowania. Numery telefonów i strony internetowe są przydatne, ale mogą być również udostępniane lub brakować.
Identyfikator Google Place ID jest bardziej miarodajnym polem dotyczącym lokalizacji, ponieważ firma Google opisuje identyfikatory Place ID jako identyfikatory miejsc w swojej bazie danych Places. Google zwraca również uwagę na dwa istotne ograniczenia: to samo miejsce może czasami posiadać wiele identyfikatorów Place ID, a identyfikatory te mogą ulegać zmianom w miarę upływu czasu. Firma Google zaleca aktualizację zapisanych identyfikatorów, które mają ponad 12 miesięcy.
W tym procesie identyfikator miejsca (Place ID) należy zatem traktować jako silny identyfikator lokalizacji, a nie jako trwały identyfikator korporacyjny.
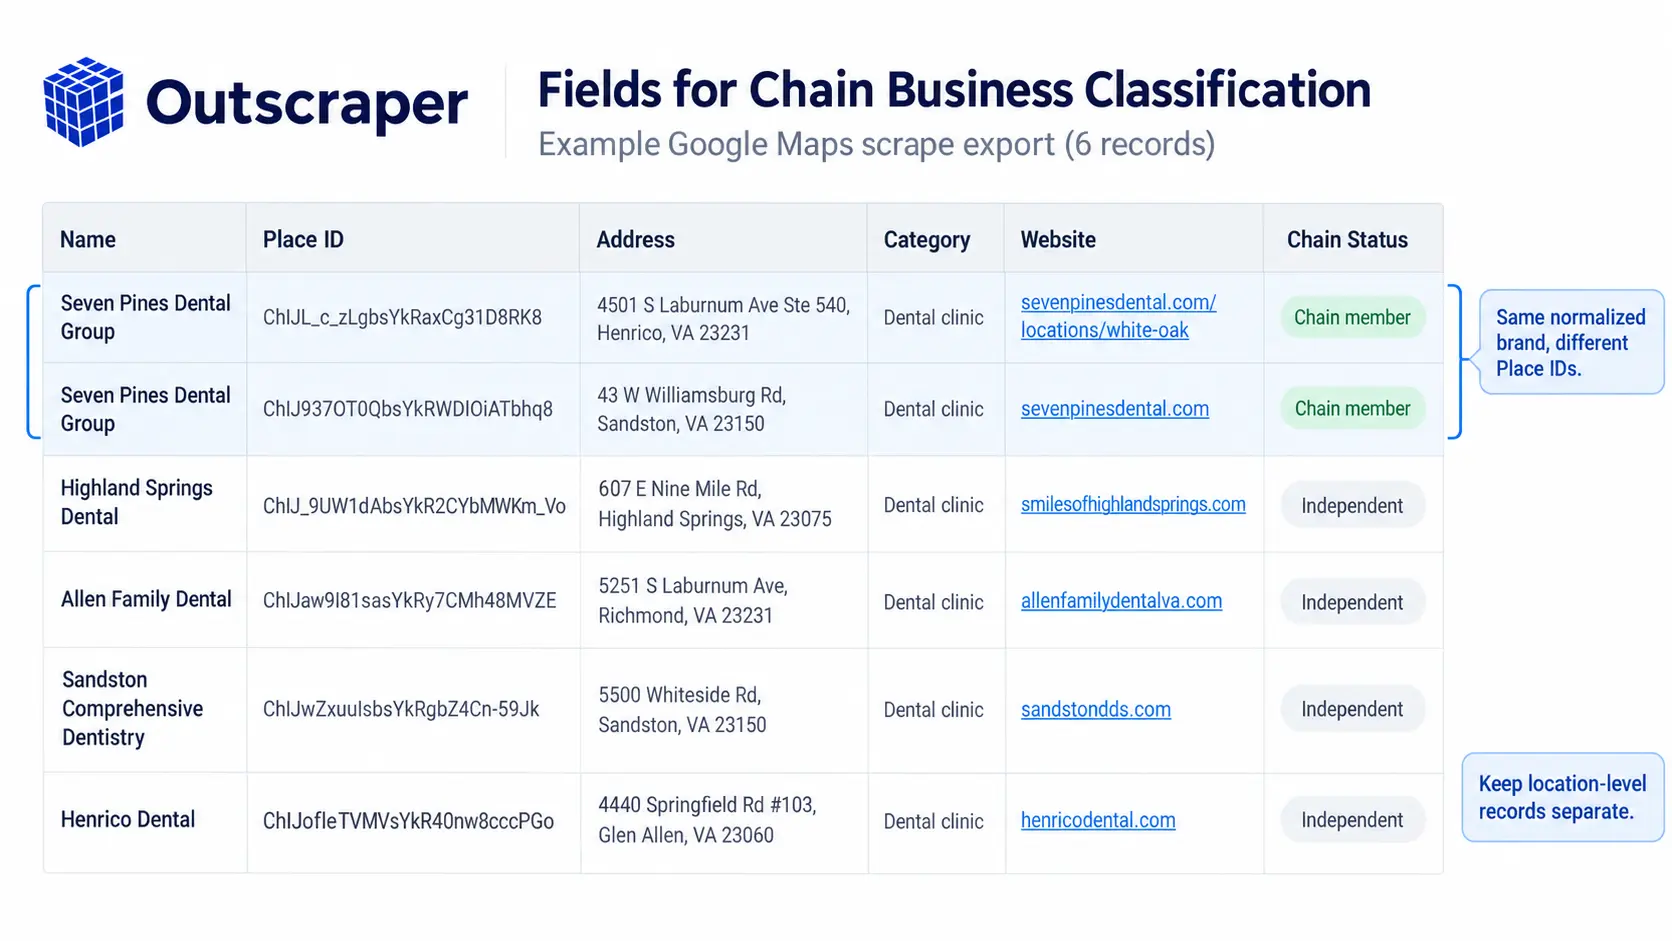
Praktyczny zbiór danych na poziomie lokalizacji powinien zawierać takie pola, jak:
| Pole | Rola w procesie roboczym |
|---|---|
| Identyfikator miejsca | Wyróżnia poszczególne miejsca |
| Nazwa firmy | Dostarcza dowodów dotyczących marki/nazwy |
| Adres | Potwierdza fizyczną lokalizację |
| Kategoria | Pomaga porównać rodzaje działalności |
| Strona internetowa | Obsługuje dopasowywanie marek/domen |
| Telefon | Dodaje kolejny sygnał identyfikacyjny |
| Współrzędne | Potwierdza rozdzielenie geograficzne |
| Stan łańcucha | Dodaje klasyfikację „łańcuchowa”/„niełańcuchowa” |
Jeśli dane źródłowe nadal zawierają powtarzające się wyniki wyszukiwania dla tej samej lokalizacji, przed przystąpieniem do grupowania marek należy usunąć faktycznie powtarzające się rekordy dotyczące tej lokalizacji. Jest to operacja inna niż usuwanie wielu oddziałów tej samej sieci.
Przed podjęciem próby pogrupowania marek należy skorzystać z klasyfikacji łańcuchowej
Gdy każda lokalizacja zostanie już prawidłowo zarejestrowana, kolejnym pytaniem jest to, czy dana firma należy do sieci.
W aktualnej dokumentacji API serwisu Outscraper wymieniono Informacje o łańcuchu wzbogacenie w ramach parametru ai_chain_info. W dokumentacji opisano to jako sprawdzanie, czy dana firma należy do sieci, oraz dodanie wskazanie „prawda/fałsz” do zwróconych danych.
Jest to przydatne, ponieważ pozwala oddzielić dwa zadania, które często są ze sobą mieszane:
Zadanie 1: Czy ta firma należy do sieci?
Zadanie 2: Z jaką konkretnie marką, spółką macierzystą, siecią franczyzową lub podmiotem prawnym należy powiązać ten lokal?
Serwis Chain Info potwierdza pierwszą tezę. W obecnej dokumentacji nie ma wzmianki o tym, że serwis ten automatycznie podaje zweryfikowane dane dotyczące spółki macierzystej, tożsamości franczyzobiorcy, struktury własnościowej ani pełnej liczby lokalizacji na całym świecie.
Ta granica ma znaczenie.
A prawda Wartość łańcucha należy traktować jako sygnał klasyfikacyjny. Nie należy jej przekształcać w niepoparte dowodami twierdzenia dotyczące własności.
Na przykład:
| Rekord | Stan łańcucha | Co można powiedzieć |
|---|---|---|
| Firma A — Lokalizacja 1 | Prawda | Zaklasyfikowane jako część sieci |
| Biznes B | Nieprawda | Nie zaliczane do sieci |
| Dział C — Lokalizacja 2 | Prawda | Zaklasyfikowane jako część sieci |
Na podstawie samego tego pola logicznego nadal nie można ustalić, czy lokalizacja nr 1 jest własnością firmy, działa na zasadzie franczyzy, posiada licencję, jest zarządzana przez spółkę zależną, czy też jest powiązana z konkretnym podmiotem prawnym.
W tym miejscu walidacja i grupowanie encji stają się odrębnymi etapami.
Dodaj klasyfikację łańcuchową do rekordów ustrukturyzowanych
Jeśli w Twoim przepływie pracy wykorzystywany jest interfejs API Outscraper, przed zaprojektowaniem potoku klasyfikacyjnego zapoznaj się z aktualnymi parametrami wzbogacania danych.
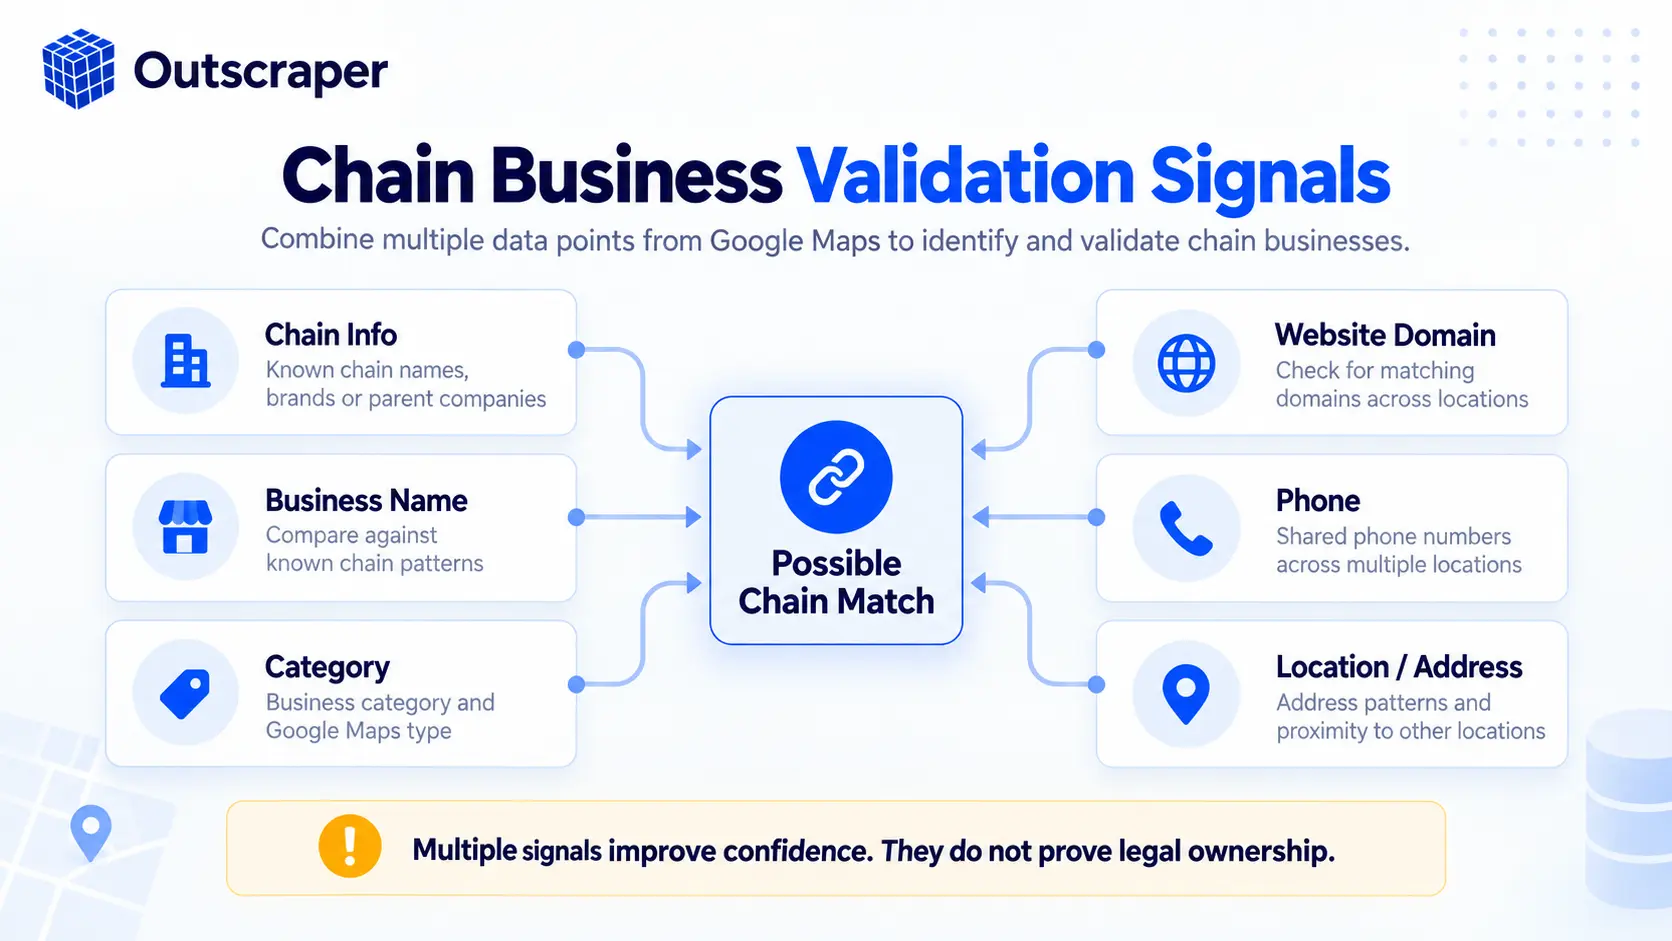
Weryfikacja zgodności łańcuchów przy użyciu wielu sygnałów biznesowych
Zautomatyzowana klasyfikacja ułatwia zarządzanie dużymi zbiorami danych, jednak rekordy budzące wątpliwości lub o dużej wartości mogą nadal wymagać weryfikacji.
Najskuteczniejsza metoda polega na wykorzystaniu kilku sygnałów jednocześnie, a nie na traktowaniu jednego pola jako decydującego.
Spójność nazw i kategorii
Zacznij od nazwy firmy i głównej kategorii.
Zgodnie z wytycznymi Google placówki należące do sieci powinny zasadniczo stosować spójne nazwy i kategorie, jeśli świadczą te same usługi. W tych samych wytycznych odnotowano również wyjątki dotyczące marek podrzędnych, działów, różnych formatów działalności oraz rzeczywistych różnic w nazewnictwie.
Wynikają z tego dwie przydatne zasady:
Spójna nazwa + spójna kategoria zwiększają prawdopodobieństwo dopasowania w łańcuchu.
Inna nazwa nie wyklucza automatycznie istnienia powiązania w łańcuchu.
Marka może prowadzić działalność w wielu formatach, które różnią się między sobą nazwami wynikającymi z uzasadnionych przyczyn.
Sygnały związane ze stroną internetową i kontaktem
Strony internetowe mogą poprawić dopasowanie, gdy wiele lokalizacji korzysta z tej samej domeny firmowej lub gdy strony poświęcone poszczególnym lokalizacjom znajdują się w ramach tej samej domeny.
Niemniej jednak zgodność domeny należy nadal traktować jako dowód pomocniczy.
Punkt franczyzowy może prowadzić własną lokalną stronę internetową. Firma może przekierowywać wiele domen na jedną stronę marki. Różne firmy mogą również korzystać ze wspólnych domen serwisów handlowych lub rezerwacyjnych, które nie ujawniają zbyt wielu informacji na temat właściciela.
Podobne ograniczenia dotyczą danych telefonicznych. Niektóre sieci korzystają z lokalnych numerów dla każdego oddziału, podczas gdy inne obsługują kilka lokalizacji za pośrednictwem jednego, scentralizowanego numeru.
Tożsamość lokalna i wzorce geograficzne
Adresy i współrzędne pozwalają potwierdzić, że rekordy odnoszą się do różnych fizycznych lokalizacji, a nie stanowią zduplikowanych eksportów.
Powtarzalność geograficzna może również ujawniać przewidywalny wzorzec łańcuchowy: tę samą lub podobną tożsamość biznesową powtarzającą się w kilku miastach lub regionach.
Jednak skala geograficzna nie stanowi dowodu własności. Sieć licencyjna, system franczyzowy, spółdzielnia lub niepowiązane ze sobą przedsiębiorstwa o podobnych nazwach mogą tworzyć wzorce, które na pierwszy rzut oka wydają się podobne.
Zatem prawidłową regułą walidacji jest:
Wykorzystaj wiele źródeł informacji, aby zwiększyć pewność; nie traktuj danych z jednego źródła jako dowodu prawnego.
Oddzielenie przynależności do sieci od marki i własności
Jest to ten aspekt identyfikacji łańcucha, który najłatwiej jest nadmiernie uprościć.
Firma może należeć do rozpoznawalnej sieci, nawet jeśli nie wszystkie jej placówki mają tego samego właściciela prawnego.
Systemy franczyzowe stanowią tu oczywisty przykład. Kilka placówek może posługiwać się tą samą marką, modelem działania i wizerunkiem wobec klientów, a jednocześnie być prowadzonych przez odrębnych franczyzobiorców.
Marki podrzędne stwarzają kolejny problem. Google wyraźnie zezwala niektórym placówkom sieciowym na stosowanie różnych nazw w świecie rzeczywistym dla odrębnych formatów działalności i marek podrzędnych.
Nawet dwie marki działające pod tym samym adresem niekoniecznie stanowią jeden wpis. Zgodnie z wytycznymi Google dotyczącymi profili firmowych niezależnie działające marki w tej samej lokalizacji mogą mieć oddzielne profile.
W przypadku pracy z danymi należy rozróżniać następujące pojęcia:
| Warstwa danych | Pytanie |
|---|---|
| Tożsamość miejsca | Czy jest to odrębny wpis dotyczący obiektu fizycznego lub miejsca? |
| Klasyfikacja łańcuchów | Czy firma jest zaliczana do sieci? |
| Grupowanie marek | Czy wydaje się, że kilka podmiotów działa pod tą samą tożsamością marki? |
| Właściciel prawny | Który podmiot prawny jest właścicielem tej lokalizacji lub ją prowadzi? |
Dane z Google Maps mogą stanowić dobre uzupełnienie pierwszych warstw. W celu ustalenia praw własności mogą być potrzebne dodatkowe dokumenty korporacyjne, informacje dotyczące franczyzy, dane firmowe, informacje własne lub inne wiarygodne źródła.
Takie rozdzielenie chroni również zbiór danych przed fałszywą precyzją.
Zamiast pisać:
“Te 47 lokalizacji należy do firmy X.”
jeżeli nie zweryfikowano prawa własności, należy zastosować węższy wniosek:
“Te 47 rekordów zostało sklasyfikowanych lub pogrupowanych jako lokalizacje powiązane z firmą Brand X na podstawie dostępnych sygnałów biznesowych”.”
To stwierdzenie jest łatwiejsze do uzasadnienia.
Skalowanie klasyfikacji w dużym zbiorze danych z Google Maps
Ręczna weryfikacja może sprawdzić się w przypadku 20 firm. Staje się jednak niespójna, gdy zbiór danych obejmuje tysiące lokalizacji.
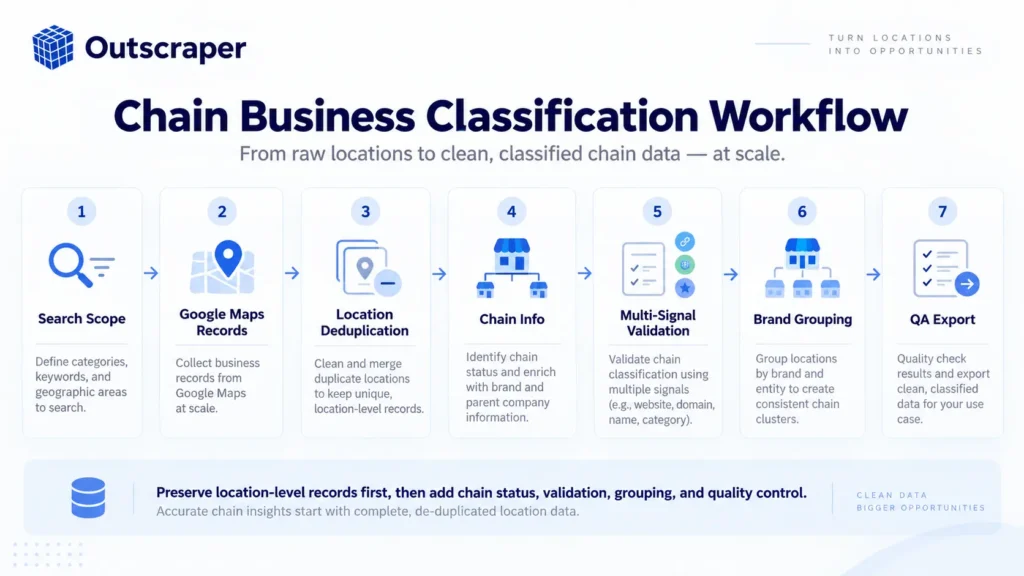
W szerszej perspektywie proces ten powinien stać się powtarzalnym łańcuchem operacji.
W praktyce proces ten wygląda następująco:
Określ zakres kolekcji. Przed rozpoczęciem zbierania danych należy określić kategorie branżowe, kraje, miasta lub inne granice geograficzne.
Zbierz jeden wpis dotyczący danej lokalizacji dla każdego miejsca. Zachowaj identyfikator miejsca, adres, nazwę, kategorię, stronę internetową, numer telefonu i współrzędne.
Usuń rzeczywiste zduplikowane rekordy dotyczące miejsc. Usuń zduplikowane eksporty tej samej lokalizacji bez zwijania prawidłowych gałęzi łańcucha.
Dodaj klasyfikację łańcuchową. Zastosuj „Chain Info” lub inną zdefiniowaną metodę klasyfikacji.
Znormalizuj pola w celu porównania. W razie potrzeby ujednolicaj nazwy firm, domeny, format numerów telefonów, kategorie i adresy.
Utwórz pola grupujące na poziomie marki. Należy przechowywać je oddzielnie od oryginalnych danych dotyczących lokalizacji.
Oznaczaj niejednoznaczne wpisy. W przypadku wyników sprzecznych lub niekompletnych należy skierować je do ręcznej weryfikacji, zamiast wymuszać klasyfikację.
Zachować kolumny dowodowe. Zachowaj wystarczającą liczbę pól źródłowych, aby później móc wyjaśnić, dlaczego dany rekord został zgrupowany lub odrzucony.
Wynik może zawierać takie pola, jak:
| place_id | nazwa | kategoria | strona internetowa | stan_łańcucha | normalizowana_marka | status_recenzji |
|---|---|---|---|---|---|---|
| ID-A | Marka A w centrum miasta | Restauracja | marka-a.przykład | Prawda | Marka A | Potwierdzono |
| ID-B | Marka A North | Restauracja | marka-a.przykład | Prawda | Marka A | Potwierdzono |
| ID-C | Usługi marki A | Konsultant | inny przykład | Fałszywe/Recenzja | — | Ręczna weryfikacja |
Dokładny schemat może ulec zmianie, ale zasada powinna pozostać ta sama:
nigdy nie należy zastępować podstawowych dowodów na poziomie lokalizacji tylko po to, by ułatwić grupowanie.
Jeśli etap gromadzenia danych nadal odbywa się ręcznie, należy ujednolicić ten proces przed wprowadzeniem klasyfikacji łańcuchowej. Spójne dane wejściowe znacznie ułatwiają uzasadnienie późniejszych etapów grupowania i kontroli jakości.
Przed zastosowaniem klasyfikacji należy przeprowadzić kontrolę jakości zbioru danych
Proces klasyfikacji należy poddać testom, zanim jego wyniki uznaje się za wiarygodne.
Zacznij od próbki, zamiast od razu ufać wszystkim rekordom z dużego pliku eksportowego.
Przykłady recenzji z kilku grup:
Oczywiste powiązania. Sprawdź, czy marki prowadzące działalność w wielu lokalizacjach są klasyfikowane w spójny sposób.
Niezależne przedsiębiorstwa. Należy upewnić się, że lokalne firmy o podobnych nazwach nie są grupowane wyłącznie ze względu na podobieństwo ich nazw.
Marki podrzędne i działy. Należy zwrócić uwagę na uzasadnione różnice w nazewnictwie lub kategoriach, które mogłyby doprowadzić do podziału jednej, szerszej rodziny marek.
Rekordy z brakującymi danymi. Przejrzyj wpisy, w których brakuje adresu strony internetowej, numeru telefonu, kategorii lub innych istotnych pól weryfikacyjnych.
Sprzeczne sygnały. Należy zgłaszać przypadki, w których dane dotyczące łańcucha, nazwa firmy, domena, kategoria i wzorce lokalizacji są ze sobą niezgodne.
Należy opisać regułę zastosowaną dla każdego pola końcowego. Jeśli zbiór danych zawiera normalizowana_marka W kolumnie tej należy określić, jakie dane są wymagane przed jej wypełnieniem. Jeśli istnieje pole dotyczące poziomu pewności lub statusu weryfikacji, należy określić, co powoduje przeniesienie rekordu z klasyfikacji automatycznej do weryfikacji ręcznej.
Warto również zachować datę dodania wpisu. Informacje w Google Maps i w profilu firmowym ulegają zmianom, a firma Google zwraca uwagę, że same identyfikatory miejsc (Place ID) mogą się z czasem zmieniać.
Celem nie jest przypisywanie każdego wpisu do konkretnej grupy marek.
Celem jest stworzenie zbioru danych, w którym klasyfikacje da się wyjaśnić.
Solidny ostateczny zbiór danych mógłby pozwolić na rozróżnienie:
Potwierdzona klasyfikacja — sygnały są zgodne.
Prawdopodobna klasyfikacja — dowody wyraźnie wskazują na istnienie takiego związku, ale brakuje tu jednego ważnego obszaru badań.
Ręczna weryfikacja — dowody są sprzeczne lub niekompletne.
Niesklasyfikowane — niewystarczające dowody.
To jest bardziej przydatne niż udawanie, że każdy zapis charakteryzuje się takim samym stopniem pewności.
Identyfikacja sieci na dużą skalę przebiega najskuteczniej, gdy tożsamość lokalizacji, status sieci, grupowanie marek i struktura własnościowa są traktowane jako odrębne warstwy. Outscraper może dostarczyć ustrukturyzowane rekordy z Google Maps oraz udokumentowane uzupełnienie danych o informacje dotyczące sieci, natomiast ostateczna logika grupowania powinna odzwierciedlać poziom dostępnych dowodów, a nie formułować twierdzenia, których dane źródłowe nie są w stanie potwierdzić.
Najczęściej zadawane pytania
Najczęściej zadawane pytania i odpowiedzi
Sieć handlowa to zazwyczaj firma działająca pod wspólną marką w wielu lokalizacjach. W zbiorze danych Google Maps każdy oddział powinien nadal być traktowany jako odrębny rekord lokalizacji. Status sieci stanowi klasyfikację wyższego rzędu; nie zastępuje on podstawowych danych dotyczących lokalizacji.
Nie. Zbieżność nazw firm może być przydatna, ale same nazwy nie są wystarczająco wiarygodne, by służyć do klasyfikacji sieci. Niezwiązane ze sobą firmy mogą mieć podobne nazwy, a legalne placówki sieci mogą stosować różne formaty nazewnictwa. Należy połączyć dane dotyczące nazw z kategoriami, stronami internetowymi, danymi kontaktowymi, lokalizacjami, identyfikatorami oraz sygnałami wskazującymi na przynależność do sieci.
Udokumentowane wzbogacenie danych „Chain Info” w bazie nr Outscraper wskazuje, czy dana firma została zidentyfikowana jako część sieci, przy użyciu wartości „prawda” lub „fałsz”. Samo to nie pozwala ustalić, czy chodzi o spółkę macierzystą, franczyzobiorcę, strukturę własnościową, podmiot prawny, ani też czy dana placówka jest własnością korporacji, czy też działa na zasadzie franczyzy.
Nie. Jeśli rekordy odnoszą się do odrębnych lokalizacji fizycznych, powinny zazwyczaj pozostać odrębnymi rekordami. Proces deduplikacji powinien usuwać powtarzające się rekordy dotyczące tego samego miejsca, a nie prawidłowe oddziały tej samej sieci. Grupowanie według sieci lub marki powinno być przechowywane jako dodatkowa warstwa klasyfikacji.
W miarę możliwości należy korzystać z opcji usuwania duplikatów, zwłaszcza w przypadku łączenia wielu wyszukiwań geograficznych. Przed wzbogaceniem danych lub zaimportowaniem ich do innego systemu należy zweryfikować ostateczny zbiór danych.
Nie ma sztywnego limitu – platforma Outscraper została zaprojektowana z myślą o skalowalności. Możesz gromadzić wszystkie recenzje dotyczące pojedynczego wpisu firmowego lub wykonywać zadania zbiorcze obejmujące setki lokalizacji jednocześnie. Zespoły zajmujące się analizą nastrojów często pobierają dziesiątki tysięcy recenzji z całych branż. Platforma wykonuje najtrudniejsze zadania w chmurze, więc Twój komputer nie musi pozostawać włączony podczas wykonywania zadania.
należy zacząć od czystych rekordów lokalizacji, zachować pola niezbędne do walidacji oraz dodać klasyfikację łańcuchową dopiero po ustaleniu jednostki analizy.