Inhoudsopgave
Aan ketenbedrijven identificeren Bij het verwerken van Google Maps-gegevens op grote schaal moet je eerst twee verschillende problemen van elkaar scheiden: het identificeren van elke fysieke locatie en het vaststellen of die locatie tot een grotere keten behoort. Het vergelijken van namen alleen is niet voldoende, omdat niet-gerelateerde bedrijven vergelijkbare namen kunnen hebben, terwijl echte vestigingen van een keten mogelijk een iets andere huisstijl hanteren. Een betrouwbare workflow houdt elke locatie als een afzonderlijk record bij, maakt waar mogelijk gebruik van stabiele locatie-identificatoren, voegt een ketenclassificatie toe en valideert onzekere overeenkomsten aan de hand van meerdere bedrijfsindicatoren. Deze handleiding laat zien hoe je dat proces kunt opzetten zonder het opsporen van duplicaten, het lidmaatschap van een keten en het juridische eigendom als één en hetzelfde te beschouwen.
Voordat je de ketens classificeert, verzamel je gestructureerde Google Maps-gegevens met de velden voor locatie, categorie, website, telefoonnummer, adres en identificatiecode die je nodig hebt voor de validatie.
Kort antwoord
Om ketenbedrijven in de gegevens van Google Maps te identificeren, moet je elke fysieke locatie als een afzonderlijk record aanmerken, aangeven of het bedrijf tot een keten behoort en onduidelijke overeenkomsten valideren aan de hand van signalen zoals bedrijfsnaam, categorie, website, telefoonnummer, adres en locatiepatronen. Voeg records niet samen louter omdat de namen overeenkomen, en beschouw het lidmaatschap van een keten niet als bewijs van gemeenschappelijk juridisch eigendom.
Waarom het identificeren van ketens moeilijker is dan het vergelijken van bedrijfsnamen
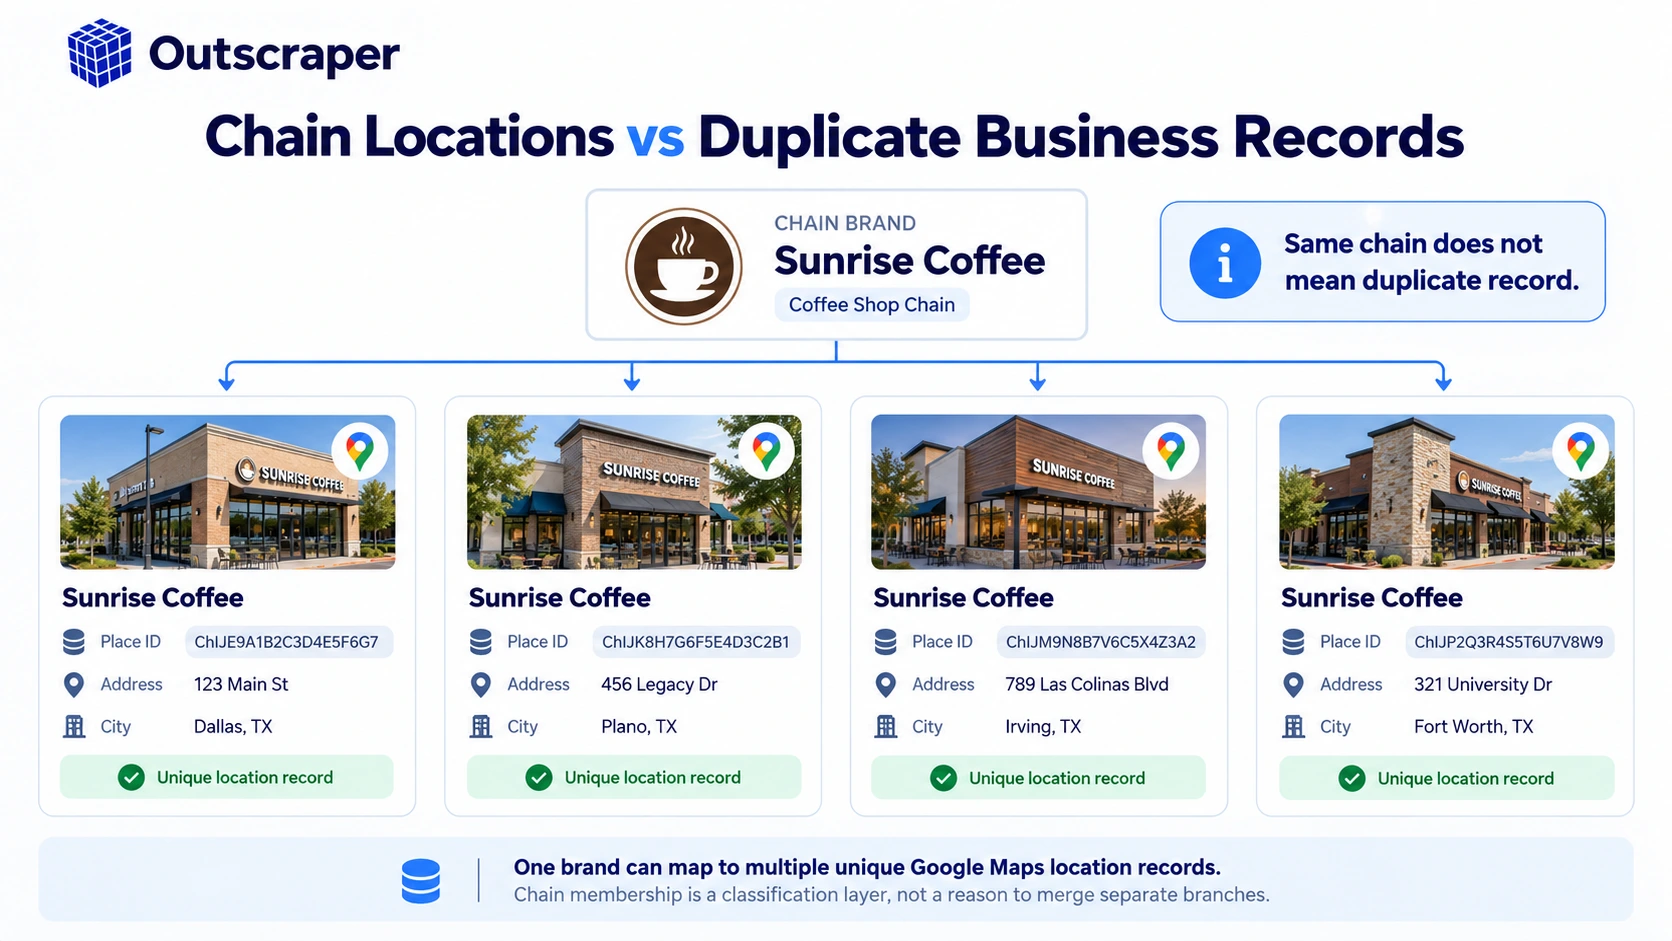
Een dataset van Google Maps is in wezen locatiegericht. Eén merk met 150 vestigingen kan als 150 afzonderlijke vermeldingen worden weergegeven, omdat elke vestiging een aparte locatie vertegenwoordigt. Tegelijkertijd kunnen twee bedrijven die geen verband met elkaar houden, vergelijkbare of zelfs identieke namen hebben.
Dat leidt tot een belangrijk onderscheid:
dubbel record ≠ locatie in de keten ≠ hetzelfde bedrijf
Stel dat een dataset vijf records bevat met de naam “Central Coffee”. Die records kunnen verwijzen naar vijf vestigingen van één merk, naar verschillende, onderling niet-gerelateerde bedrijven die dezelfde naam gebruiken, of naar een combinatie van beide. Als je vier records verwijdert omdat de namen overeenkomen, kunnen daardoor geldige locaties verdwijnen.
Het tegenovergestelde probleem doet zich ook voor. Een echte keten gebruikt mogelijk niet overal precies dezelfde zichtbare naam. In de huidige richtlijnen van Google voor Bedrijfsprofielen wordt over het algemeen gevraagd om consistente namen en categorieën voor alle vestigingen van de keten, maar er wordt ook ruimte gelaten voor uitzonderingen voor submerken, afdelingen, verschillende bedrijfsformules en variaties in de naamgeving in de praktijk.
Dat betekent dat consistentie in de naam een nuttig aanwijzing is, maar op zichzelf geen voldoende bewijs vormt.
De analyse-eenheid moet daarom vóór de classificatie worden vastgesteld. De huidige handleiding van Outscraper voor Bedrijfsgegevens uit Google Maps voor marktanalyse maakt een soortgelijk onderscheid: afhankelijk van de onderzoeksvraag kan het nodig zijn dat onderzoekers afzonderlijke locaties, bedrijven, merken of servicegebieden tellen.
Voor het identificeren van kettingen is het veiligste uitgangspunt:
één geldige fysieke locatie = één record op locatieniveau
Voeg vervolgens het lidmaatschap van de keten toe als een extra laag.
Begin met één record per locatie op Google Maps
Voordat je besluit of een bedrijf tot een keten behoort, moet je ervoor zorgen dat de dataset de verschillende vestigingen op betrouwbare wijze van elkaar kan onderscheiden.
Een bedrijfsnaam is geen goede primaire identificatie, omdat namen niet per se uniek zijn. Het adres helpt wel, maar verschillen in de notatie kunnen tot valse overeenkomsten leiden. Telefoonnummers en websites zijn nuttig, maar deze kunnen ook door anderen worden gebruikt of ontbreken.
Google Place ID is een betrouwbaarder veld op locatieniveau, omdat Google Place ID’s omschrijft als identificatiecodes voor locaties in zijn Places-database. Google wijst ook op twee belangrijke beperkingen: dezelfde locatie kan soms meerdere Place ID’s hebben, en Place ID’s kunnen in de loop van de tijd veranderen. Google raadt aan om opgeslagen ID’s die ouder zijn dan 12 maanden te vernieuwen.
Voor deze workflow moet de Place ID daarom worden beschouwd als een sterke locatie-identificatie – en niet als een permanente bedrijfsidentificatie.
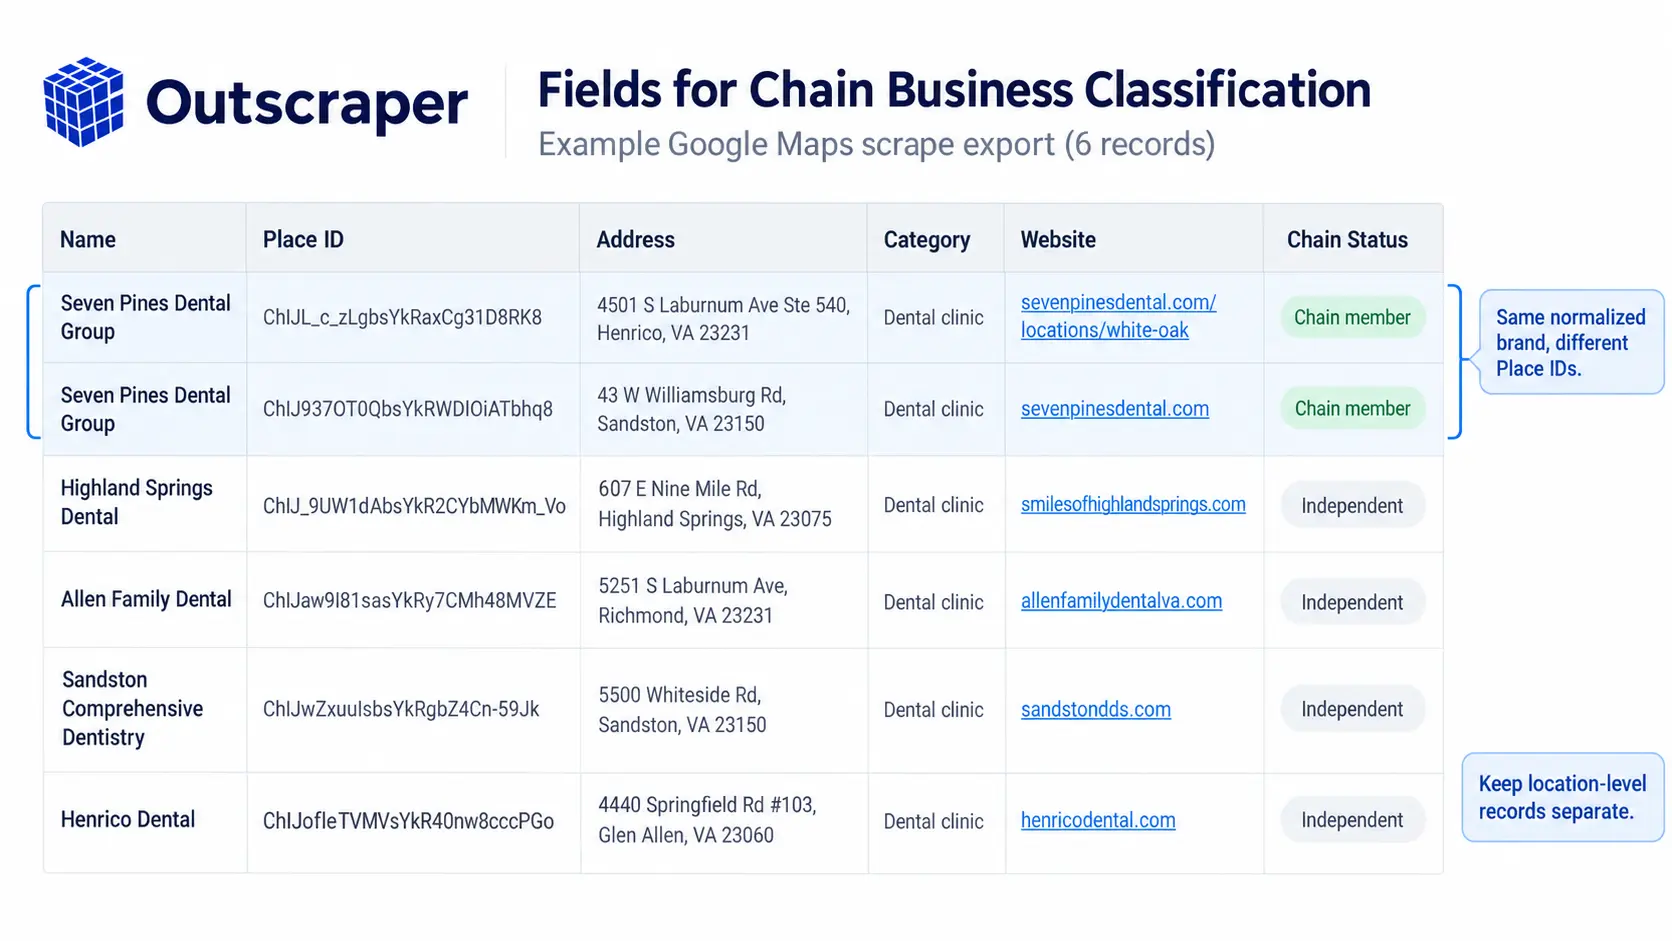
Een praktische dataset op locatieniveau moet velden bevatten zoals:
| Veld | Rol in de workflow |
|---|---|
| Plaats ID | Maakt onderscheid tussen afzonderlijke plaatsen |
| Bedrijfsnaam | Levert bewijs van het merk/de naam |
| Adres | Bevestigt de fysieke locatie |
| Categorie | Helpt bij het vergelijken van bedrijfstypen |
| Website | Ondersteunt het koppelen van merken en domeinen |
| Telefoon | Voegt nog een identiteitssignaal toe |
| Coördinaten | Bevestigt de geografische scheiding |
| Status van de keten | Voegt de indeling in ‘met ketting’ en ‘zonder ketting’ toe |
Als je ruwe gegevens nog steeds herhaalde zoekresultaten voor dezelfde locatie bevatten, verwijder dan de daadwerkelijk dubbele locatiegegevens voordat je probeert merken te groeperen. Dit is iets anders dan het verwijderen van meerdere vestigingen van dezelfde keten.
Gebruik de ketenclassificatie voordat je probeert merken te groeperen
Zodra elke locatie correct is vastgelegd, is de volgende vraag of het bedrijf deel uitmaakt van een keten.
In de huidige API-documentatie van Outscraper staan de Informatie over de ketting verrijking onder de parameter ai_chain_info. In de documentatie wordt beschreven dat hiermee wordt vastgesteld of een bedrijf deel uitmaakt van een keten en dat er een weergave van waar/onwaar aan de geretourneerde gegevens.
Dat is handig omdat het twee taken van elkaar scheidt die vaak door elkaar worden gehaald:
Opdracht 1: Maakt dit bedrijf deel uit van een keten?
Task 2: Which exact brand, parent company, franchise system, or legal entity should this location be associated with?
Chain Info supports the first question. The current documentation does not state that it automatically supplies a verified parent company, franchisee identity, legal ownership structure, or complete global location count.
That boundary matters.
A waar chain value should be treated as a classification signal. It should not be converted into unsupported claims about ownership.
Bijvoorbeeld:
| Record | Status van de keten | What you can say |
|---|---|---|
| Business A — Location 1 | True | Classified as part of a chain |
| Business B | False | Not classified as part of a chain |
| Business C — Location 2 | True | Classified as part of a chain |
What you still cannot determine from that boolean field alone is whether Location 1 is corporate-owned, franchised, licensed, operated by a subsidiary, or connected to a particular legal entity.
This is where validation and entity grouping become separate steps.
Add chain classification to structured records
If your workflow uses the Outscraper API, review the current enrichment parameters before designing the classification pipeline.
Validate Chain Matches With Multiple Business Signals
Automated classification makes large datasets manageable, but uncertain or high-value records may still need validation.
The strongest process uses several signals together rather than treating one field as definitive.
Name and category consistency
Start with the business name and primary category.
Google’s guidelines say chain locations should generally use consistent names and categories when they provide the same service. The same guidance also documents exceptions for sub-brands, departments, different operational formats, and real-world naming variations.
That produces two useful rules:
Consistent name + consistent category strengthens a possible chain match.
Different name does not automatically disprove a chain relationship.
A brand may operate multiple formats with legitimate naming differences.
Website and contact signals
Websites can strengthen a match when multiple locations use the same corporate domain or location pages underneath the same domain.
However, domain matching should still be treated as supporting evidence.
A franchise location may operate its own local website. A business can redirect multiple domains into one brand site. Different businesses can also use common marketplace or booking domains that reveal little about ownership.
Phone data has similar limitations. Some chains use local numbers for every branch, while others route several locations through a centralized number.
Location identity and geographic patterns
Addresses and coordinates help confirm that records represent different physical locations rather than duplicate exports.
Geographic repetition can also reveal an expected chain pattern: the same or similar business identity repeated across several cities or regions.
But geographic scale is not proof of ownership. A licensing network, franchise system, cooperative, or unrelated businesses with similar naming can produce superficially similar patterns.
A strong validation rule is therefore:
Use multiple signals to increase confidence; do not use one field as legal proof.
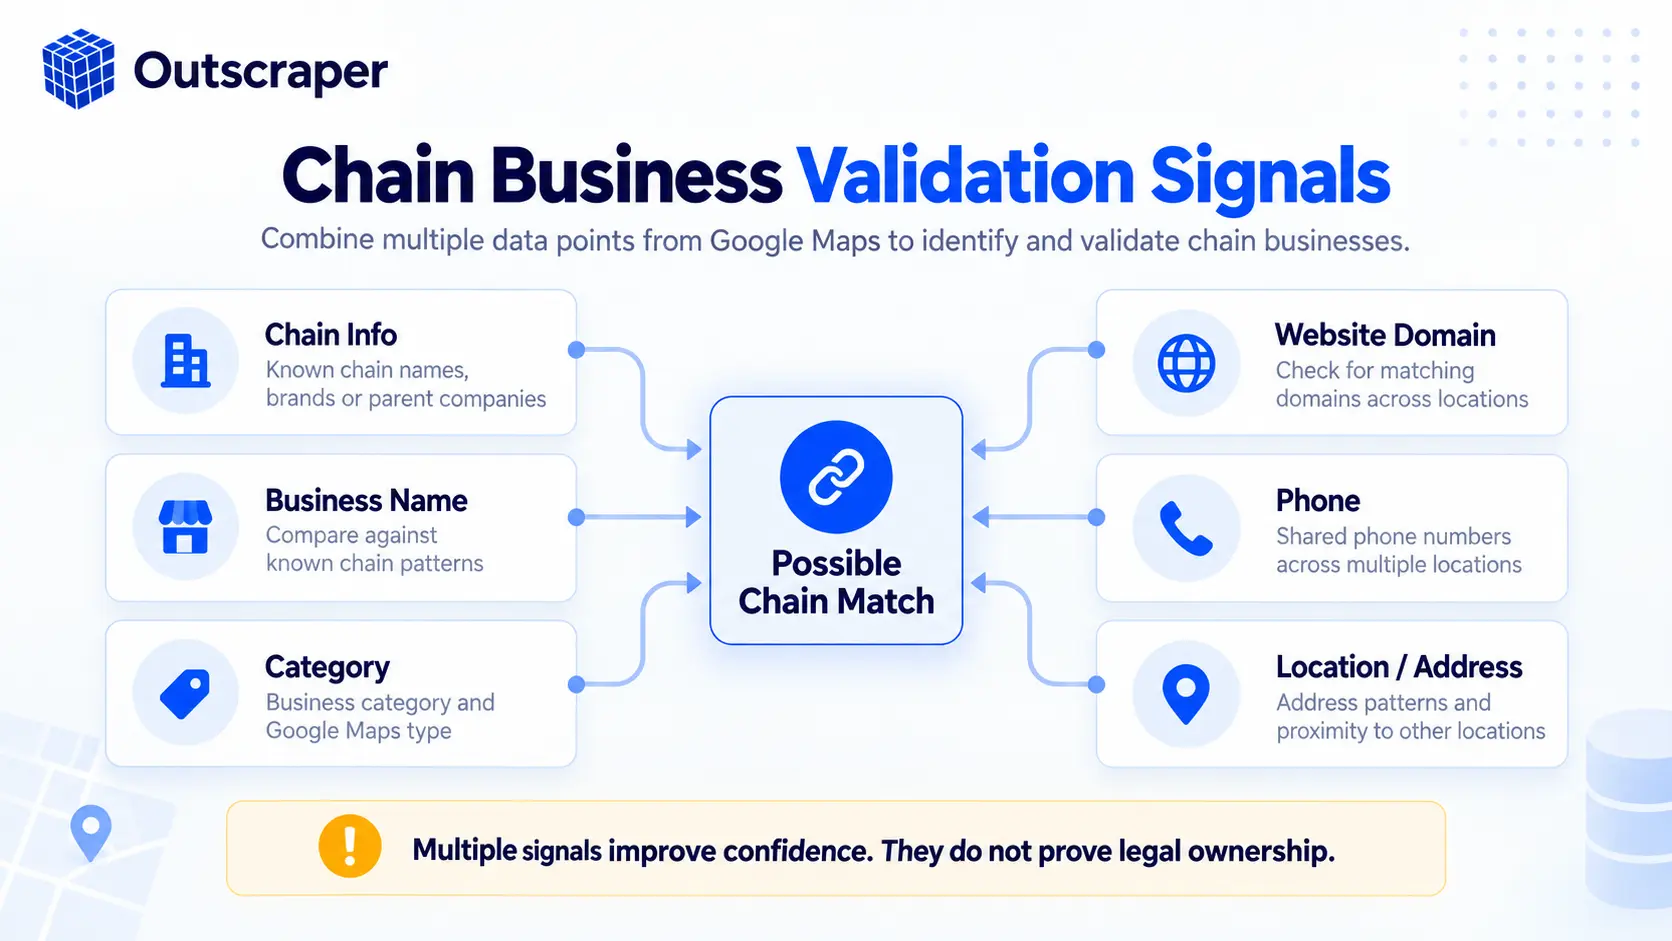
Separate Chain Membership From Brand and Ownership
This is the part of chain identification that is easiest to oversimplify.
A business can be part of a recognizable chain without every location having the same legal owner.
Franchise systems are the obvious example. Several locations may share a brand, operating model, and customer-facing identity while being operated by separate franchisees.
Sub-brands create another problem. Google explicitly allows certain chain locations to use different real-world names for distinct business formats and sub-brands.
Even two brands operating from the same address do not necessarily represent one record. Google’s Business Profile guidance says independently operating brands at the same location may have separate profiles.
For data work, keep these concepts separate:
| Data layer | Question |
|---|---|
| Location identity | Is this a distinct physical/place record? |
| Chain classification | Is the business classified as part of a chain? |
| Brand grouping | Do several records appear to operate under the same brand identity? |
| Legal ownership | Which legal entity owns or operates the location? |
Google Maps data can support the first layers well. Legal ownership may require additional corporate records, franchise disclosures, company data, first-party information, or other authoritative sources.
This separation also protects the dataset from false precision.
Instead of writing:
“These 47 locations are owned by Company X.”
when ownership has not been verified, use the narrower conclusion:
“These 47 records were classified or grouped as locations associated with Brand X based on the available business signals.”
That is a more defensible statement.
Scale the Classification Across a Large Google Maps Dataset
Manual review can work for 20 businesses. It becomes inconsistent when the dataset contains thousands of locations.
At scale, the process should become a repeatable pipeline.
A practical workflow looks like this:
Define the collection scope. Set the business categories, countries, cities, or other geographic boundaries before collection.
Collect one location-level record per place. Preserve Place ID, address, name, category, website, phone, and coordinates.
Remove actual repeated place records. Deduplicate repeated exports of the same location without collapsing legitimate chain branches.
Add chain classification. Apply Chain Info or another defined classification method.
Normalize fields for comparison. Standardize business names, domains, phone formatting, categories, and addresses where necessary.
Create brand-level grouping fields. Keep these separate from the original location data.
Flag uncertain records. Route conflicting or incomplete matches to manual review rather than forcing a classification.
Preserve evidence columns. Keep enough source fields to explain later why a record was grouped or rejected.
The output might contain fields such as:
| plaatsnaam | naam | categorie | website | chain_status | genormaliseerd_merk | review_status |
|---|---|---|---|---|---|---|
| ID-A | Brand A Downtown | Restaurant | brand-a.example | True | Brand A | Confirmed |
| ID-B | Brand A North | Restaurant | brand-a.example | True | Brand A | Confirmed |
| ID-C | Brand A Services | Consultant | different.example | False/Review | — | Manual review |
The exact schema can change, but the principle should not:
never overwrite the underlying place-level evidence simply to make grouping easier.
If the data-collection stage is still manual, standardize that process before adding chain classification. Consistent inputs make the later grouping and QA steps much easier to defend.
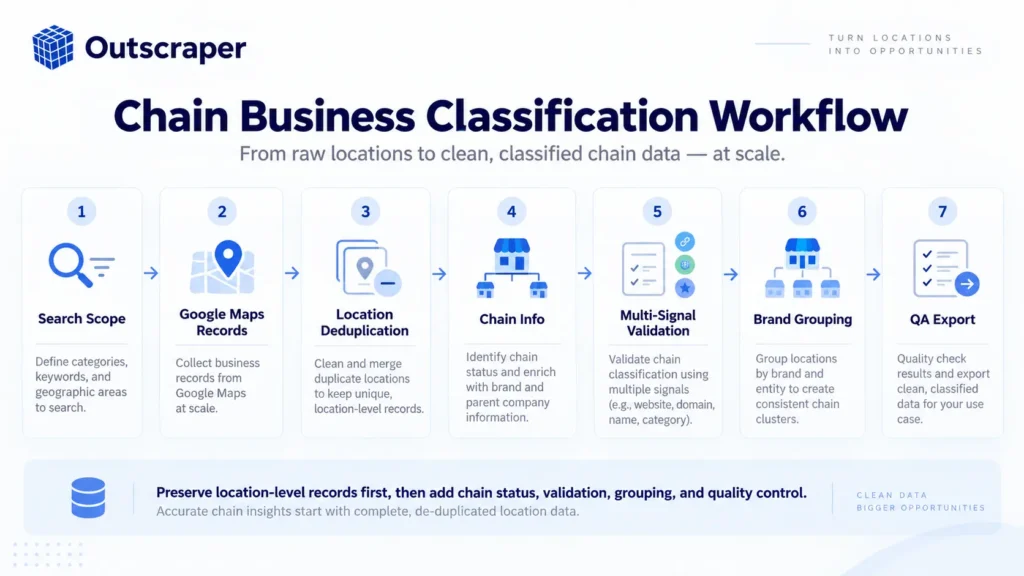
Quality-Control the Dataset Before Using the Classification
A classification process should be tested before its results are treated as reliable.
Start with a sample rather than immediately trusting every record in a large export.
Review examples from several groups:
Obvious chains. Check whether expected multi-location brands are being classified consistently.
Independent businesses. Confirm that similarly named local companies are not being grouped simply because their names resemble one another.
Sub-brands and departments. Look for legitimate naming or category differences that could split one broader brand family.
Missing-data records. Review records with no website, phone, category, or other important validation field.
Conflicting signals. Flag cases where Chain Info, business name, domain, category, and location patterns disagree.
Document the rule used for each final field. If the dataset contains a genormaliseerd_merk column, define what evidence is required before populating it. If there is a confidence or review-status field, define what moves a record from automatic classification to manual review.
It is also useful to preserve the collection date. Google Maps and Business Profile information changes, and Google notes that Place IDs themselves can change over time.
The goal is not to force every record into a brand group.
The goal is to produce a dataset where the classifications can be explained.
A strong final dataset might distinguish:
Confirmed classification — signals agree.
Probable classification — evidence strongly suggests the relationship but one important field is missing.
Manual review — evidence conflicts or remains incomplete.
Unclassified — insufficient evidence.
That is more useful than pretending every record has the same level of certainty.
Identifying chains at scale works best when location identity, chain status, brand grouping, and ownership are treated as separate layers. Outscraper can provide structured Google Maps records and a documented Chain Info enrichment, while the final grouping logic should reflect the level of evidence available rather than making claims the source data cannot support.
Veelgestelde vragen
Meest voorkomende vragen en antwoorden
Een ketenbedrijf is over het algemeen een bedrijf dat onder een gemeenschappelijke merknaam op meerdere locaties actief is. In een Google Maps-dataset moet elk filiaal als een afzonderlijk locatie-record worden behouden. De status ‘keten’ voegt een classificatie op hoger niveau toe; deze vervangt de onderliggende locatiegegevens niet.
Nee. Overeenkomende bedrijfsnamen kunnen nuttig zijn, maar namen alleen zijn niet betrouwbaar genoeg om te bepalen of er sprake is van een keten. Bedrijven die geen verband met elkaar hebben, kunnen vergelijkbare namen hebben, terwijl legitieme vestigingen van een keten verschillende naamgevingsformaten kunnen gebruiken. Combineer naamgegevens met categorieën, websites, telefoongegevens, locaties, identificatiegegevens en aanwijzingen die wijzen op het feit dat het om een keten gaat.
De gedocumenteerde verrijking van de keteninformatie door nr. Outscraper geeft aan of een bedrijf wordt aangemerkt als onderdeel van een keten, aan de hand van een waar/onwaar-waarde. Dat alleen is echter geen bewijs voor het bestaan van een moedermaatschappij, een franchisenemer, bedrijfseigendom, een rechtspersoon, of dat een individuele vestiging eigendom is van het bedrijf of een franchisevestiging is.
Nee. Als de records betrekking hebben op afzonderlijke fysieke locaties, moeten ze normaal gesproken als afzonderlijke records blijven bestaan. Bij het ontdubbelen moeten herhaalde records voor dezelfde locatie worden verwijderd, niet legitieme vestigingen van dezelfde keten. Het groeperen op basis van keten of merk moet worden opgeslagen als een extra classificatielaag.
Maak gebruik van opties voor het verwijderen van dubbele gegevens, indien beschikbaar, met name wanneer u meerdere geografische zoekopdrachten combineert. Controleer de definitieve dataset voordat u deze verrijkt of in een ander systeem importeert.
Er is geen strikte limiet: Outscraper is ontworpen om mee te groeien. Je kunt alle beoordelingen voor één bedrijfsvermelding verzamelen of bulktaken uitvoeren voor honderden locaties tegelijk. Teams die sentimentanalyses uitvoeren, halen vaak tienduizenden beoordelingen uit hele sectoren binnen. Het platform voert de zware bewerkingen uit in de cloud, zodat uw computer niet aan hoeft te blijven staan terwijl de taak wordt uitgevoerd.
tart with clean location records, preserve the fields needed for validation, and add chain classification only after the unit of analysis is clear.