Оглавление
К определить предприятия, входящие в сеть При работе с данными Google Maps в больших объемах сначала необходимо разделить две разные задачи: идентификацию каждого физического местоположения и определение того, принадлежит ли данное местоположение к крупной сети. Одного сопоставления названий недостаточно, поскольку несвязанные между собой предприятия могут иметь схожие названия, в то время как подлинные филиалы сети могут использовать слегка отличающийся брендинг. Надежный рабочий процесс предполагает хранение информации о каждом местоположении в отдельной записи, использование стабильных идентификаторов местоположений там, где это возможно, добавление классификации по принадлежности к сети, а также проверку сомнительных совпадений с помощью нескольких бизнес-индикаторов. В этом руководстве показано, как построить такой процесс, не смешивая обнаружение дубликатов, принадлежность к сети и юридическое право собственности.
Прежде чем приступить к классификации цепочек, соберите структурированные записи из Google Maps, содержащие поля «местоположение», «категория», «веб-сайт», «телефон», «адрес» и «идентификатор», которые понадобятся вам для проверки.
Краткий ответ
Чтобы выявить сетевые предприятия в данных Google Maps, храните каждую физическую точку как отдельную запись, определяйте, принадлежит ли предприятие к сети, и проверяйте сомнительные совпадения с помощью таких признаков, как название предприятия, категория, веб-сайт, номер телефона, адрес и особенности расположения. Не объединяйте записи только из-за совпадения названий и не рассматривайте принадлежность к сети как доказательство общего юридического владения.
Почему идентификация сетей сложнее, чем сопоставление названий компаний
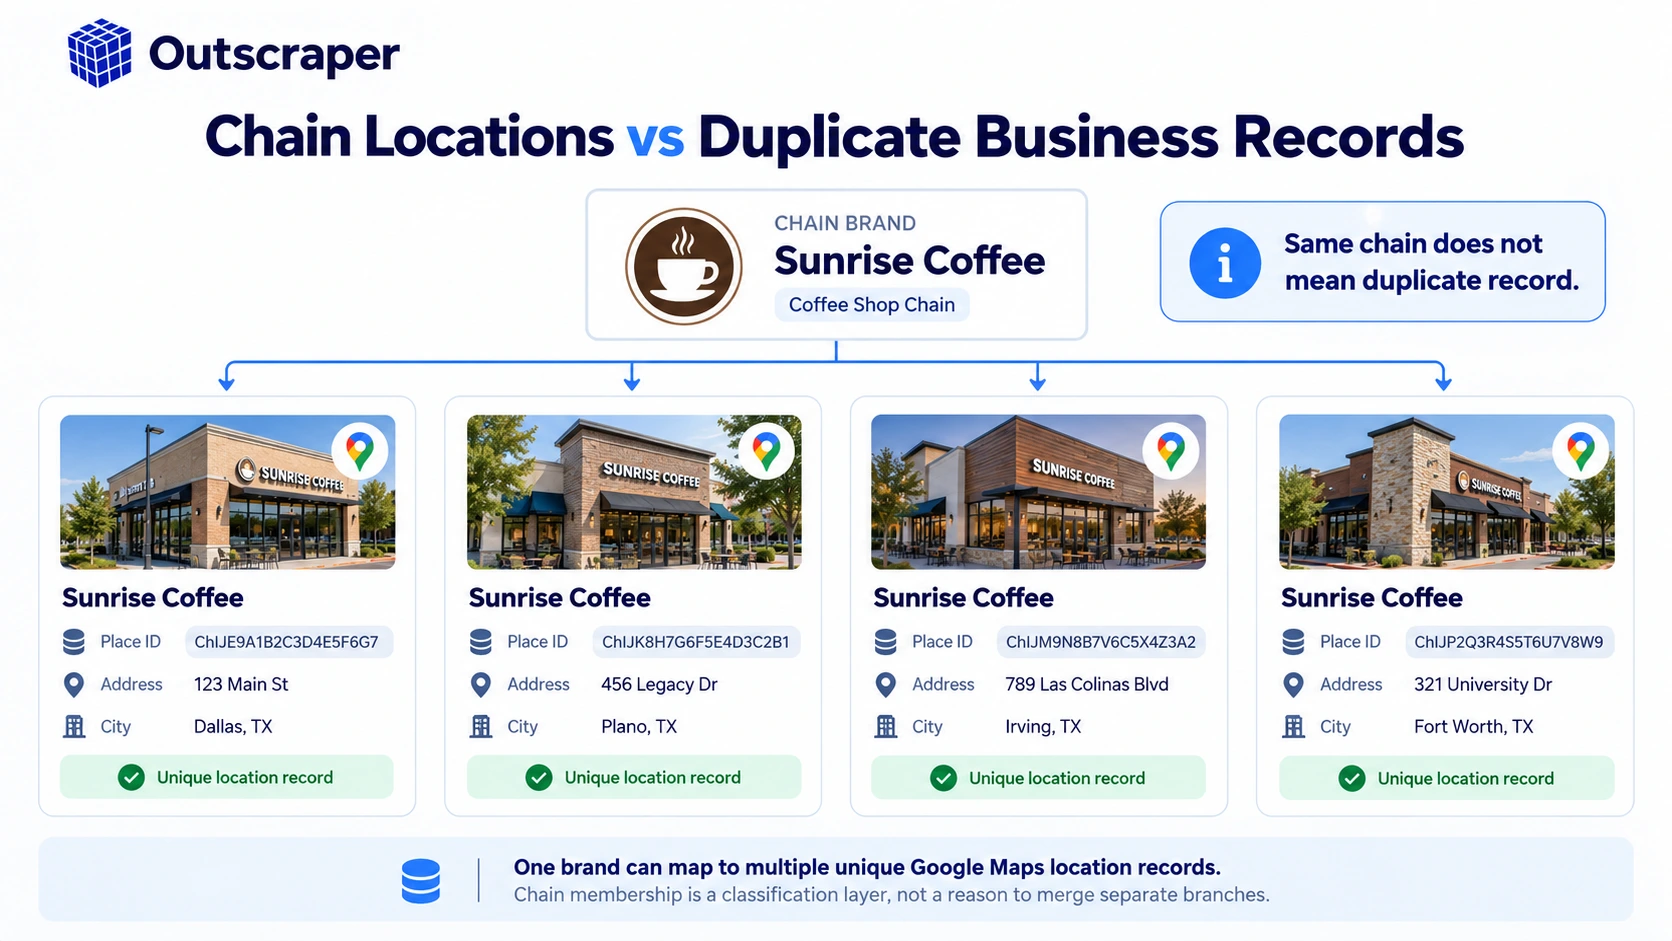
Набор данных Google Maps по сути ориентирован на географическое положение. Один бренд, имеющий 150 филиалов, может отображаться как 150 отдельных записей, поскольку каждый филиал представляет собой отдельное место. В то же время две не связанные между собой компании могут иметь похожие или даже одинаковые названия.
Это приводит к важному различию:
дубликат записи ≠ местоположение в цепочке ≠ одна и та же компания
Предположим, что набор данных содержит пять записей с названием “Central Coffee”. Эти записи могут обозначать пять филиалов одного бренда, несколько не связанных между собой предприятий, использующих общее название, или сочетание того и другого. Удаление четырёх записей только из-за совпадения названий может привести к удалению действительных местоположений.
Встречается и обратная проблема. Настоящая сеть может не использовать повсеместно одно и то же видимое название. В действующих рекомендациях Google по профилям компаний, как правило, рекомендуется использовать единообразные названия и категории для всех филиалов сети, однако в них также предусмотрены исключения для суббрендов, отделов, различных форматов ведения деятельности и реальных вариаций названий.
Это означает, что согласованность имен является полезным доказательством, но сама по себе она не является достаточным доказательством.
Поэтому перед классификацией необходимо определить единицу анализа. Текущее руководство Outscraper по Данные о компаниях из Google Maps для анализа рынка делает аналогичное разграничение: в зависимости от исследуемого вопроса исследователям может потребоваться подсчитать количество отдельных мест, компаний, брендов или зон обслуживания.
Для идентификации цепи наиболее надежным отправным пунктом является:
одно действительное физическое местоположение = одна запись на уровне местоположения
Затем добавьте членство в цепочке в качестве еще одного уровня.
Начните с одной записи на каждое местоположение в Google Maps
Прежде чем определять, входит ли предприятие в сеть, убедитесь, что набор данных позволяет достоверно различать одно заведение от другого.
Название компании — ненадёжный основной идентификатор, поскольку уникальность названий не гарантируется. Адрес помогает, но различия в форматировании могут приводить к ложным несовпадениям. Номера телефонов и веб-сайты полезны, но они также могут дублироваться или отсутствовать.
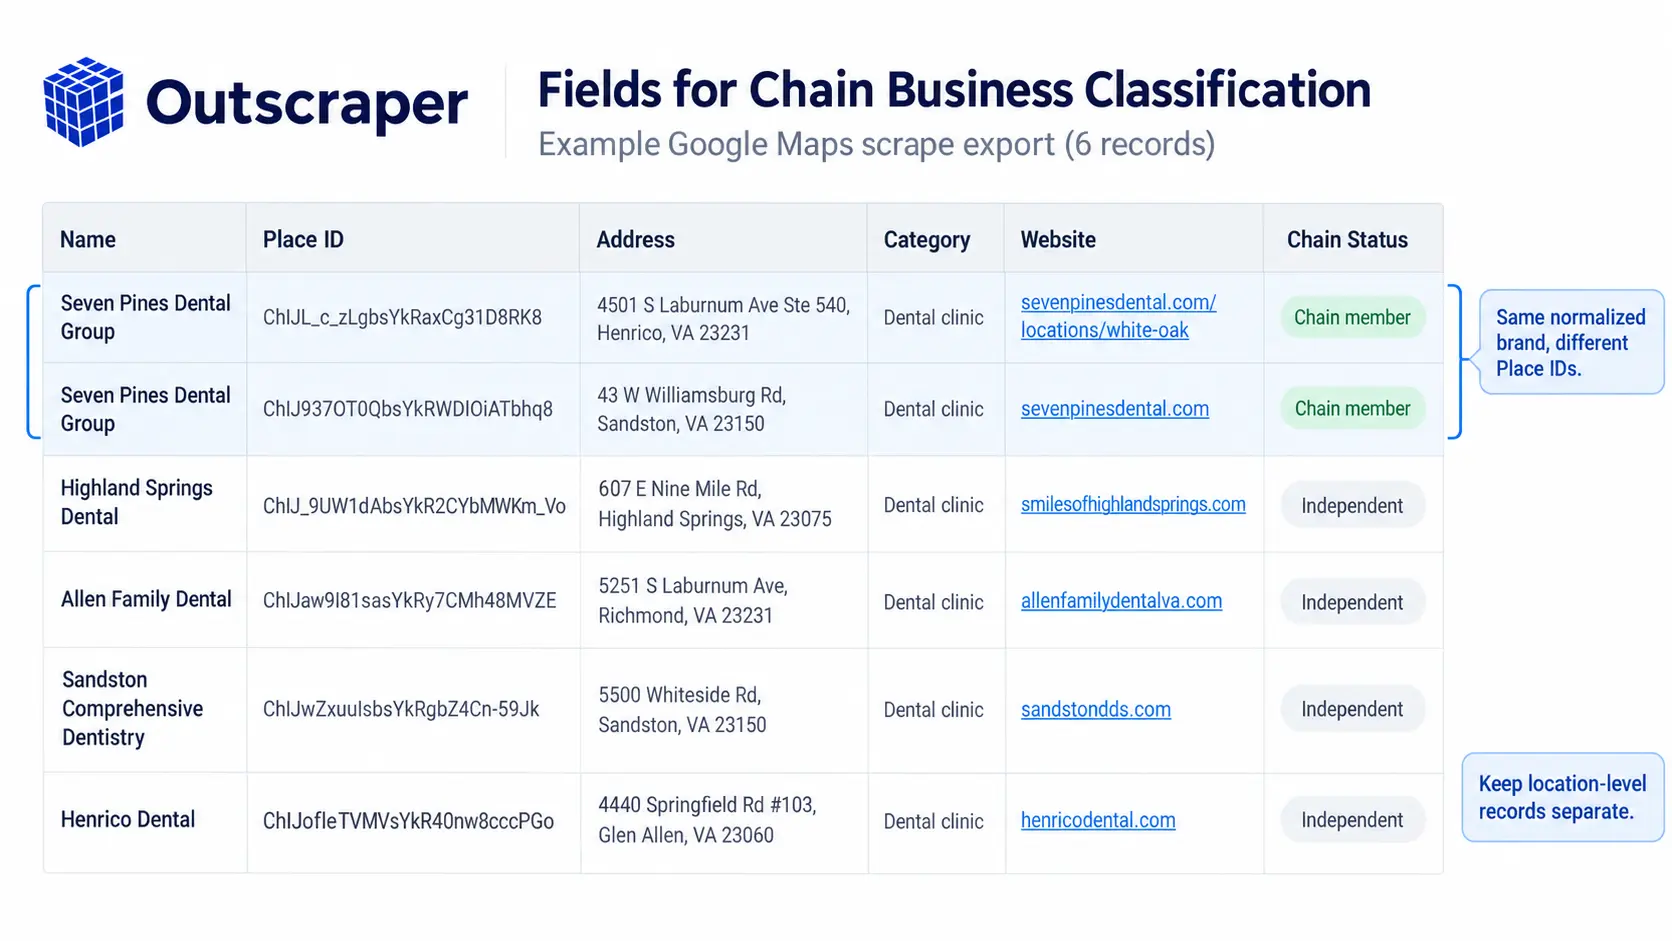
Google Place ID — это более надежное поле, связанное с местоположением, поскольку Google описывает Place ID как идентификаторы объектов в своей базе данных Places. Google также отмечает два важных ограничения: одно и то же место иногда может иметь несколько Place ID, а Place ID могут меняться со временем. Google рекомендует обновлять сохраненные идентификаторы, срок хранения которых превышает 12 месяцев.
Поэтому в рамках данного рабочего процесса идентификатор «Place ID» следует рассматривать как надежный идентификатор местоположения, а не как постоянный корпоративный идентификатор.
Практичный набор данных на уровне местоположения должен содержать такие поля, как:
| Поле | Роль в рабочем процессе |
|---|---|
| Идентификатор места | Выделяет отдельные места |
| Наименование компании | Предоставляет доказательства, подтверждающие принадлежность к бренду/наименованию |
| Адрес | Подтверждает физическое местонахождение |
| Категория | Помогает сравнить виды бизнеса |
| Веб-сайт | Поддерживает сопоставление брендов и доменов |
| Телефон | Добавляет ещё один сигнал идентификации |
| Координаты | Подтверждает географическое разделение |
| Состояние цепи | Добавляет классификацию по наличию/отсутствию цепочки |
Если в исходных данных по-прежнему присутствуют повторяющиеся результаты поиска по одному и тому же месту, удалите фактически повторяющиеся записи о местоположении, прежде чем приступать к группировке брендов. Это операция, отличная от удаления нескольких филиалов одной и той же сети.
Прежде чем группировать бренды, воспользуйтесь цепочной классификацией
Как только местоположение каждого объекта будет правильно зафиксировано, возникает следующий вопрос: входит ли данное предприятие в сеть.
В текущей документации по API Outscraper перечислены Информация о цепочке обогащение по параметру ai_chain_info. В документации указано, что эта функция позволяет определить, входит ли предприятие в сеть, и добавляет индикация «истина/ложь» к возвращаемым данным.
Это полезно, поскольку позволяет разделить две задачи, которые часто смешивают:
Задание 1: Это заведение входит в сеть?
Task 2: Which exact brand, parent company, franchise system, or legal entity should this location be associated with?
Chain Info supports the first question. The current documentation does not state that it automatically supplies a verified parent company, franchisee identity, legal ownership structure, or complete global location count.
That boundary matters.
A верно chain value should be treated as a classification signal. It should not be converted into unsupported claims about ownership.
Например:
| Record | Состояние цепи | What you can say |
|---|---|---|
| Business A — Location 1 | True | Classified as part of a chain |
| Business B | False | Not classified as part of a chain |
| Business C — Location 2 | True | Classified as part of a chain |
What you still cannot determine from that boolean field alone is whether Location 1 is corporate-owned, franchised, licensed, operated by a subsidiary, or connected to a particular legal entity.
This is where validation and entity grouping become separate steps.
Add chain classification to structured records
If your workflow uses the Outscraper API, review the current enrichment parameters before designing the classification pipeline.
Validate Chain Matches With Multiple Business Signals
Automated classification makes large datasets manageable, but uncertain or high-value records may still need validation.
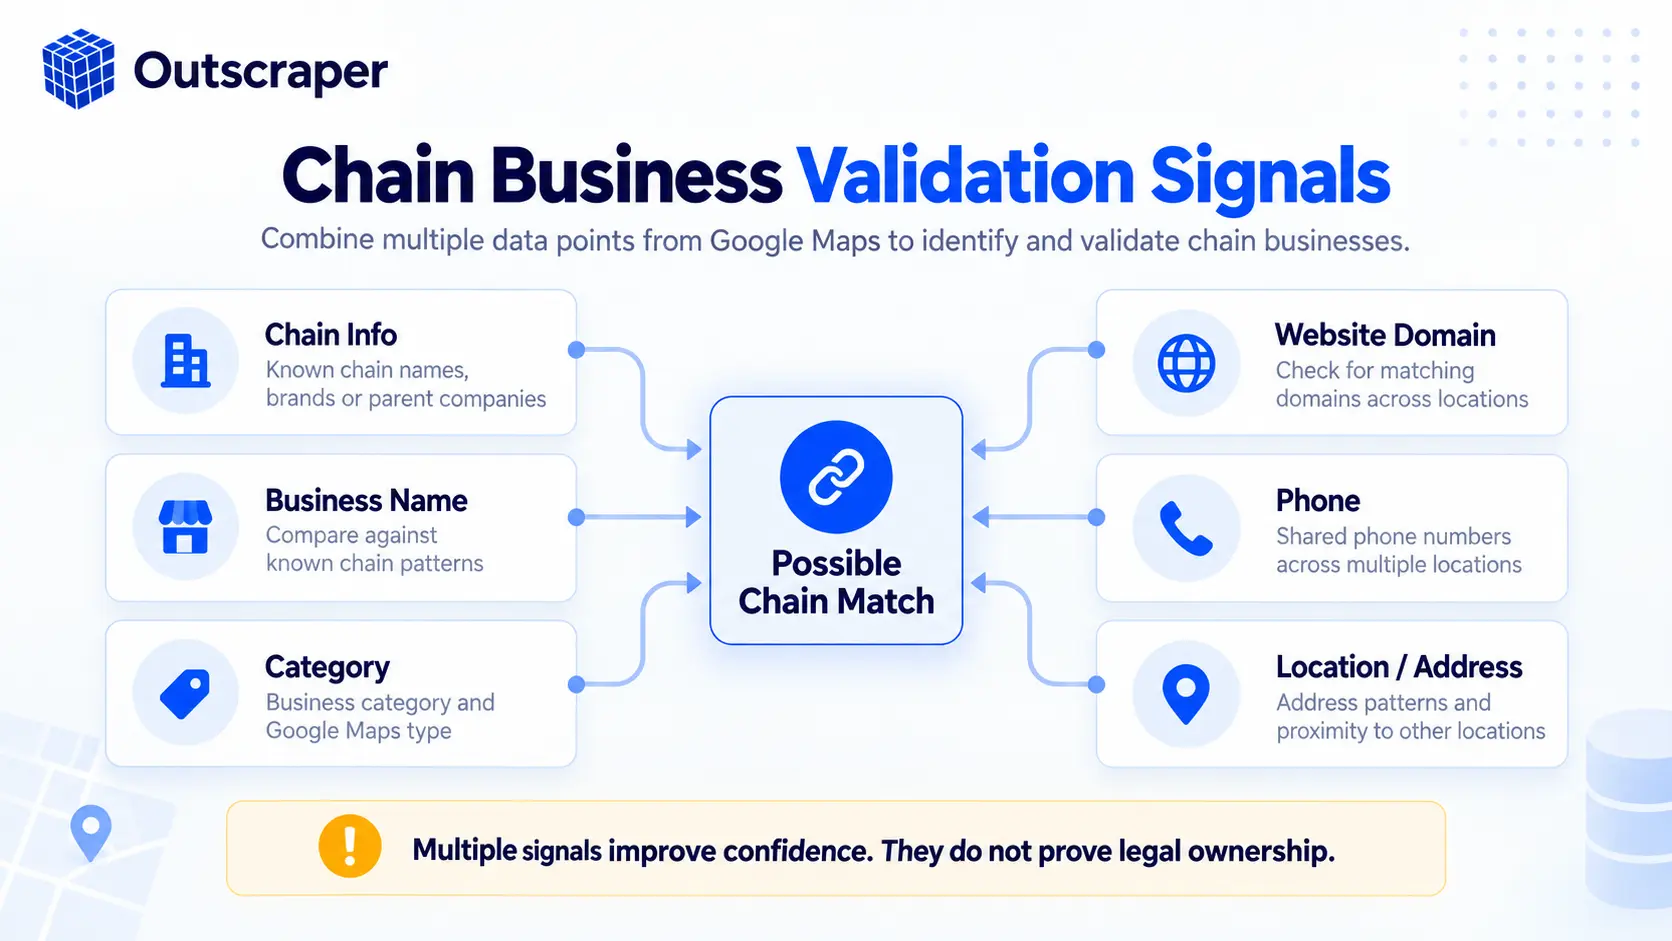
The strongest process uses several signals together rather than treating one field as definitive.
Name and category consistency
Start with the business name and primary category.
Google’s guidelines say chain locations should generally use consistent names and categories when they provide the same service. The same guidance also documents exceptions for sub-brands, departments, different operational formats, and real-world naming variations.
That produces two useful rules:
Consistent name + consistent category strengthens a possible chain match.
Different name does not automatically disprove a chain relationship.
A brand may operate multiple formats with legitimate naming differences.
Website and contact signals
Websites can strengthen a match when multiple locations use the same corporate domain or location pages underneath the same domain.
However, domain matching should still be treated as supporting evidence.
A franchise location may operate its own local website. A business can redirect multiple domains into one brand site. Different businesses can also use common marketplace or booking domains that reveal little about ownership.
Phone data has similar limitations. Some chains use local numbers for every branch, while others route several locations through a centralized number.
Location identity and geographic patterns
Addresses and coordinates help confirm that records represent different physical locations rather than duplicate exports.
Geographic repetition can also reveal an expected chain pattern: the same or similar business identity repeated across several cities or regions.
But geographic scale is not proof of ownership. A licensing network, franchise system, cooperative, or unrelated businesses with similar naming can produce superficially similar patterns.
A strong validation rule is therefore:
Use multiple signals to increase confidence; do not use one field as legal proof.
Separate Chain Membership From Brand and Ownership
This is the part of chain identification that is easiest to oversimplify.
A business can be part of a recognizable chain without every location having the same legal owner.
Franchise systems are the obvious example. Several locations may share a brand, operating model, and customer-facing identity while being operated by separate franchisees.
Sub-brands create another problem. Google explicitly allows certain chain locations to use different real-world names for distinct business formats and sub-brands.
Even two brands operating from the same address do not necessarily represent one record. Google’s Business Profile guidance says independently operating brands at the same location may have separate profiles.
For data work, keep these concepts separate:
| Data layer | Question |
|---|---|
| Location identity | Is this a distinct physical/place record? |
| Chain classification | Is the business classified as part of a chain? |
| Brand grouping | Do several records appear to operate under the same brand identity? |
| Legal ownership | Which legal entity owns or operates the location? |
Google Maps data can support the first layers well. Legal ownership may require additional corporate records, franchise disclosures, company data, first-party information, or other authoritative sources.
This separation also protects the dataset from false precision.
Instead of writing:
“These 47 locations are owned by Company X.”
when ownership has not been verified, use the narrower conclusion:
“These 47 records were classified or grouped as locations associated with Brand X based on the available business signals.”
That is a more defensible statement.
Scale the Classification Across a Large Google Maps Dataset
Manual review can work for 20 businesses. It becomes inconsistent when the dataset contains thousands of locations.
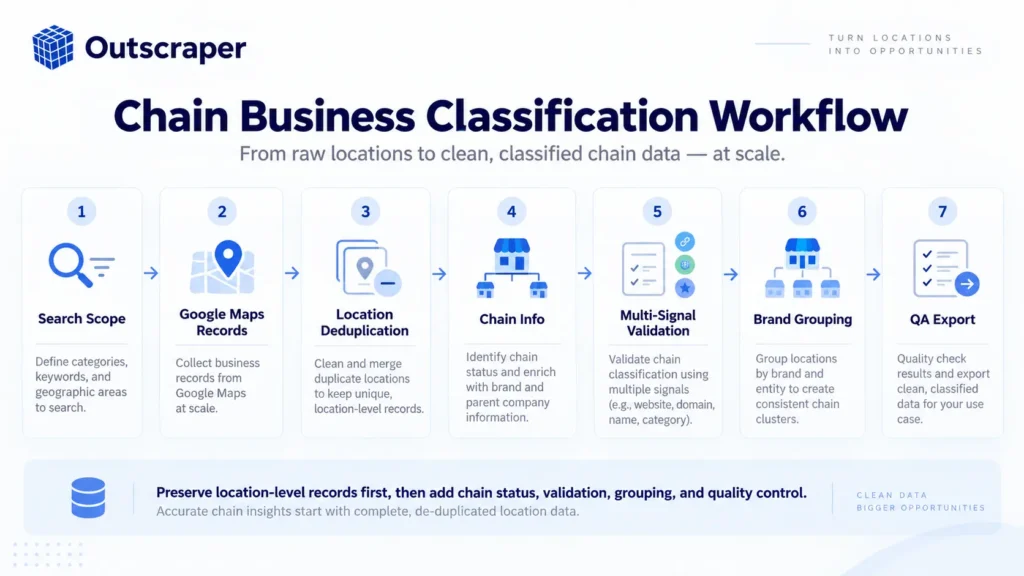
At scale, the process should become a repeatable pipeline.
A practical workflow looks like this:
Define the collection scope. Set the business categories, countries, cities, or other geographic boundaries before collection.
Collect one location-level record per place. Preserve Place ID, address, name, category, website, phone, and coordinates.
Remove actual repeated place records. Deduplicate repeated exports of the same location without collapsing legitimate chain branches.
Add chain classification. Apply Chain Info or another defined classification method.
Normalize fields for comparison. Standardize business names, domains, phone formatting, categories, and addresses where necessary.
Create brand-level grouping fields. Keep these separate from the original location data.
Flag uncertain records. Route conflicting or incomplete matches to manual review rather than forcing a classification.
Preserve evidence columns. Keep enough source fields to explain later why a record was grouped or rejected.
The output might contain fields such as:
| place_id | имя | категория | сайт | chain_status | нормализованный_бренд | review_status |
|---|---|---|---|---|---|---|
| ID-A | Brand A Downtown | Ресторан | brand-a.example | True | Brand A | Confirmed |
| ID-B | Brand A North | Ресторан | brand-a.example | True | Brand A | Confirmed |
| ID-C | Brand A Services | Консультант | different.example | False/Review | — | Manual review |
The exact schema can change, but the principle should not:
never overwrite the underlying place-level evidence simply to make grouping easier.
If the data-collection stage is still manual, standardize that process before adding chain classification. Consistent inputs make the later grouping and QA steps much easier to defend.
Quality-Control the Dataset Before Using the Classification
A classification process should be tested before its results are treated as reliable.
Start with a sample rather than immediately trusting every record in a large export.
Review examples from several groups:
Obvious chains. Check whether expected multi-location brands are being classified consistently.
Independent businesses. Confirm that similarly named local companies are not being grouped simply because their names resemble one another.
Sub-brands and departments. Look for legitimate naming or category differences that could split one broader brand family.
Missing-data records. Review records with no website, phone, category, or other important validation field.
Conflicting signals. Flag cases where Chain Info, business name, domain, category, and location patterns disagree.
Document the rule used for each final field. If the dataset contains a нормализованный_бренд column, define what evidence is required before populating it. If there is a confidence or review-status field, define what moves a record from automatic classification to manual review.
It is also useful to preserve the collection date. Google Maps and Business Profile information changes, and Google notes that Place IDs themselves can change over time.
The goal is not to force every record into a brand group.
The goal is to produce a dataset where the classifications can be explained.
A strong final dataset might distinguish:
Confirmed classification — signals agree.
Probable classification — evidence strongly suggests the relationship but one important field is missing.
Manual review — evidence conflicts or remains incomplete.
Unclassified — insufficient evidence.
That is more useful than pretending every record has the same level of certainty.
Identifying chains at scale works best when location identity, chain status, brand grouping, and ownership are treated as separate layers. Outscraper can provide structured Google Maps records and a documented Chain Info enrichment, while the final grouping logic should reflect the level of evidence available rather than making claims the source data cannot support.
Часто задаваемые вопросы
Наиболее частые вопросы и ответы
Сетевой бизнес — это, как правило, предприятие, работающее под единым брендом в нескольких местах. В наборе данных Google Maps каждый филиал должен по-прежнему фигурировать в качестве отдельной записи о местоположении. Статус «сеть» добавляет классификацию более высокого уровня; он не заменяет исходные данные о местоположении.
Нет. Совпадение названий компаний может быть полезным, но одни только названия недостаточно надежны для классификации сетей. Несвязанные между собой компании могут иметь схожие названия, в то время как филиалы легитимных сетей могут использовать разные форматы наименований. Необходимо сочетать данные о названиях с категориями, веб-сайтами, контактными данными, местоположениями, идентификаторами и признаками, указывающими на принадлежность к сети.
В задокументированных данных «Chain Info» от No. Outscraper указывается, относится ли предприятие к сети, с помощью значения «да» или «нет». Однако этого недостаточно для определения материнской компании, франчайзи, структуры корпоративной собственности, юридического лица, а также того, принадлежит ли конкретное заведение компании или работает по франшизе.
Нет. Если записи относятся к разным физическим местоположениям, они, как правило, должны оставаться отдельными записями. При дедупликации следует удалять повторяющиеся записи, относящиеся к одному и тому же месту, а не законные филиалы одной и той же сети. Группировка по сетям или брендам должна храниться в качестве дополнительного уровня классификации.
По возможности используйте параметры удаления дубликатов, особенно при объединении нескольких географических запросов. Проверьте окончательный набор данных перед его обогащением или импортом в другую систему.
Жестких ограничений нет — Outscraper разработана с учетом возможности масштабирования. Вы можете собирать все отзывы для одной компании или выполнять массовые задачи сразу по сотням локаций. Команды, занимающиеся анализом настроений, часто собирают десятки тысяч отзывов по целым отраслям. Платформа выполняет основную работу в облаке, поэтому во время выполнения задачи ваш компьютер не должен оставаться включенным.
tart with clean location records, preserve the fields needed for validation, and add chain classification only after the unit of analysis is clear.