Indice
A Scraper di Google Maps oggi può restituire migliaia di record, ma in seguito lo stesso processo potrebbe fallire a causa di una modifica apportata a una parte del processo di estrazione.
Le richieste bloccate, i problemi con i proxy, i CAPTCHA, i batch non riusciti e le modifiche all'analisi dei dati comportano tutti un carico di lavoro di manutenzione. Una volta che lo scraper diventa parte integrante di un flusso di lavoro ricorrente, qualcuno deve monitorare i processi, risolvere gli errori, gestire l'infrastruttura e garantire il corretto funzionamento della logica di estrazione.
È facile trascurare questo lavoro continuo durante la prima fase di sviluppo. Un team potrebbe sentirsi a proprio agio nell'assumersene la responsabilità quando i requisiti di estrazione sono insoliti o quando lo scraping fa già parte delle attività di manutenzione svolte dai suoi ingegneri.
La decisione diventa più complessa quando i dati di Google Maps costituiscono solo uno dei tanti input utilizzati per la generazione di lead, la ricerca, i database o le applicazioni interne. In questi casi, il tempo dedicato al funzionamento del livello di estrazione va ad aggiungersi al costo dei dati stessi.
Risposta rapida: È consigliabile creare il proprio scraper per Google Maps?
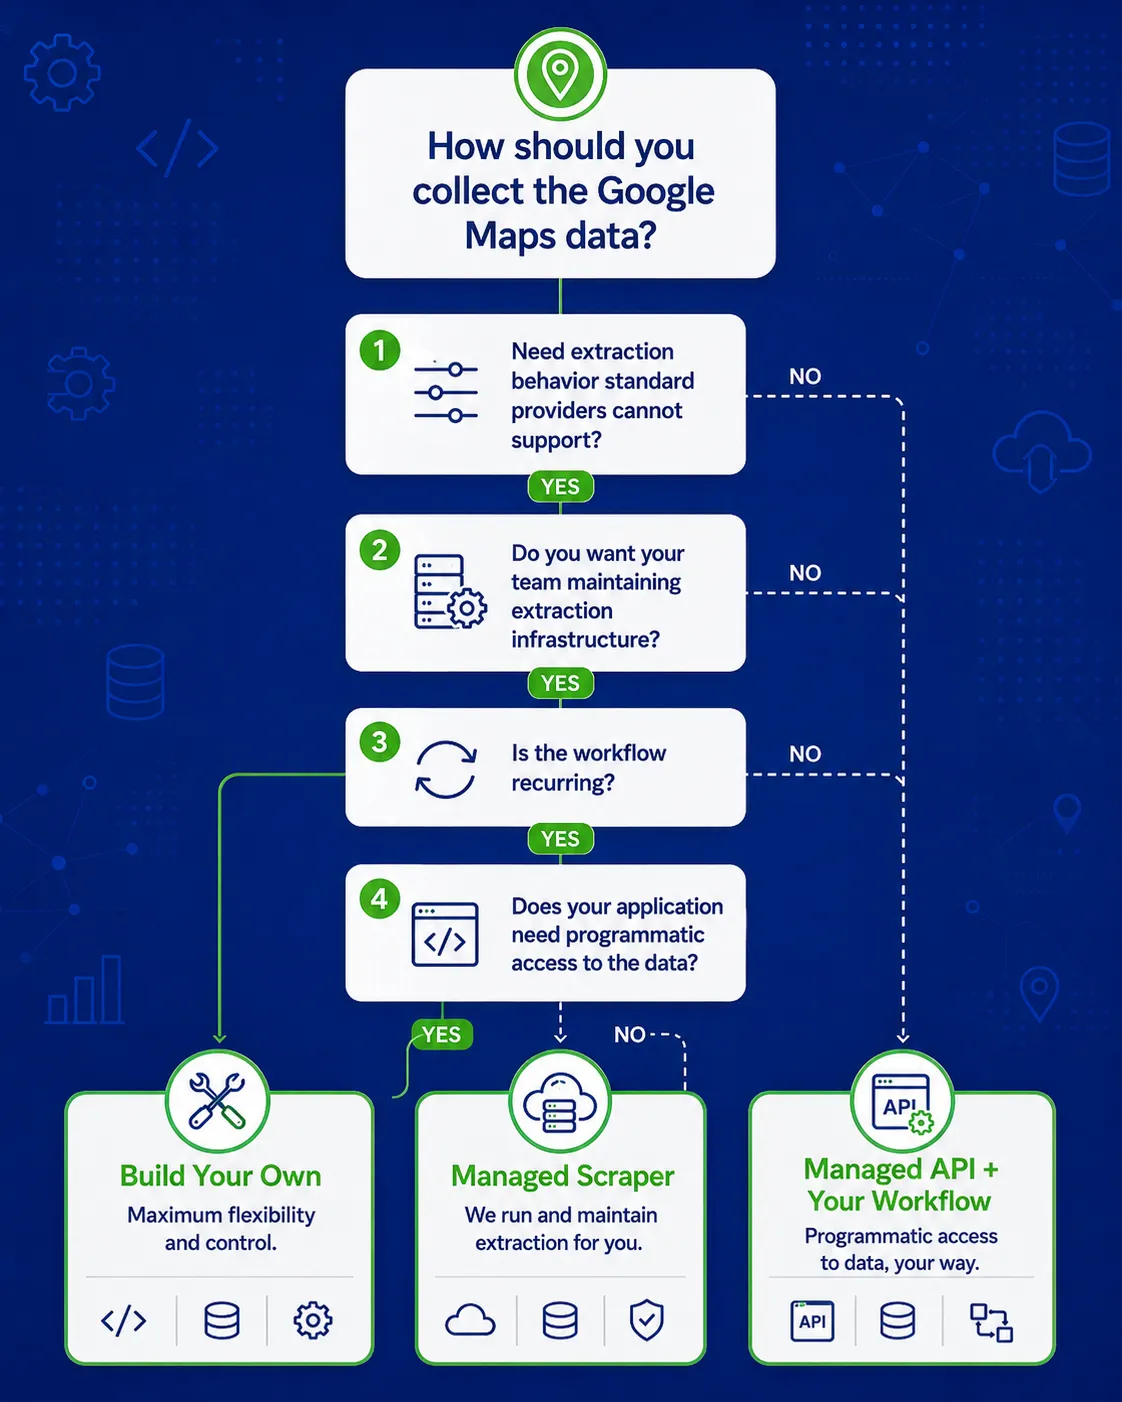
- Costruiscilo per un'estrazione personalizzata e un controllo totale.
- Utilizza uno scraper gestito per ridurre gli interventi di manutenzione.
- Utilizza un'API gestita per mantenere il proprio flusso di lavoro senza doversi occupare della manutenzione dello scraper.
- Confronta i tempi relativi a controllo, manutenzione, volume e progettazione prima di prendere una decisione.
Cosa comporta la gestione di uno scraper fai-da-te per Google Maps
Scrivere la prima versione di uno scraper è solo una parte del lavoro. Una volta che viene eseguito ripetutamente, la manutenzione si concentra su tutto ciò che ruota attorno al processo di estrazione.
Una configurazione fai-da-te potrebbe richiedere l'automazione del browser, la gestione dei proxy, la logica di riprova, il monitoraggio e correzioni periodiche quando il comportamento della pagina cambia. Queste attività diventano più evidenti quando lo scraper viene utilizzato per la generazione ricorrente di lead, ricerche di mercato o flussi di lavoro interni relativi ai dati.
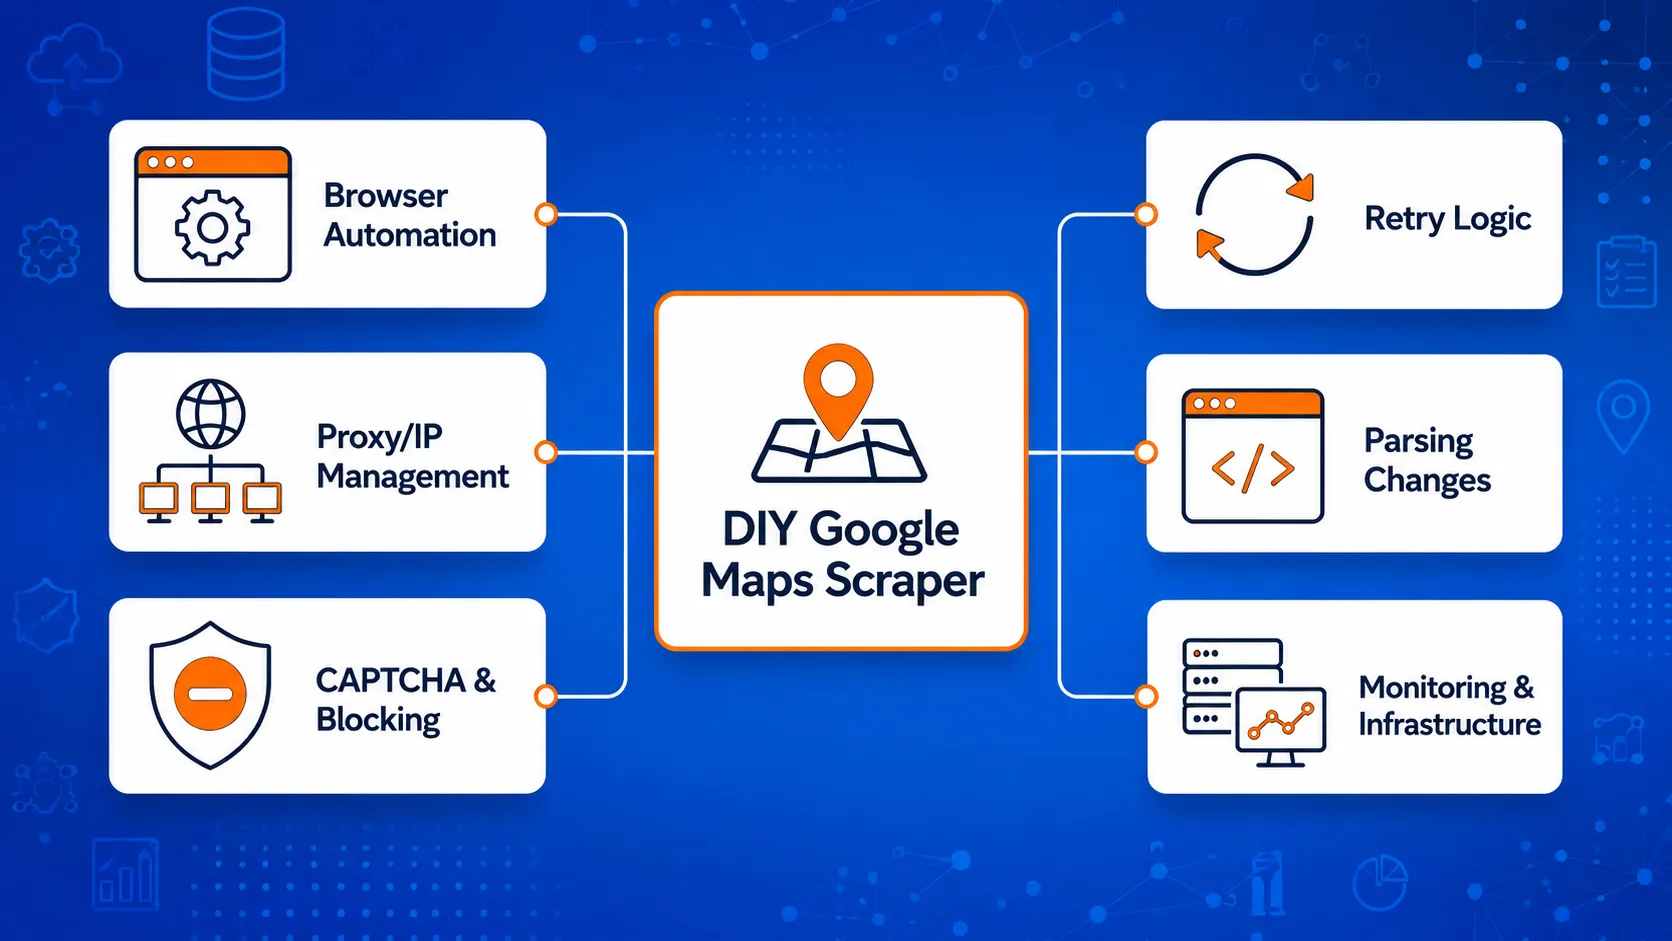
Automazione del browser e logica di estrazione
Google Maps si basa in larga misura su contenuti dinamici delle pagine, pertanto molti scraper fai-da-te ricorrono all'automazione del browser o a metodi simili per caricare e raccogliere i dati.
La logica di estrazione deve inoltre identificare gli elementi corretti, gestire lo scorrimento o il caricamento ripetuto e restituire i campi previsti dal flusso di lavoro. Se la struttura della pagina cambia, potrebbe essere necessario aggiornare alcune parti di tale logica.
Se vuoi approfondire i dettagli della configurazione tecnica, consulta la nostra guida su Estrazione di dati da Google Maps con Python tratta l'estrazione tramite browser e le attività di supporto ad essa correlate.
Gestione dei proxy e degli indirizzi IP
Le richieste ripetute possono comportare un ulteriore carico di lavoro nella gestione della proprietà intellettuale.
Un team che gestisce un proprio scraper potrebbe dover gestire pool di proxy, rimuovere i proxy non funzionanti, monitorare le richieste bloccate e decidere come distribuire le richieste. Anche la qualità dei proxy può influire sull'affidabilità con cui vengono completati i lavori.
Su piccola scala, la situazione potrebbe essere gestibile. Diventa però più difficile ignorarla quando lo scraper analizza numerose ricerche o località.
CAPTCHA e blocco
I CAPTCHA e le richieste bloccate possono interrompere un processo di estrazione prima che sia completato.
Un flusso di lavoro di produzione necessita quindi di un modo per rilevare questi errori e decidere come procedere. Alcune richieste potrebbero dover essere riprovate, posticipate o instradate tramite un indirizzo IP diverso.
Senza tale elaborazione, uno scraper può sembrare efficace pur restituendo set di dati incompleti.
Nuovi tentativi e processi non riusciti
Una richiesta non andata a buon fine è solitamente più facile da gestire rispetto a un'operazione completata solo in parte.
Ad esempio, uno scraper potrebbe completare l'80% di un lotto di grandi dimensioni prima che una parte del processo si interrompa. Il sistema deve quindi sapere quali operazioni sono andate a buon fine, quali hanno dato esito negativo e quali devono essere rieseguite, senza creare duplicati superflui.
Ciò richiede, oltre al codice di estrazione vero e proprio, anche il monitoraggio dei processi e le regole di riprova.
Modifiche all’analisi sintattica
Lo scraper dipende anche dalla struttura che si aspetta di trovare.
Una modifica alle etichette, agli elementi della pagina o alle modalità di caricamento dei dati può influire sui campi restituiti dal parser. Lo scraper potrebbe continuare a funzionare, generando tuttavia valori mancanti o mappati in modo errato senza che ciò risulti evidente.
È quindi necessario effettuare controlli regolari per verificare che l'output corrisponda ancora a quanto previsto dai sistemi a valle.
Infrastruttura e monitoraggio
Una volta che uno scraper gestisce attività ricorrenti, qualcuno deve verificare che funzioni ancora correttamente.
Ciò può includere server, log, archiviazione, stato dei processi, avvisi, batch non riusciti e controlli dei risultati. Il monitoraggio assume particolare importanza quando i dati alimentano un altro sistema e un'estrazione non riuscita potrebbe non essere rilevata immediatamente.
Questa è la parte di uno scraper fai-da-te per Google Maps che si tende facilmente a sottovalutare. Il codice che raccoglie i dati è solo una parte del tutto. Il team dispone anche dei sistemi necessari per garantire il corretto funzionamento del processo di raccolta.
Outscraper gestisce il livello di estrazione dei dati da Google Maps, consentendo al tuo team di lavorare con i dati aziendali ottenuti, anziché occuparsi della manutenzione dell'infrastruttura di scraping.
Quanto costa creare il proprio scraper per Google Maps?
Il costo di uno scraper realizzato in proprio va ben oltre la scrittura della prima versione del codice. Una volta che lo scraper supporta i processi ricorrenti, il team deve sostenere anche i costi relativi ai sistemi e al tempo dedicato dagli ingegneri necessario per mantenerlo operativo.
Confronta il costo di realizzazione dello scraper con quello necessario per mantenerlo in funzione.
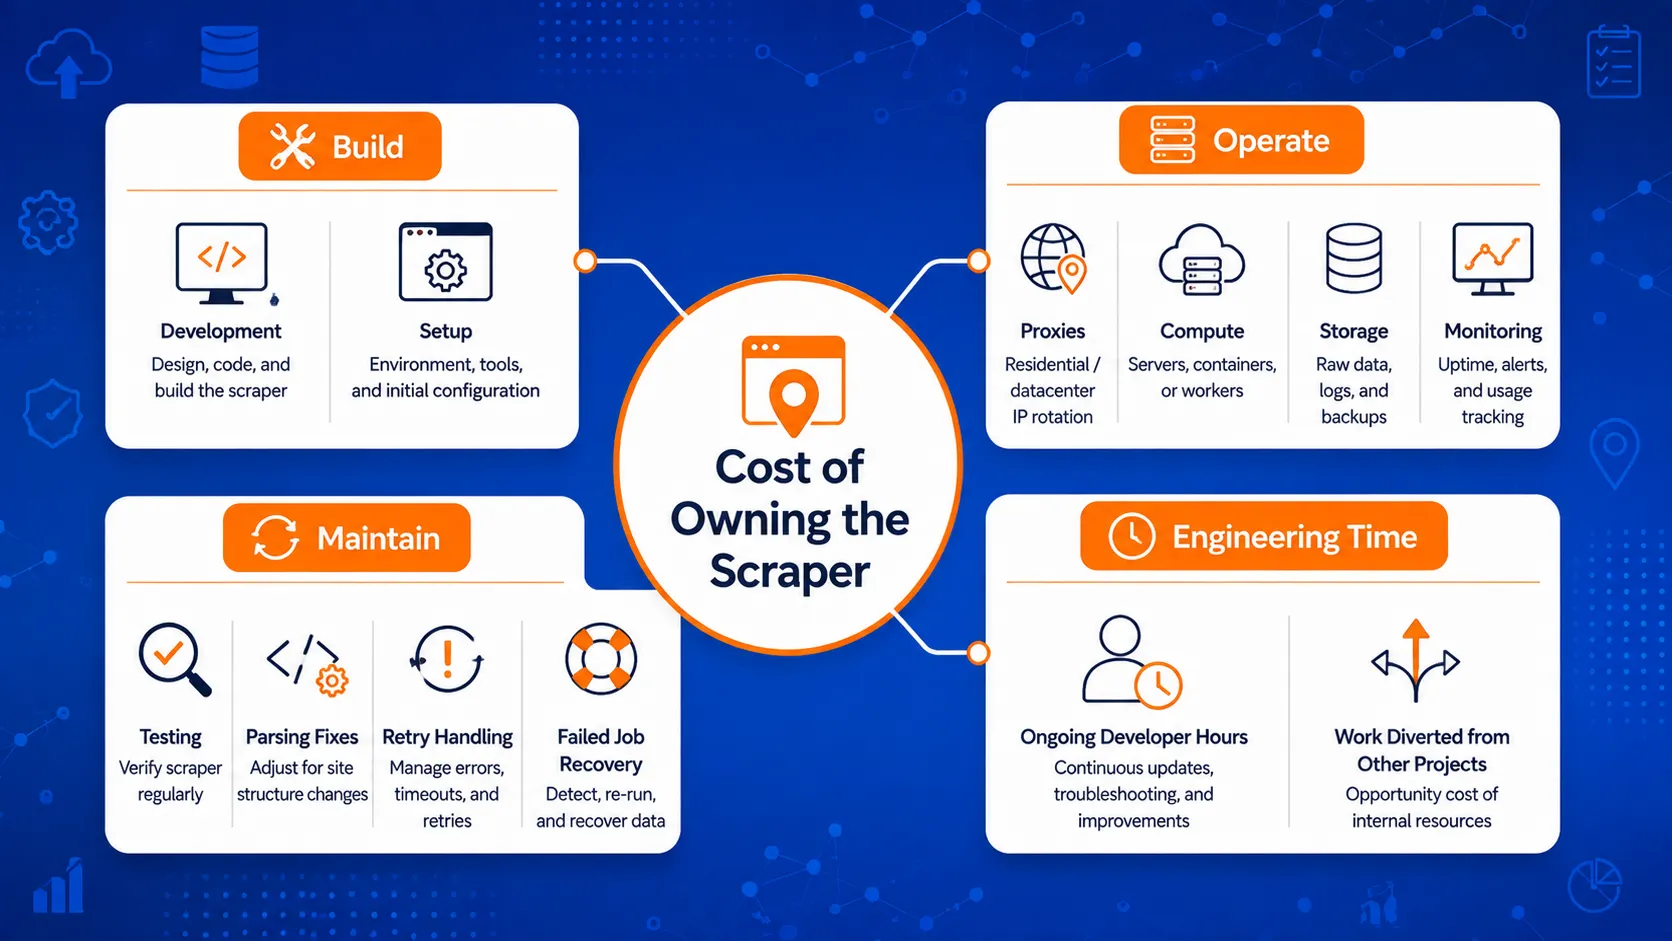
Tempo iniziale dedicato alla progettazione
La prima build potrebbe includere qualcosa in più rispetto allo script di estrazione vero e proprio.
Gli ingegneri potrebbero inoltre dover configurare l'automazione del browser, la gestione delle richieste, l'instradamento tramite proxy, l'archiviazione dei dati, le regole di riprova, la registrazione degli eventi e i controlli sull'output. Il carico di lavoro dipende dalla quantità di dati che lo scraper deve raccogliere e dal livello di affidabilità richiesto dal flusso di lavoro.
Un piccolo test interno presenta requisiti molto diversi rispetto a uno scraper che alimenta un database di produzione ogni settimana.
Costi relativi ai proxy e alle infrastrutture
Lo scraping ricorrente potrebbe richiedere l'utilizzo di infrastrutture a pagamento, quali proxy, server, spazio di archiviazione e sistemi di monitoraggio.
Questi costi possono aumentare in base al numero di ricerche, alle località e ai record raccolti. Possono inoltre variare quando lo scraper necessita di risorse aggiuntive per gestire lavori più consistenti o richieste non andate a buon fine.
Il punto fondamentale è che, una volta completata la fase di sviluppo, le infrastrutture continuano solitamente a rientrare nei costi operativi.
Tempo di manutenzione
È necessario prestare attenzione a uno scraper quando il comportamento di estrazione cambia o i risultati non corrispondono più alle aspettative.
Tali attività possono comprendere:
- definizione dei selettori o delle regole di analisi
- sostituzione dei proxy difettosi
- verifica dei lavori incompleti
- aggiornamento dell'automazione del browser
- analisi dei registri
- verificare le modifiche prima di eseguire il batch successivo
Anche le piccole modifiche finiscono per incidere quando lo scraper diventa parte di un processo di elaborazione dati ricorrente.
Costi di guasto e ripristino
Anche i lavori non andati a buon fine richiedono tempo.
Qualcuno deve individuare cosa non ha funzionato, stabilire quali dati fossero già stati raccolti, ripetere le operazioni mancanti e verificare che nel risultato finale non vi siano lacune o duplicati.
Ciò assume maggiore importanza quando un lotto non riuscito causa un ritardo in un altro processo, come la preparazione di un elenco di potenziali clienti, una ricerca di mercato o un’applicazione interna che dipende da quei dati.
Costo opportunità ingegneristico
Il tempo dedicato allo sviluppo comporta un altro costo: il lavoro che non viene svolto mentre gli sviluppatori si occupano della manutenzione dello scraper.
Un team potrebbe preferire dedicare quelle ore alla creazione di strumenti di reporting, al miglioramento del proprio database, all’aggiunta di fasi di arricchimento dei dati o allo sviluppo di funzionalità basate sui dati raccolti.
Ciò rende la manutenzione degli scraper una decisione non solo tecnica, ma anche aziendale.
| Area dei costi | Durante la fase iniziale di sviluppo | Durante l'uso continuativo |
|---|---|---|
| Ingegneria | Logica di estrazione e configurazione | Correzioni, test e aggiornamenti |
| Proxy | Configurazione e collaudo | Uso ricorrente |
| Infrastrutture | Server, archiviazione, registrazione | Hosting e monitoraggio |
| Ripresa dell'occupazione | Logica di riprova | Lavori non riusciti e parziali |
| Controlli dei dati | Configurazione dell'uscita | Campi mancanti o errati |
| Tempo di progettazione | Costruzione dello scraper | Manutenzione del processo di estrazione |
Per confrontare questi costi interni con l'opzione gestita, è anche possibile verificare in che modo Prezzi di Google Maps Scraper funziona e quali impostazioni possono influire sul costo dell’attività.
L'opzione più economica all'inizio potrebbe non rimanere tale una volta considerati i costi di manutenzione, i lavori non andati a buon fine e il tempo dedicato alla progettazione.
Quando la strada del fai da te è la scelta giusta
Realizzare uno scraper in proprio può comunque rivelarsi la scelta migliore quando il processo di estrazione in sé è fondamentale per il prodotto o quando il team ha un motivo ben preciso per voler controllare l'intero sistema.
È necessaria una logica di estrazione altamente personalizzata
Uno scraper gestito può coprire i campi e il flusso di lavoro necessari alla maggior parte dei team, ma alcuni progetti richiedono regole di estrazione specifiche per una determinata applicazione.
Ciò può includere logiche di analisi sintattica insolite, comportamenti personalizzati delle pagine, fasi di convalida speciali o un flusso di lavoro basato su dati che i provider standard non restituiscono.
In questi casi, il fatto di disporre dello scraper offre al team di ingegneri maggiore libertà nel modificare il funzionamento del processo di estrazione.
Avete già dei tecnici specializzati in scraping interni
L'onere della manutenzione assume un aspetto diverso quando un'azienda dispone già di tecnici incaricati della gestione dei sistemi di scraping.
Potrebbero già disporre di un'infrastruttura proxy, sistemi di monitoraggio, logiche di riprova, spazio di archiviazione e strumenti interni per la gestione dei lavori non riusciti. Aggiungere uno scraper di Google Maps a tale configurazione può risultare più sensato rispetto all'introduzione di un altro servizio esterno.
La domanda principale è se il team disponga di risorse sufficienti per occuparsene senza distogliere l'attenzione dalle attività di maggiore priorità.
Il flusso di lavoro è limitato o in fase sperimentale
Un test di piccole dimensioni non richiede sempre un'infrastruttura di livello produttivo.
Per un breve progetto di ricerca, un proof of concept o un esperimento interno di portata limitata, uno scraper di base potrebbe essere sufficiente per rispondere alla domanda su cui il team sta conducendo i test.
La situazione cambia se quello script temporaneo inizia a diventare una fonte di dati ricorrente. A quel punto, le attività di manutenzione di cui si è parlato in precedenza assumono maggiore importanza.
Il controllo completo dell'infrastruttura è fondamentale
Alcuni team hanno bisogno di un controllo diretto sulle modalità di invio delle richieste, sul luogo in cui vengono elaborati i dati, sulle modalità di archiviazione dei log o sul comportamento del sistema in caso di errore in un’operazione.
Tali requisiti possono derivare da standard tecnici interni, politiche di sicurezza o dall'architettura del prodotto.
Se è necessario quel livello di controllo, la realizzazione interna può risultare più facile da giustificare, anche quando comporta un maggiore carico di lavoro di manutenzione.
La raschiatura fa parte del prodotto
Per alcune aziende, lo scraping non è solo un modo per raccogliere dati di input. Il sistema di estrazione stesso fa parte di ciò che l'azienda sviluppa e gestisce.
Un team che sta sviluppando un proprio prodotto basato sui dati, un crawler o una piattaforma di estrazione potrebbe avere motivi più validi per disporre della tecnologia sottostante.
In tale situazione, l'attività di ingegneria supporta direttamente il prodotto, anziché svolgersi parallelamente al lavoro principale del team.
L'approccio "fai da te" è la scelta più sensata quando quel controllo aggiuntivo ha uno scopo ben preciso. Se lo scraper serve solo a fornire dati a un altro flusso di lavoro, diventa più difficile giustificare l'utilità di disporre di un livello di estrazione dedicato.
Quando è più opportuno utilizzare uno scraper gestito di Google Maps
Uno scraper gestito risulta più pratico quando il team ha bisogno dei dati con regolarità, ma non vuole occuparsi della gestione dei sistemi che garantiscono il funzionamento del processo di estrazione.
Esegui attività ricorrenti
Un'estrazione di dati una tantum è più facile da gestire rispetto a un flusso di lavoro che viene eseguito ogni settimana o ogni giorno.
I processi ricorrenti aumentano il rischio di richieste bloccate, risultati parziali, batch non riusciti e modifiche nell'analisi dei dati che potrebbero interrompere il processo. Uno scraper gestito può ridurre il carico di lavoro interno necessario per garantire il corretto funzionamento di tali processi.
Sono necessari set di dati più numerosi o più grandi
L'onere di manutenzione aumenta quando lo stesso flusso di lavoro deve coprire un numero maggiore di ricerche, sedi o record.
A quel punto, la sfida non si limita più alla logica di estrazione. Il team deve anche gestire i tentativi di riesecuzione, il monitoraggio dei lavori, l’infrastruttura e i controlli sui risultati su un volume di lavoro più ampio.
Un servizio gestito può risultare più facile da giustificare quando il team ha bisogno di un accesso costante ai dati aziendali senza dover ampliare internamente la configurazione di scraping.
Il tuo team ha bisogno dei dati, non dello scraper
Molti team utilizzano i dati aziendali di Google Maps come input per un'altra attività.
Ciò può includere la generazione di lead, le ricerche di mercato, l’analisi delle attività commerciali locali, i database interni o le funzionalità delle applicazioni. In tali flussi di lavoro, la manutenzione dello scraper non migliora direttamente l’utilizzo finale dei dati.
Outscraper servizio gestito di estrazione dei dati da Google Maps Si adatta a questo tipo di configurazione occupandosi della fase di estrazione mentre l'utente lavora con i dati aziendali ottenuti.
È necessario un accesso ai dati basato su API
Le esportazioni manuali possono essere sufficienti per ricerche occasionali, ma i flussi di lavoro ricorrenti richiedono spesso che i dati vengano trasferiti automaticamente in un altro sistema.
Un'API consente a un'applicazione o a un processo interno di richiedere dati in modo programmatico e di continuare a lavorare con i risultati ottenuti dopo l'estrazione.
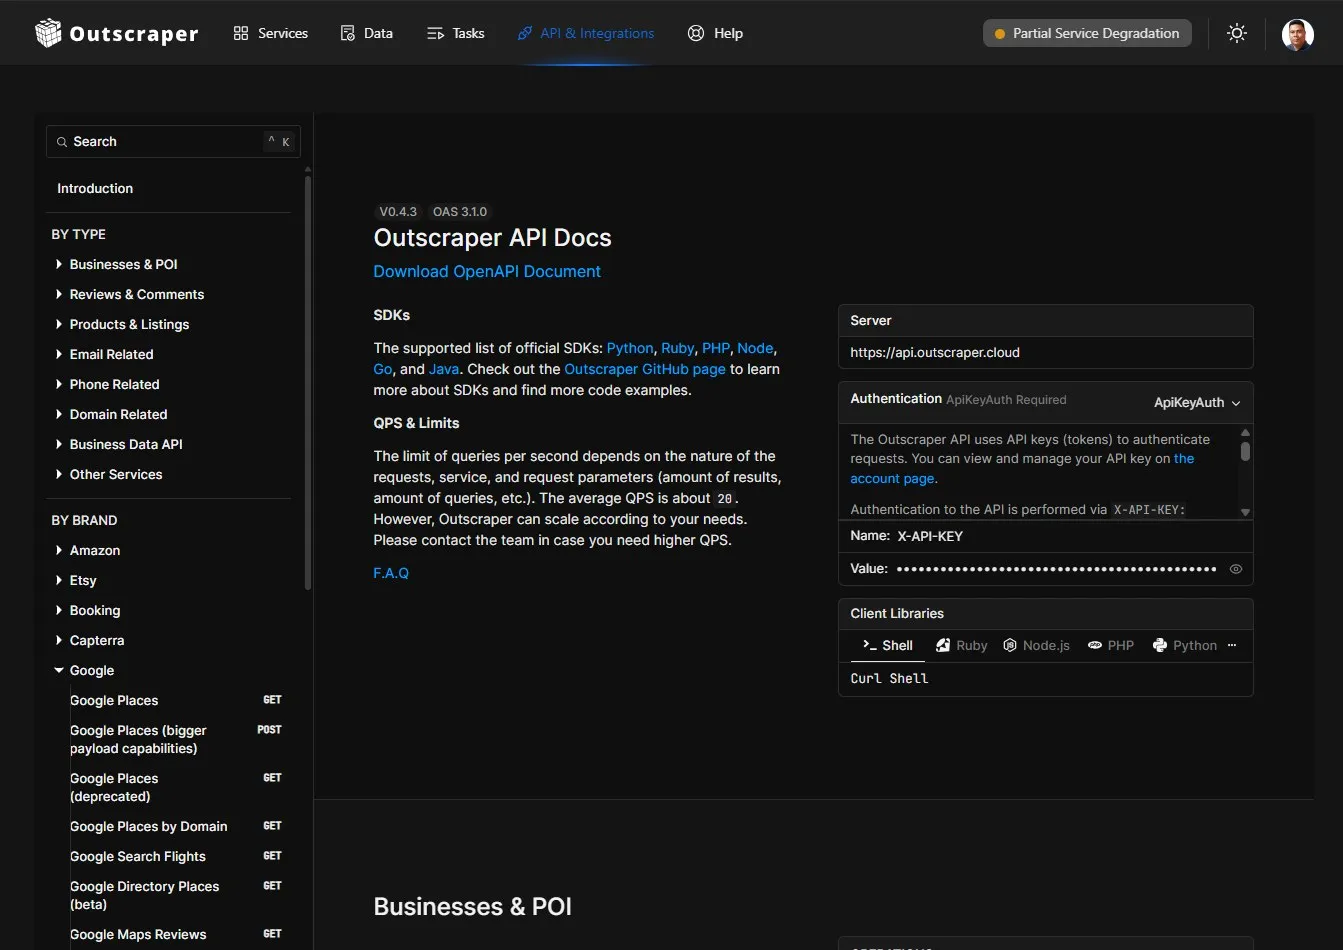
Gli sviluppatori possono consultare il Documentazione dell'API Outscraper per gli endpoint, i parametri, le risposte e gli esempi di codice attuali.
Ciò consente agli sviluppatori di avere il controllo sulle parti rilevanti all'interno del proprio sistema senza dover gestire lo scraper di Google Maps sottostante.
È meglio dedicare il tempo all’ingegneria nelle fasi successive
Il costo di manutenzione di uno scraper comprende anche il lavoro che gli sviluppatori non svolgono altrove.
Un team potrebbe trarre maggiori vantaggi dedicando le risorse ingegneristiche alla progettazione di database, agli strumenti interni, alla creazione di report, all’arricchimento dei dati, all’analisi o alle funzionalità di prodotto sviluppate sulla base dei dati raccolti.
Uno scraper gestito risulta la soluzione più indicata quando il livello di estrazione è necessario ma non è fondamentale per ciò che il team sta cercando di realizzare.
Utilizza Outscraper per la raccolta periodica di dati da Google Maps, mantenendo al contempo i tuoi flussi di lavoro relativi alla generazione di lead, alla ricerca, al database o alle applicazioni.
È meglio creare uno scraper per Google Maps o utilizzare un servizio gestito?
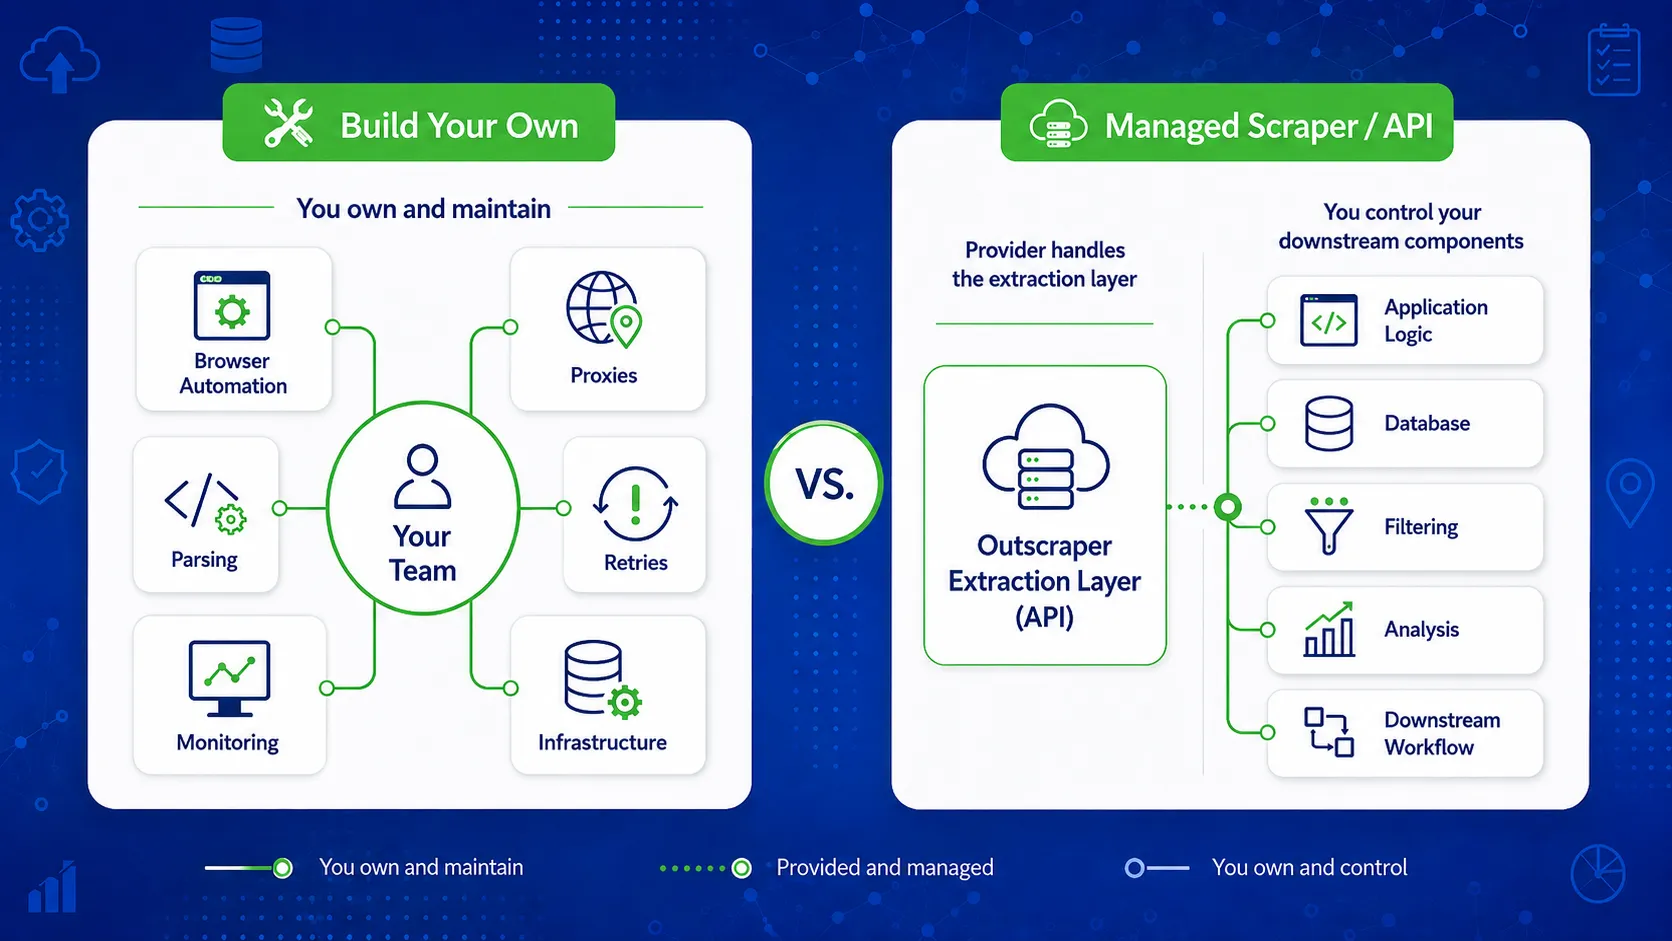
La scelta risulta più semplice se si confronta chi è responsabile di ciascuna fase del flusso di lavoro.
| Fattore | Crea il tuo | Scraper gestito / API |
|---|---|---|
| Controllo dell'estrazione | Pieno controllo | In base alle capacità del fornitore |
| Lavori preliminari di ingegneria | Più alto | In basso |
| Manutenzione del browser | Il tuo team | Fornitore |
| Gestione delle deleghe | Il tuo team | Fornitore |
| Modifiche all’analisi sintattica | Il tuo team | Fornitore |
| Gestione dei tentativi di ripetizione | Il tuo team | Di solito a carico del fornitore |
| Monitoraggio | Il tuo team | Il provider gestisce il livello di estrazione |
| Personalizzazione del flusso di lavoro | Il più alto | Valori elevati relativi all'API e alla produzione |
| Ridimensionamento | Richiede un maggiore lavoro di progettazione | Di solito è più facile da ampliare |
| La taglia più adatta | Squadre con requisiti tecnici specifici | Team incentrati sull'utilizzo dei dati |
Nessuna delle due opzioni è automaticamente migliore. La scelta giusta dipende dal livello di controllo di cui il vostro team ha bisogno e dalla quantità di attività di manutenzione che desidera gestire internamente.
Una terza opzione: creare il flusso di lavoro, non lo scraper
La scelta non deve necessariamente limitarsi a realizzare tutto da soli o ad affidare l’intero flusso di lavoro a un fornitore.
Un team può mantenere il controllo sulla propria applicazione, sulla logica di interrogazione, sull'archiviazione, sul filtraggio, sull'arricchimento e sull'elaborazione a valle, utilizzando al contempo un'API di scraper gestita per la fase di estrazione.
Per gli aspetti tecnici di questa configurazione, vedi come API Outscraper può essere utilizzato all'interno flussi di lavoro personalizzati per i dati.
Una configurazione potrebbe presentarsi in questo modo:
La tua applicazione o automazione
→ API di scraper gestita
→ Dati aziendali di Google Maps
→ Il vostro database, CRM, strumento di reporting o sistema interno.
Questo approccio può essere adatto agli sviluppatori e ai team che si occupano di dati che desiderano un accesso programmatico senza doversi occupare della gestione di browser, proxy, logiche di analisi e infrastrutture di estrazione.
Il team mantiene il controllo sull'utilizzo dei dati dopo la raccolta. Il fornitore si occupa della parte relativa alla raccolta stessa.
Mantieni il controllo sulla logica applicativa, l'archiviazione, il filtraggio e l'elaborazione a valle, mentre Outscraper si occupa dell'estrazione dei dati da Google Maps.
Domande da porsi prima di scegliere
La scelta tecnica risulta più semplice se si definisce come verrà utilizzato lo scraper, chi se ne occuperà e cosa succede quando il flusso di lavoro smette di funzionare come previsto.
Con quale frequenza lo utilizzerai?
Un scraper utilizzato per un lavoro di ricerca una tantum presenta requisiti diversi rispetto a uno che viene eseguito ogni giorno o ogni settimana.
I processi ricorrenti comportano un maggiore carico di lavoro di manutenzione, poiché i guasti, le modifiche all'analisi sintattica e i problemi infrastrutturali hanno maggiori possibilità di interrompere il processo.
Di quanti dati hai bisogno?
È più semplice gestire alcune ricerche per un test interno piuttosto che raccogliere dati aziendali da centinaia di sedi o categorie.
Con l'aumentare del volume, il tracciamento dei processi, i tentativi di esecuzione, l'utilizzo dei proxy, lo spazio di archiviazione e il monitoraggio assumono un peso sempre maggiore nel carico di lavoro.
Quanto sono specifici i vostri requisiti di estrazione?
Elenca i campi e le regole di estrazione necessari prima di decidere di procedere alla creazione.
Se le tue esigenze dipendono da un comportamento insolito delle pagine o da campi che i provider gestiti non supportano, potrebbe essere più giustificabile ricorrere a uno scraper personalizzato.
Se i dati aziendali necessari sono già disponibili tramite un servizio gestito, gestire autonomamente la logica di estrazione potrebbe comportare un carico di lavoro aggiuntivo senza apportare grandi vantaggi.
Chi se ne occupa quando qualcosa si rompe?
Qualcuno deve assumersi la responsabilità quando un lavoro viene interrotto, un settore scompare o la produzione subisce cambiamenti.
Prima di considerare un raschietto fai-da-te come un progetto completato, occorre individuare la persona o il team responsabile. Il lavoro di manutenzione richiede un referente, proprio come qualsiasi altro sistema di produzione.
Hai bisogno di un'API?
Un'API è importante quando un'altra applicazione, un database o un sistema di automazione deve richiedere dei dati senza che qualcuno debba avviare e scaricare manualmente ogni singolo processo.
È proprio qui che la scelta relativa alla compilazione può cambiare. Un team può comunque scrivere la propria applicazione utilizzando un’API gestita per la fase di estrazione.
Quanto costa il tempo dedicato alla progettazione?
I costi relativi ai proxy e ai server sono spese evidenti. Il tempo dedicato all’ingegneria è invece più facile da trascurare.
Stimare il tempo necessario per il monitoraggio, il debug, i test, il ripristino e le modifiche future. Quindi confrontare tale carico di lavoro con le altre attività di cui sono responsabili gli stessi ingegneri.
Cosa succede quando i progetti falliscono?
Prevedete sia risultati parziali che fallimenti totali.
Chiedi in che modo il sistema individuerà i record mancanti, riproverà a completare il lavoro non terminato, impedirà la duplicazione dei dati e avviserà il team quando un’attività richiede un intervento.
Uno scraper che funziona quando tutto va per il meglio è solo una parte del flusso di lavoro di produzione.
Quali sono i requisiti legali, contrattuali o relativi all'utilizzo dei dati applicabili?
Le regole relative allo scraping possono dipendere dalla fonte, dai suoi termini, dal tipo di dati raccolti, dalla giurisdizione e dall'uso che verrà fatto dei dati.
Google pubblica anche il proprio Condizioni di servizio di Google Maps Platform e le relative linee guida, che dovrebbero essere consultate quando un flusso di lavoro si avvale dei servizi di Google Maps Platform.
Esamina i requisiti applicabili al tuo specifico flusso di lavoro prima di decidere in che modo i dati saranno raccolti o trattati. La presente sezione non costituisce un parere legale.
Lista di controllo per le decisioni relative allo scraper di Google Maps
- Indica con quale frequenza ti servono i dati.
- Elenca i campi e le regole di estrazione che ti servono.
- Stimare i costi dei lavori di manutenzione e di ingegneria.
- Decidete chi sarà responsabile degli errori e delle relative soluzioni.
- Verificare se è necessario l'accesso all'API programmatica.
- Confronta i vantaggi di un controllo completo dello scraper con il lavoro necessario per mantenerlo.
- Esamina le regole applicabili al tuo flusso di lavoro dei dati.
Outscraper può occuparsi del livello di estrazione dei dati da Google Maps, mentre il vostro team si concentra sull'utilizzo dei dati per la generazione di lead, la ricerca, i database o le applicazioni.
Domande frequenti
Domande e risposte più frequenti
Realizzare un prototipo di scraper di base può essere relativamente semplice. La parte più difficile è garantirne l’affidabilità nel corso di operazioni ripetute, richieste bloccate, modifiche alle pagine, tentativi di recupero e carichi di lavoro più consistenti.
La difficoltà dipende dalla frequenza di esecuzione, dalla quantità di dati raccolti e dalla manutenzione richiesta dal flusso di lavoro.
Non esiste un costo unico valido per tutti i progetti.
Il costo totale dipende dal tempo dedicato alla progettazione, dai proxy, dai server, dallo spazio di archiviazione, dal monitoraggio, dalla manutenzione e dal recupero dei lavori non riusciti. Un breve test interno può costare molto meno di uno scraper che funziona ininterrottamente come parte di un sistema di produzione.
Dipende dal carico di lavoro.
Uno scraper fai-da-te può avere un costo iniziale inferiore quando il progetto è di piccole dimensioni e si dispone già delle risorse ingegneristiche necessarie. Uno scraper gestito può rivelarsi più pratico se nel confronto si tengono conto della manutenzione periodica, dei costi dei proxy, dei lavori non andati a buon fine e del tempo impiegato dagli sviluppatori.
Sì. Uno sviluppatore può realizzare l'applicazione, il database, i filtri, le regole di business e l'elaborazione a valle, utilizzando al contempo un'API di scraping gestita per l'estrazione dei dati. Outscraper supporta questo tipo di configurazione grazie ai propri servizi di estrazione dati e API.
Questo approccio ti permette di mantenere il controllo sulla logica dell'applicazione senza che il tuo team debba occuparsi della manutenzione del livello di scraping.
“Il termine ”sicuro” può riferirsi a diversi aspetti.
Prima di scegliere un fornitore, verifica come vengono eseguiti i processi, se il tuo indirizzo IP o il tuo account Google vengono esposti, come vengono gestite le credenziali API e i dati raccolti, cosa succede in caso di errore nei processi e quali requisiti legali o contrattuali si applicano al tuo caso d’uso.
Un servizio di terze parti dovrebbe essere valutato in base a tali criteri, anziché essere considerato sicuro semplicemente perché è gestito.
Sì, a seconda dei dati e del flusso di lavoro di cui hai bisogno.
Le API di Google Maps Platform e il web scraping sono modi diversi di accedere alle informazioni relative ai luoghi, con ambiti di applicazione, limiti, costi e regole di utilizzo diversi. Se questa è la decisione principale che devi prendere, la guida dedicata Confronto tra l'API di Google Maps e il web scraping è il contesto più adatto per esaminare tali differenze.