目录
A 谷歌地图抓取工具 今天可能返回数千条记录,但稍后执行同一任务时却会失败,因为提取过程的一部分发生了变化。
被拦截的请求、代理问题、验证码、批处理失败以及解析规则的变更,都会产生维护工作。一旦爬虫成为定期工作流的一部分,就必须有人来监控任务、修复故障、管理基础设施,并确保数据提取逻辑正常运行。
在首次构建过程中,人们很容易忽视这项持续进行的工作。当数据提取要求不寻常,或者数据抓取已经是工程师日常维护工作的一部分时,团队可能会很乐意承担这项工作。
当谷歌地图数据仅作为潜在客户开发、调研、数据库或内部应用程序的输入之一时,决策就变得更加困难。在这种情况下,用于维持数据提取层运行所花费的时间,便成为数据本身成本的一部分。
简答:你应该自己开发一个谷歌地图抓取工具吗?
- 动手做吧 用于自定义提取和全面控制。
- 使用托管式爬虫 以减少维护工作。
- 使用托管 API 在无需维护爬虫的情况下,保持您自己的工作流程。
- 比较控制、维护、工作量和工程时间 在做出决定之前。
维护一个自制的谷歌地图抓取工具需要做些什么
编写爬虫程序的第一个版本只是工作的一部分。一旦它开始反复运行,维护工作就会转向数据提取过程周边的方方面面。
自建系统可能需要浏览器自动化、代理管理、重试逻辑、监控,以及在页面行为发生变化时进行定期修复。当爬虫用于定期潜在客户开发、市场调研或内部数据工作流时,这些任务就会显得尤为重要。
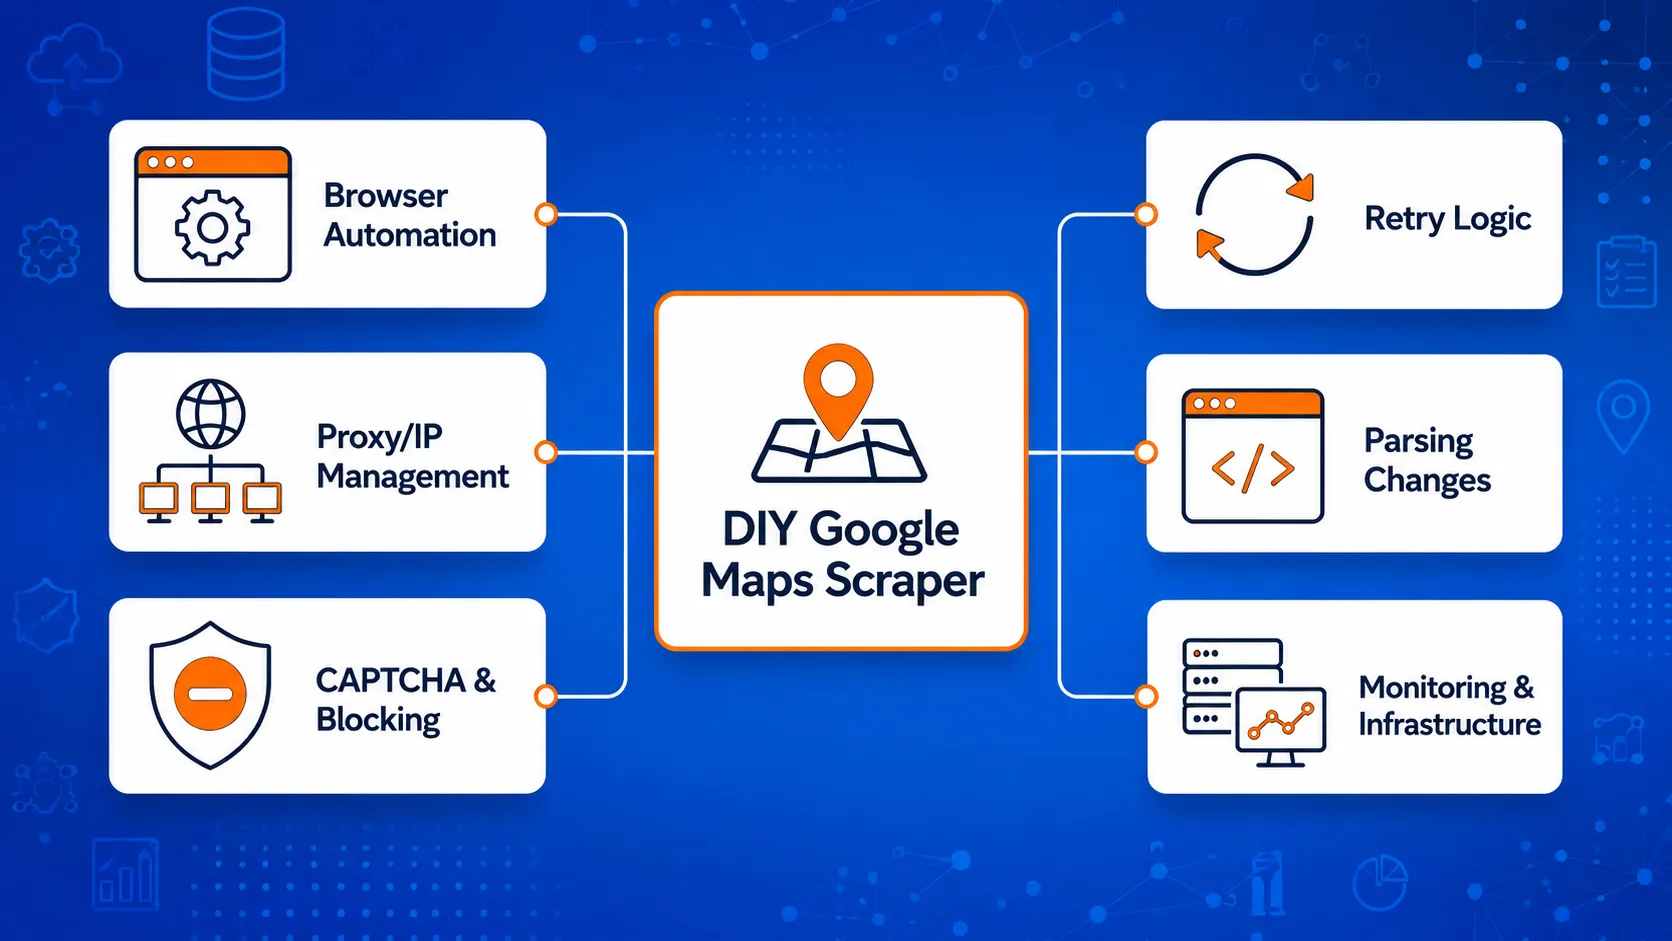
浏览器自动化与数据提取逻辑
Google 地图在很大程度上依赖于动态页面内容,因此许多自制的爬虫工具都依赖于浏览器自动化或类似方法来加载和收集数据。
提取逻辑还必须识别正确的元素、处理滚动或重复加载的情况,并返回工作流所期望的字段。如果页面结构发生变化,该逻辑的某些部分可能需要更新。
如果您想更详细地了解技术配置,请参阅我们的指南: 使用 Python 抓取 Google 地图数据 涵盖基于浏览器的数据提取及其相关支持工作。
代理和IP管理
反复提出请求可能会给知识产权管理工作增加额外的工作量。
运行自有爬虫的团队可能需要管理代理池、移除故障代理、跟踪被拦截的请求,并决定请求的分配方式。代理质量也会影响任务完成的可靠性。
在小范围内,这或许尚可应对。但当爬虫涉及大量搜索或位置时,这个问题就难以忽视了。
验证码与屏蔽
验证码和被拦截的请求可能会导致提取任务在完成前中断。
因此,生产工作流需要一种方法来检测这些故障,并决定后续该如何处理。某些请求可能需要重试、延迟处理,或者通过其他IP地址进行转发。
如果不进行这种处理,刮取工具虽然看似成功,但返回的数据集仍可能不完整。
重试和失败的任务
处理一个失败的请求通常比处理一个部分完成的工作要容易。
例如,在处理一个大型批次时,抓取工具可能已完成80%的工作,随后流程的某一部分停止了。此时,系统需要了解哪些操作成功、哪些失败,以及哪些操作需要重新执行,同时避免产生不必要的重复。
这不仅需要提取代码本身,还需要任务跟踪和重试规则。
解析更改
该爬虫还取决于它预期会找到的结构。
标签、页面元素或数据加载方式的任何变化都可能影响解析器返回的字段。抓取程序可能仍在运行,但会悄无声息地生成缺失或映射错误的值。
因此,需要定期进行检查,以确认输出结果是否仍符合下游系统的预期。
基础设施与监控
一旦某个爬虫开始处理周期性任务,就必须有人持续监控它是否仍在正常运行。
这可能包括服务器、日志、存储、任务状态、警报、失败的批处理以及输出检查。当数据需要传输到另一个系统时,监控就显得尤为重要,因为提取失败的情况可能无法立即被察觉。
这是自制谷歌地图数据抓取工具中一个容易被低估的部分。用于收集数据的代码只是其中的一环。该团队还拥有确保数据收集过程持续运行所需的系统。
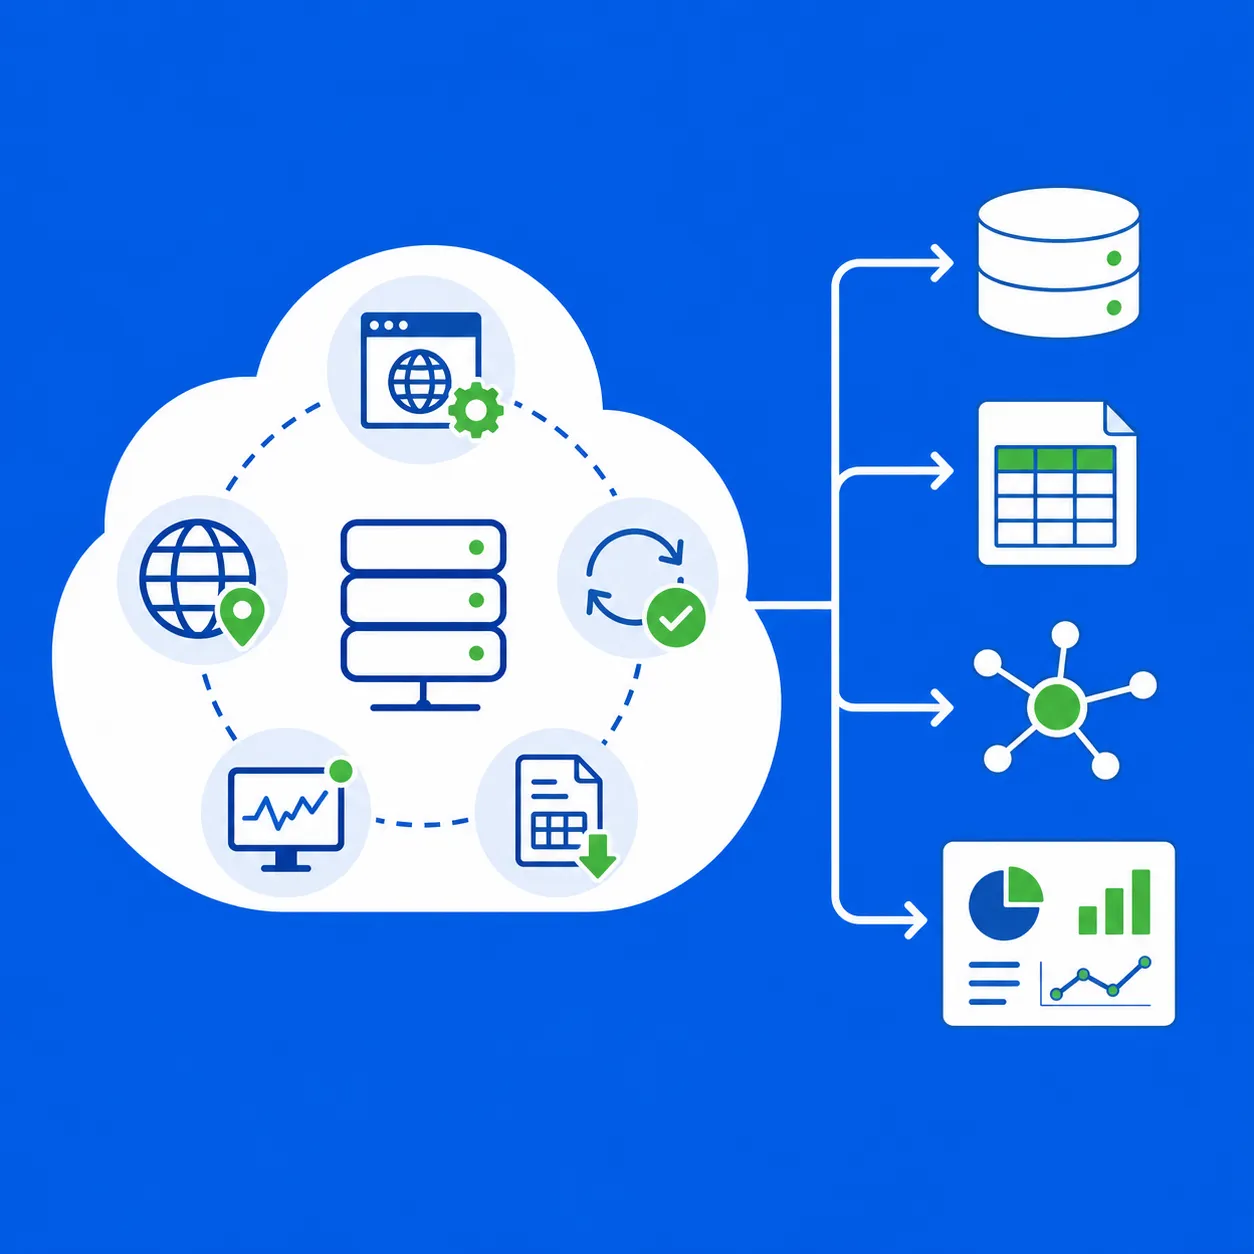
Outscraper 负责处理 Google 地图数据提取层,这样您的团队就可以直接利用生成的商业数据,而无需维护数据抓取基础设施。
开发自己的谷歌地图抓取工具需要多少成本?
自建爬虫的成本远不止于编写代码的第一个版本。一旦爬虫支持定期任务,团队还需为维持其运行所需的系统和工程时间支付费用。
将构建该爬虫的成本与维持其运行的成本进行比较。
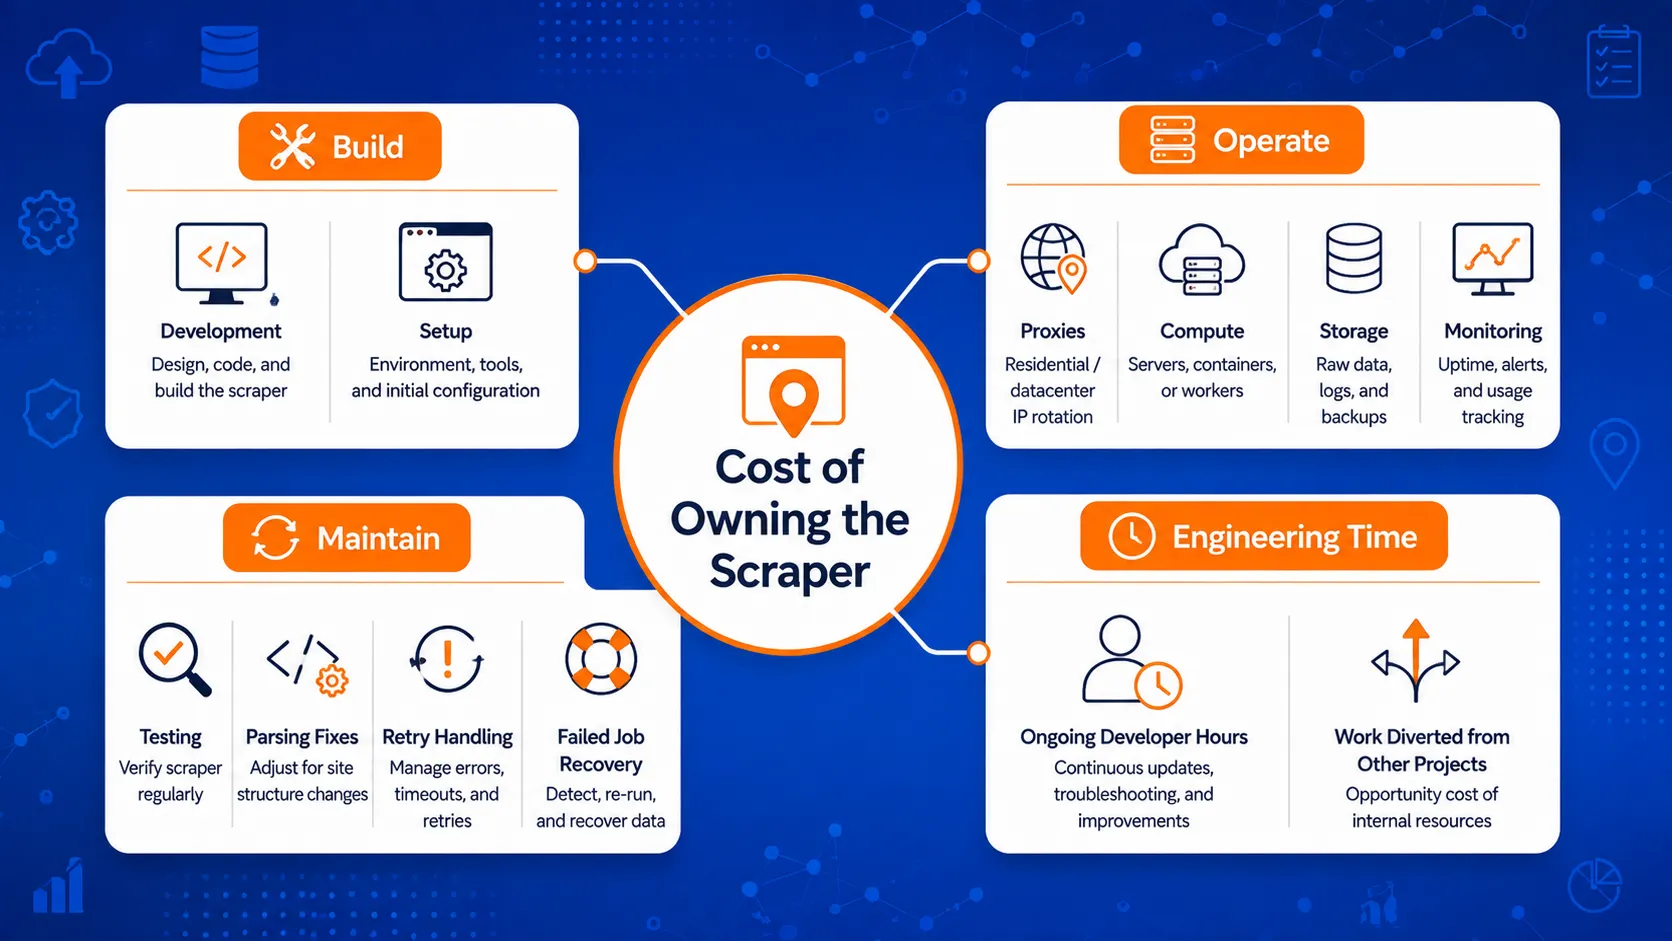
初期工程时间
第一个构建版本可能不仅包含提取脚本本身。
工程师可能还需要配置浏览器自动化、请求处理、代理路由、数据存储、重试规则、日志记录和输出检查。工作量取决于爬虫需要收集的数据量以及工作流所需达到的可靠性程度。
一次小规模的内部测试与每周向生产数据库导入数据的爬虫在要求上大不相同。
代理和基础设施成本
定期抓取可能需要付费基础设施,例如代理、服务器、存储和监控。
这些成本可能会随着搜索次数、位置数量以及需要收集的记录数量的增加而上升。此外,当爬虫需要额外资源来处理更大规模的任务或处理请求失败的情况时,这些成本也会发生变化。
关键在于,基础设施在开发完成后通常仍属于运营成本的一部分。
维护时间
当数据抓取行为发生变化,或者输出结果不再符合预期时,就需要对数据抓取工具进行检查。
该工作可能包括:
- 修复选择器或解析规则
- 替换故障代理服务器
- 检查未完成的任务
- 更新浏览器自动化功能
- 查看日志
- 在运行下一批任务之前测试更改
当刮取工具成为周期性数据处理流程的一部分时,即使是短暂的修复也会逐渐累积。
故障与恢复成本
失败的任务也会消耗时间。
需要有人查明问题出在哪里,确定哪些记录已经收集完毕,重新处理缺失的部分,并检查最终输出结果中是否存在遗漏或重复。
当一个失败的批处理任务导致其他流程延迟时,这一点就显得尤为重要,例如潜在客户名单的准备、市场调研,或者依赖这些数据的内部应用程序。
工程机会成本
工程时间还有另一项成本:开发人员在维护爬虫期间无法完成的工作。
一个团队可能会更倾向于利用这些时间来构建报表工具、优化数据库、增加数据丰富化步骤,或者围绕收集到的数据开发新功能。
因此,刮板机的维护既是一个技术决策,也是一个商业决策。
| 成本区域 | 在初始构建期间 | 在持续使用期间 |
|---|---|---|
| 工程学 | 提取逻辑与设置 | 修复、测试和更新 |
| 代理 | 设置与测试 | 反复使用 |
| 基础设施 | 服务器、存储、日志记录 | 托管与监控 |
| 就业复苏 | 重试逻辑 | 失败和部分完成的作业 |
| 数据核查 | 输出设置 | 字段缺失或填写错误 |
| 工程时间 | 构建抓取工具 | 维持萃取过程 |
若要将这些内部成本与托管方案进行比较,您还可以查看如何 Google Maps Scraper 定价 其工作原理以及哪些设置会影响任务成本。
起初看似成本最低的方案,一旦将维护成本、任务失败以及工程时间等因素考虑在内,可能就不再是最经济的方案了。
何时选择“自己动手”更明智
当数据提取工作本身对产品至关重要,或者团队有明确的理由需要掌控整个系统时,自行开发数据抓取工具仍可能是更好的选择。
您需要高度定制的提取逻辑
虽然托管式数据抓取工具可能涵盖了大多数团队所需的字段和工作流,但某些项目需要针对特定应用程序制定的提取规则。
这可能包括非标准的解析逻辑、自定义页面行为、特殊的验证步骤,或者围绕标准提供商无法返回的数据构建的工作流。
在这种情况下,拥有该数据抓取工具能让工程团队在调整数据提取方式时拥有更大的自由度。
贵公司已经拥有内部数据抓取工程师
如果一家公司已经配备了负责系统数据抓取的工程师,那么维护负担的情况就会有所不同。
他们可能已经拥有代理基础设施、监控系统、重试逻辑、存储以及用于处理任务失败的内部工具。在这种架构中添加一个 Google 地图抓取工具,可能比引入另一项外部服务更为合理。
关键问题在于,团队是否有闲置资源来维护它,同时又不影响优先级更高的工作。
该工作流范围较窄或处于试验阶段
一个小型测试并不总是需要生产级的基础设施。
对于短期研究项目、概念验证或有限的内部实验而言,一个基本的爬虫工具可能就足以解答团队正在测试的问题。
如果该临时脚本开始成为一个定期的数据源,情况就会有所不同。届时,前面提到的维护工作就会变得更加重要。
全面掌控基础设施至关重要
有些团队需要直接控制请求的发起方式、数据的处理位置、日志的存储方式,以及任务失败时系统的响应方式。
这些要求可能源于内部工程标准、安全政策或产品架构。
如果需要这种程度的控制,即使自建系统会带来更多的维护工作,其必要性也更容易得到证明。
数据抓取是产品的一部分
对于一些公司而言,数据抓取不仅仅是一种收集输入数据的方式。数据提取系统本身就是该公司构建和维护的组成部分之一。
对于正在开发自有数据产品、爬虫或数据提取平台的团队而言,拥有底层技术可能更有必要。
在这种情况下,工程工作直接支持产品,而不是与团队的主要工作并行开展。
当额外的控制有明确目的时,选择 DIY 方式才是最合理的。如果数据抓取工具仅是为了向另一个工作流提供数据而存在,那么拥有数据提取层的价值就更难得到合理解释。
何时使用托管版 Google 地图抓取工具更为合理
当团队需要定期获取数据,但又不希望自己负责维护确保数据提取流程正常运行的系统时,托管式数据抓取工具就显得更为实用。
您正在运行定期任务
一次性数据提取比每周或每天运行的工作流更容易管理。
周期性任务会增加请求被阻塞、结果不完整、批处理失败以及解析变更导致流程中断的风险。使用托管式爬虫可以减少为维持这些任务运行所需的内部工作量。
您需要重复或规模更大的数据集
当同一个工作流需要处理更多的检索、位置或记录时,维护负担就会增加。
此时,面临的挑战已不再仅限于数据提取逻辑。团队还必须在更大规模的工作量下,管理重试机制、任务跟踪、基础设施以及输出检查。
当团队需要可重复访问业务数据,且无需在内部扩充数据抓取配置时,采用托管服务往往更容易获得认可。
您的团队需要的是数据,而不是数据抓取工具
许多团队将谷歌地图的商家数据作为另一项任务的输入。
这可能包括潜在客户开发、市场调研、本地业务分析、内部数据库或应用程序功能。在这些工作流程中,维护数据抓取工具并不会直接提升数据的最终使用效果。
Outscraper的 托管式谷歌地图数据提取服务 该方案非常适合此类配置,它负责处理数据提取环节,而用户则可直接处理生成的业务数据。
您需要基于 API 的数据访问
对于偶尔进行的研究,手动导出可能就足够了,但对于重复性工作流程,通常需要将数据自动导入另一个系统。
API 可以让应用程序或内部进程通过编程方式请求数据,并在提取结果后继续处理这些结果。
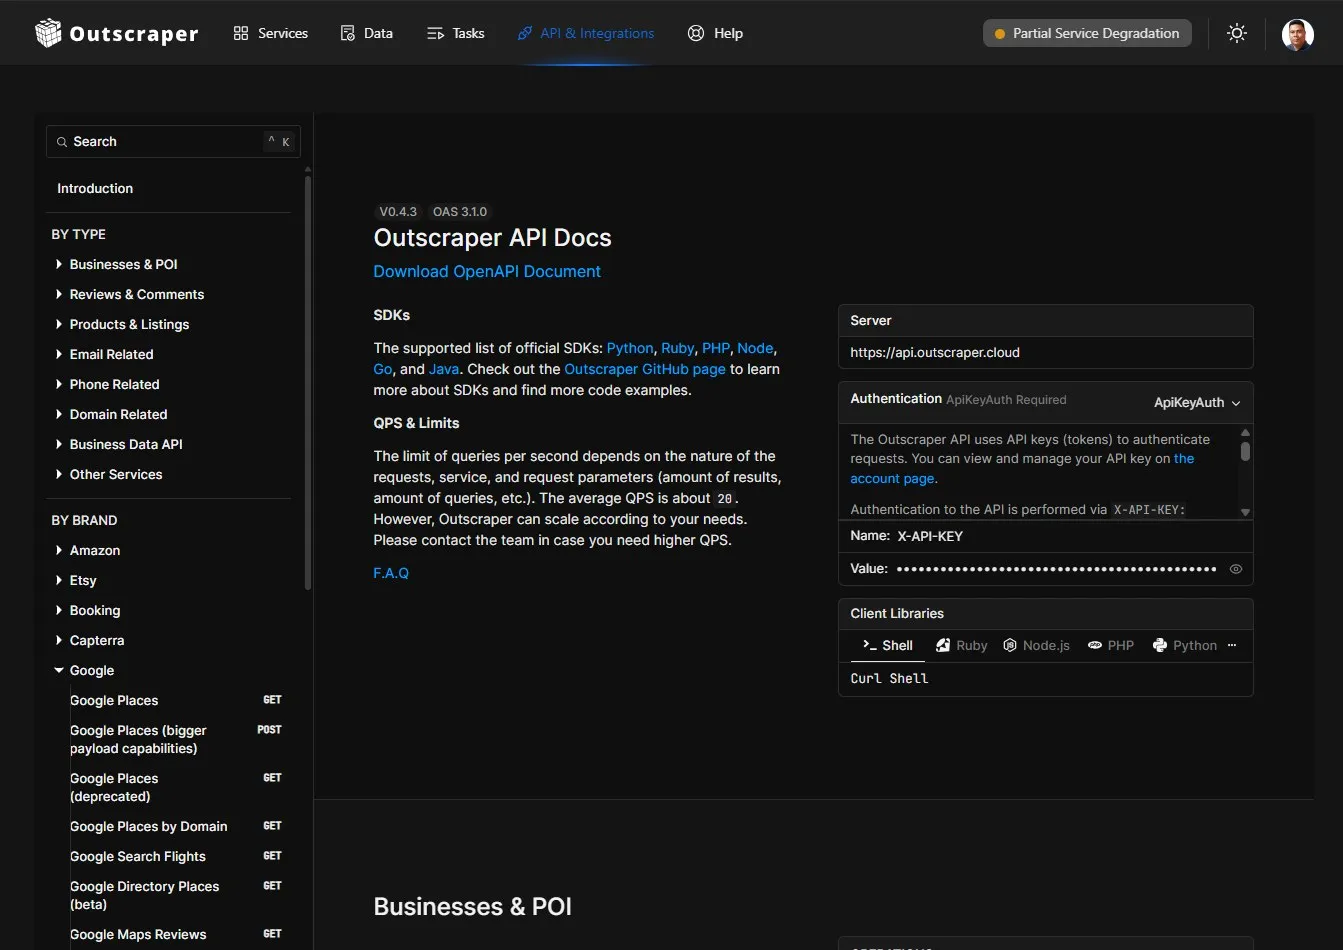
开发人员可以查看 Outscraper API 文档 了解当前的端点、参数、响应及代码示例。
这使开发者能够控制自身系统中关键的部分,而无需维护底层的 Google 地图抓取工具。
工程时间最好用于下游环节
维护爬虫的成本还包括开发人员本可以用于其他工作的时间。
团队若将工程时间投入到数据库设计、内部工具、报表生成、数据增强、分析,或是围绕收集到的数据构建的产品功能上,可能会获得更大的收益。
当需要提取层,但该层并非团队正在构建的核心部分时,受管抓取器便能发挥最大的作用。
使用 Outscraper 进行定期的 Google 地图数据采集,同时确保您的潜在客户开发、调研、数据库或应用程序工作流正常运行。
是应该开发一个谷歌地图数据抓取工具,还是使用托管服务?
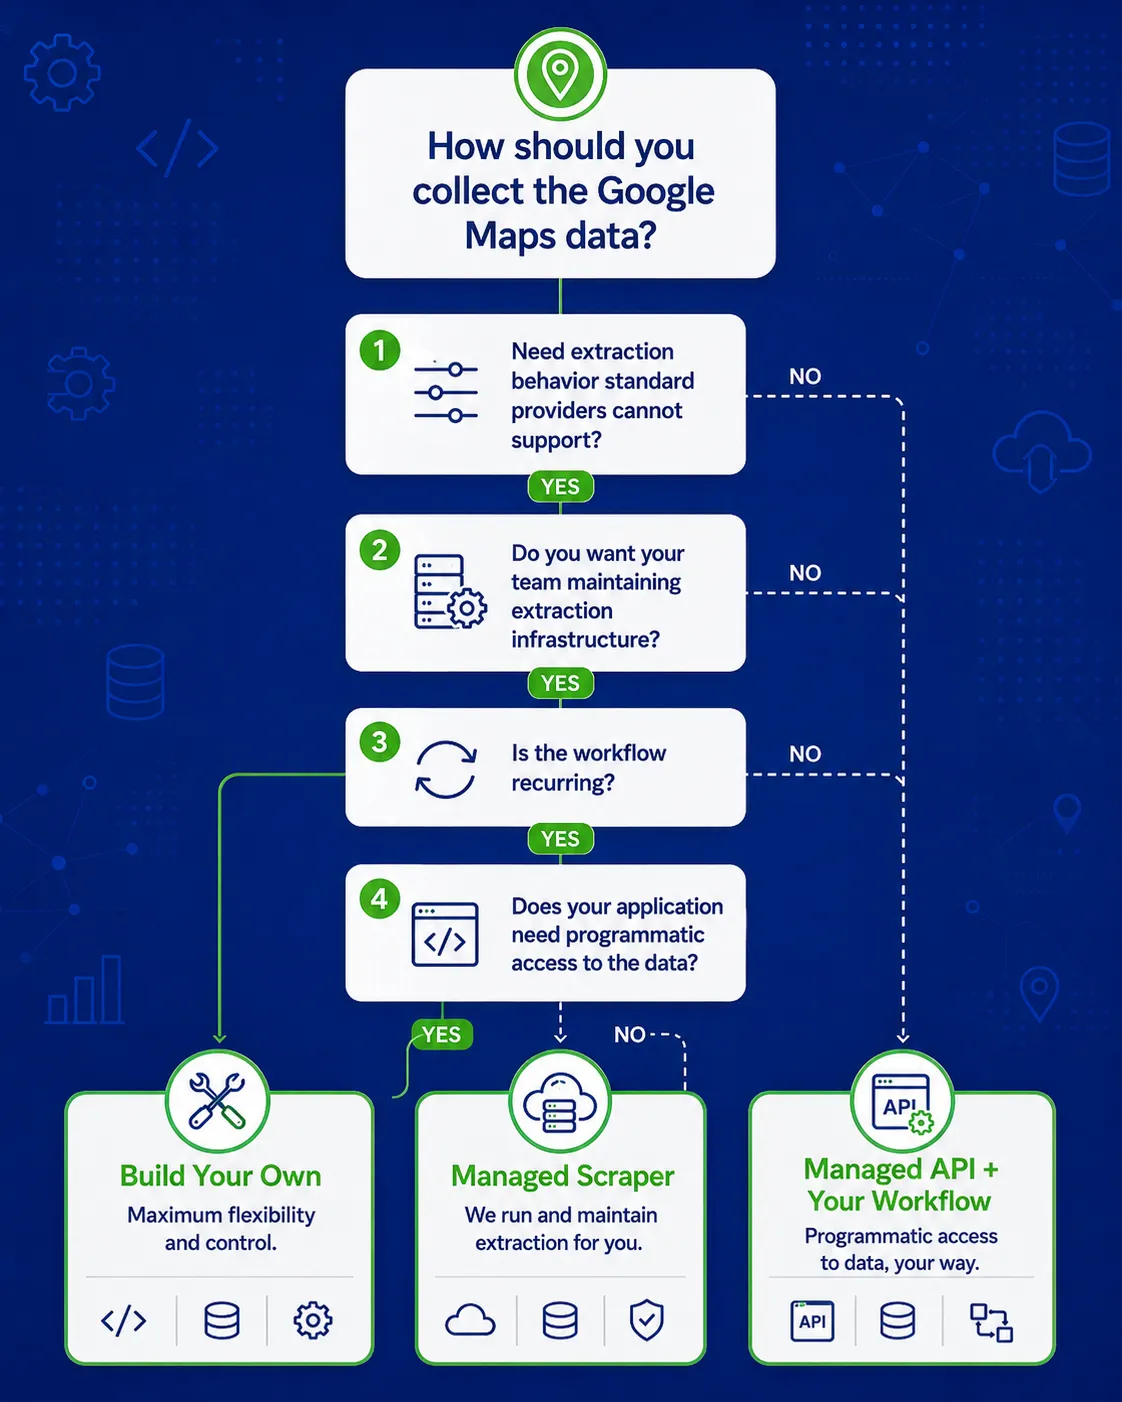
通过比较工作流中各部分的负责人,选择就会变得更容易。
| 因子 | 打造属于你自己的 | 托管式数据抓取工具 / API |
|---|---|---|
| 萃取控制 | 完全控制 | 受服务提供商能力限制 |
| 初步工程工作 | 更高 | 较低 |
| 浏览器维护 | 您的团队 | 服务提供商 |
| 代理管理 | 您的团队 | 服务提供商 |
| 解析更改 | 您的团队 | 服务提供商 |
| 重试处理 | 您的团队 | 通常由服务提供商负责 |
| 监测 | 您的团队 | 提供程序负责处理提取层 |
| 工作流自定义 | 最高 | API 和输出值较高 |
| 扩展 | 需要更多的工程设计 | 通常更容易扩展 |
| 最佳匹配 | 有特定技术要求的团队 | 专注于利用数据的团队 |
这两种方案并没有哪一种自动就更好。正确的选择取决于您的团队需要多少控制权,以及希望将多少维护工作保留在内部处理。
第三种选择:构建工作流,而非构建爬虫
这一决定不必局限于完全自己构建一切,也不必将整个工作流程全权交给服务提供商。
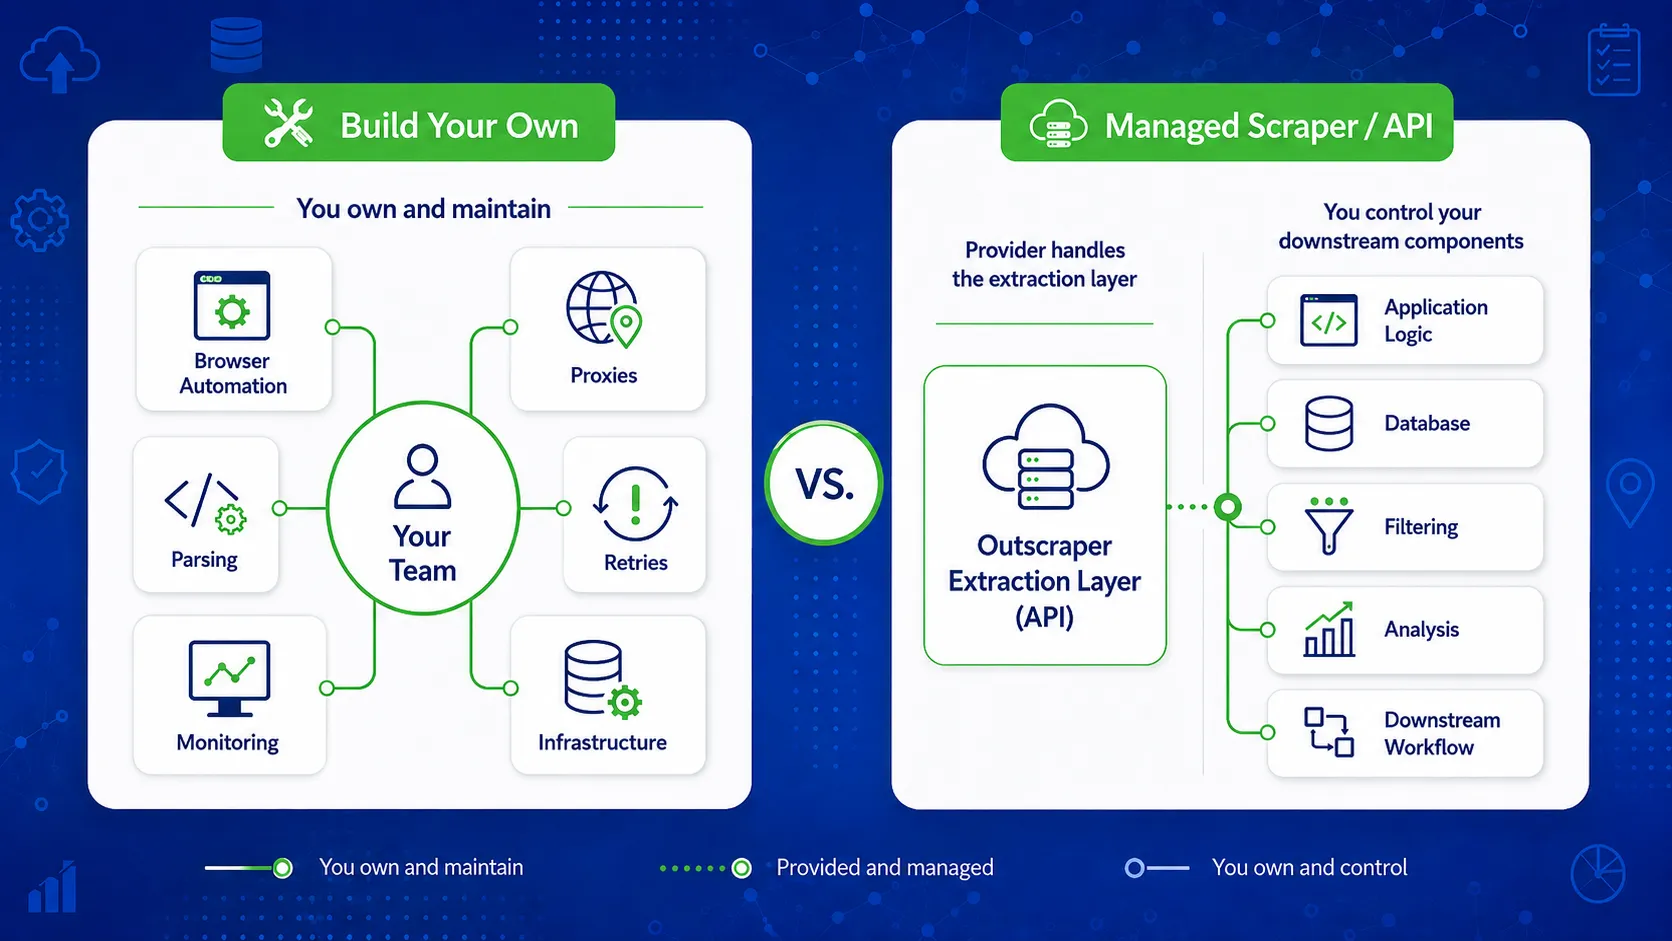
团队在使用托管式抓取 API 进行数据提取时,仍可对其应用程序、查询逻辑、存储、过滤、数据增强以及下游处理保持控制权。
关于此配置的技术细节,请参阅以下内容: Outscraper API 可在室内使用 自定义数据工作流.
一个配置示例如下:
您的应用程序或自动化
→ 托管式抓取 API
→ 谷歌地图商家信息
→ 您的数据库、CRM、报表工具或内部系统。
这种方法适合希望通过编程方式访问数据,同时又无需维护浏览器、代理、解析逻辑和数据提取基础设施的开发人员和数据团队。
数据收集完成后,该团队仍掌控着数据的使用方式。服务提供商负责数据收集环节。
在 Outscraper 负责处理 Google 地图数据提取的同时,您仍可掌控应用程序的逻辑、存储、过滤及下游处理。
选择前应考虑的问题
一旦明确了数据抓取工具的使用方式、由谁负责维护,以及当工作流无法按预期运行时该如何处理,技术选型就会变得更加容易。
你会多久运行一次?
用于一次性研究任务的爬虫与每天或每周运行的爬虫,其要求是不同的。
定期任务会增加维护工作量,因为故障、解析变更和基础设施问题更有可能中断该流程。
你需要多少数据?
进行几次内部测试的搜索,比收集遍布数百个地点或类别的业务数据更容易管理。
随着处理量增加,任务跟踪、重试、代理使用、存储和监控在工作负载中所占的比例越来越大。
您的提取要求有多特殊?
在决定构建之前,请列出所需的字段和提取规则。
如果您的需求依赖于非标准的页面行为,或者涉及托管服务商不支持的字段,那么开发自定义抓取工具可能更合乎情理。
如果所需的业务数据已可通过托管服务获取,那么自行开发数据提取逻辑可能会增加工作量,却不会带来多少好处。
如果东西坏了,由谁来维修呢?
当一份工作停止、一个行业消失或产出发生变化时,就必须有人为此负责。
在将自制刮板机视为完成的项目之前,请先确定负责该设备的人员或团队。与其他任何生产系统一样,维护工作也需要有人负责。
您需要一个API吗?
当其他应用程序、数据库或自动化系统需要请求数据,而无需人工逐个启动并下载每个任务时,API 就显得尤为重要。
这也是构建决策可能发生变化的环节。团队在使用托管 API 进行提取步骤的同时,仍可编写自己的应用程序。
工程时间的成本是多少?
代理费用和服务器是显而易见的开支。而工程开发时间则更容易被忽视。
估算监控、调试、测试、恢复以及未来变更所需的时间。然后将这些工作与同一批工程师负责的其他任务进行比较。
工作失败了会怎样?
既要做好取得部分成果的准备,也要做好彻底失败的准备。
询问该系统将如何识别缺失的记录、重试未完成的工作、防止数据重复,以及在任务需要处理时向团队发出提醒。
一个在一切顺利时才能正常工作的抓取工具,仅是生产工作流的一部分。
适用哪些法律、合同或数据使用要求?
数据抓取规则可能取决于数据来源、其使用条款、所收集数据的类型、管辖权以及数据的使用方式。
谷歌还发布了自己的 Google 地图平台服务条款 以及相关的政策指南,当工作流依赖于 Google Maps Platform 服务时,应予以审阅。
在决定如何收集或处理数据之前,请先审阅适用于您具体工作流程的要求。本节内容不构成法律建议。
Google 地图数据抓取决策检查清单
- 请说明您需要数据的频率。
- 请列出您所需的字段和提取规则。
- 对维护和工程工作进行估算。
- 确定由谁负责处理失败和修复问题。
- 请确认是否需要程序化 API 访问权限。
- 将完全控制刮板系统的价值与维持该系统所需的工作量进行比较。
- 请查阅适用于您的数据工作流的相关规则。
Outscraper 可以处理 Google 地图的数据提取层,而您的团队则可以专注于将这些数据用于潜在客户开发、研究、数据库或应用程序。
常见问题
最常见的问题和答案
一个基本的爬虫原型相对来说比较容易制作。真正困难的是确保它在多次任务执行、请求被阻塞、页面变化、重试以及更大工作负载的情况下仍能保持可靠性。
难度取决于其运行频率、收集的数据量以及工作流所需的维护工作量。
没有一种成本适用于所有项目。
总成本取决于工程开发时间、代理服务器、服务器、存储、监控、维护以及失败任务的恢复。一次简短的内部测试所花费的成本,远低于作为生产系统一部分而持续运行的爬虫。
这要看工作量而定。
如果项目规模较小且已有现成的工程资源,自建爬虫的初始成本可能较低。但若将定期维护、代理成本、任务失败以及开发人员的时间等因素纳入比较,托管爬虫可能更为实用。
是的。开发人员可以在使用托管式数据抓取 API 进行数据提取的同时,构建应用程序、数据库、过滤器、业务规则以及下游处理流程。 Outscraper 通过其数据提取和API服务支持此类配置。
这种方法既能让您掌控应用程序的逻辑,又无需您的团队维护数据抓取层。
“安全”可以指代几个不同的方面。
在选择服务提供商之前,请确认任务的执行方式、您的自有 IP 地址或 Google 账户是否会被泄露、API 凭据和收集到的数据如何处理、任务失败时会发生什么,以及您的使用场景需遵守哪些法律或合同要求。
应根据这些方面对第三方服务进行评估,而不是仅仅因为该服务受到管理就将其视为安全的。
是的,这取决于您所需的数据和工作流程。
Google Maps Platform API 和网络爬虫是获取位置相关信息的两种不同方式,它们在字段、限制、费用和使用规则方面各不相同。如果这是您需要做出的主要决定,那么专门的 Google Maps API 与网络爬虫的对比 那里是探讨这些差异的更好场所。



