Índice
A Coletor do Google Maps pode retornar milhares de registros hoje e falhar na mesma tarefa mais tarde porque parte do processo de extração foi alterada.
Solicitações bloqueadas, problemas com proxy, CAPTCHAs, lotes com falha e alterações na análise de dados geram trabalho de manutenção. Quando o scraper passa a fazer parte de um fluxo de trabalho recorrente, é necessário que alguém monitore as tarefas, corrija falhas, gerencie a infraestrutura e mantenha a lógica de extração em funcionamento.
É fácil ignorar esse trabalho contínuo durante a primeira versão. Uma equipe pode se sentir à vontade para assumir essa responsabilidade quando os requisitos de extração são incomuns ou quando a coleta de dados já faz parte das tarefas de manutenção dos seus engenheiros.
A decisão se torna mais difícil quando os dados do Google Maps são apenas uma das fontes para geração de leads, pesquisas, bancos de dados ou aplicativos internos. Nesses casos, o tempo gasto para manter a camada de extração em funcionamento passa a fazer parte do custo dos próprios dados.
Resposta rápida: Você deve criar seu próprio scraper do Google Maps?
- Construa isso para extração personalizada e controle total.
- Use um scraper gerenciado para reduzir o trabalho de manutenção.
- Use uma API gerenciada para manter seu próprio fluxo de trabalho sem precisar cuidar do scraper.
- Comparar o tempo dedicado ao controle, à manutenção, ao volume e à engenharia antes de tomar uma decisão.
O que envolve a manutenção de um scraper do Google Maps feito por conta própria
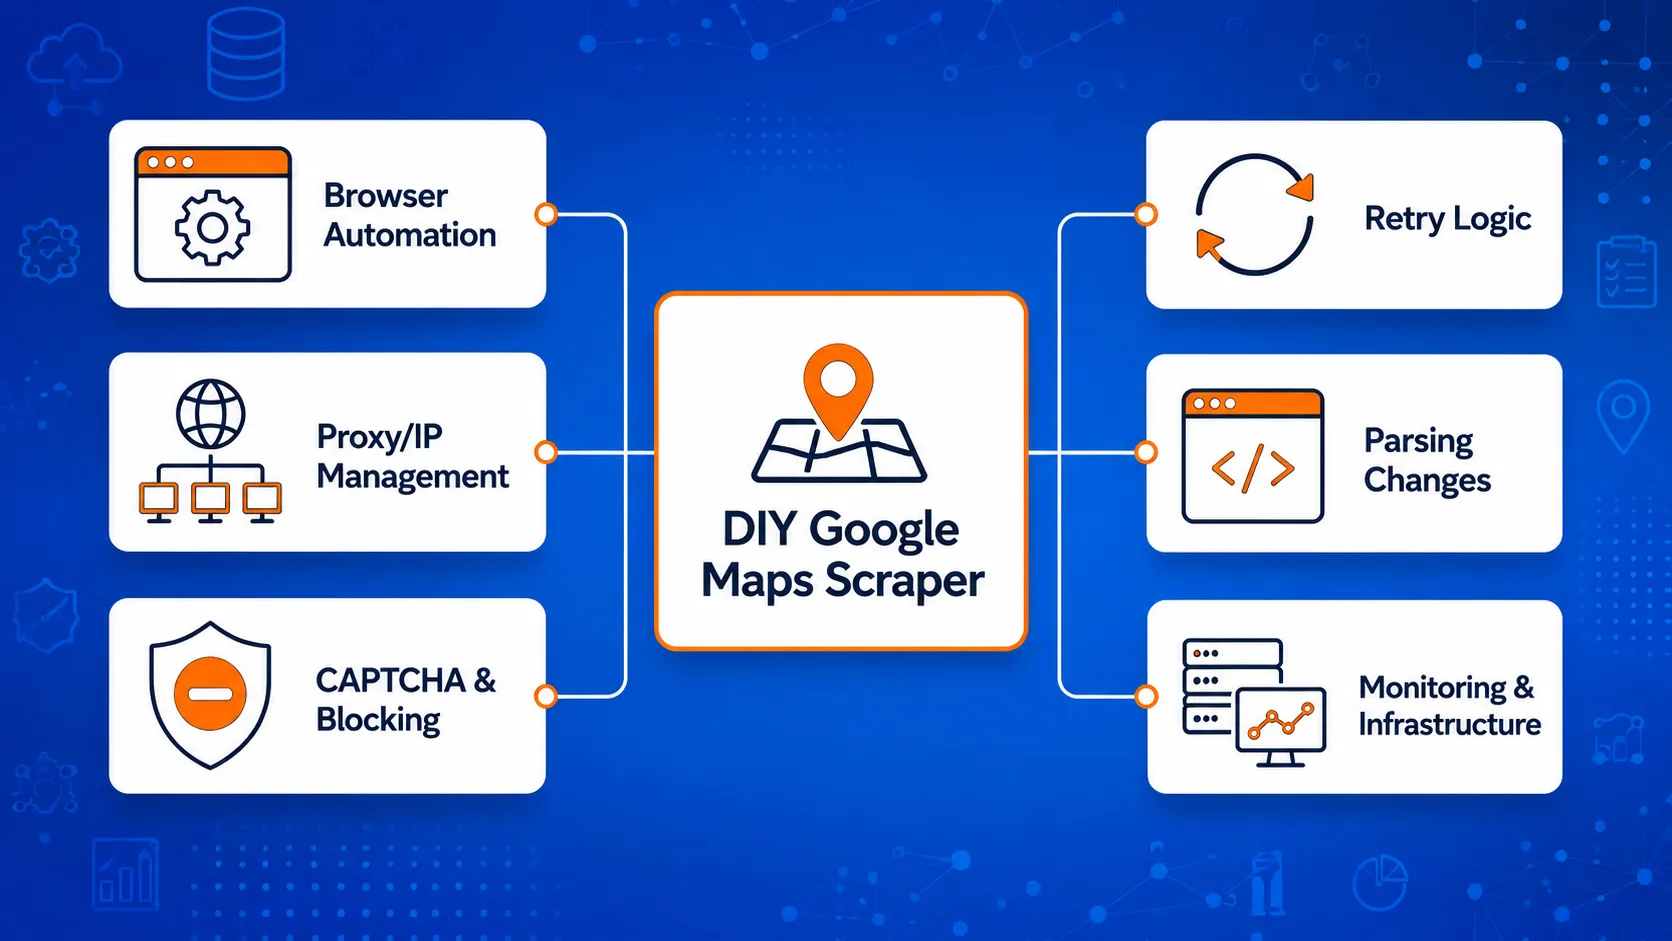
Escrever a primeira versão de um scraper é apenas parte do trabalho. Depois que ele começa a ser executado repetidamente, a manutenção passa a abranger tudo o que envolve o processo de extração.
Uma configuração feita por conta própria pode exigir automação do navegador, gerenciamento de proxy, lógica de repetição de tentativas, monitoramento e correções regulares quando o comportamento da página muda. Essas tarefas se tornam mais evidentes quando o scraper é utilizado para geração recorrente de leads, pesquisa de mercado ou fluxos de trabalho internos de dados.
Automação do navegador e lógica de extração
O Google Maps depende fortemente de conteúdo dinâmico nas páginas; por isso, muitos scrapers criados por usuários dependem da automação do navegador ou de métodos semelhantes para carregar e coletar dados.
A lógica de extração também precisa identificar os elementos corretos, lidar com a rolagem ou com o carregamento repetido e retornar os campos que seu fluxo de trabalho espera. Se a estrutura da página mudar, pode ser necessário atualizar partes dessa lógica.
Se você quiser conhecer a configuração técnica com mais detalhes, consulte nosso guia sobre Extracção de dados do Google Maps com Python abrange a extração por meio de navegadores e os trabalhos de apoio relacionados a ela.
Gerenciamento de proxy e IP
Solicitações repetidas podem gerar uma carga adicional de trabalho no que diz respeito à gestão de propriedade intelectual.
Uma equipe que opera seu próprio scraper pode precisar gerenciar conjuntos de proxies, remover proxies com falhas, acompanhar solicitações bloqueadas e decidir como as solicitações serão distribuídas. A qualidade dos proxies também pode afetar a confiabilidade na conclusão das tarefas.
Em pequena escala, isso pode ser administrável. Torna-se mais difícil ignorar quando o scraper analisa muitas buscas ou locais.
CAPTCHAs e bloqueio
Os CAPTCHAs e as solicitações bloqueadas podem interromper uma tarefa de extração antes que ela seja concluída.
Portanto, um fluxo de trabalho de produção precisa de uma maneira de detectar essas falhas e decidir o que acontecerá a seguir. Algumas solicitações podem precisar ser repetidas, adiadas ou encaminhadas por um endereço IP diferente.
Sem esse tratamento, um scraper pode parecer ter funcionado bem, mesmo que ainda retorne conjuntos de dados incompletos.
Novas tentativas e tarefas com falha
Uma solicitação com falha costuma ser mais fácil de lidar do que uma tarefa concluída parcialmente.
Por exemplo, um scraper pode concluir 80% de um grande lote antes que parte do processo seja interrompida. O sistema precisa, então, saber o que foi bem-sucedido, o que falhou e o que deve ser executado novamente, sem criar duplicatas desnecessárias.
Isso exige o acompanhamento das tarefas e regras de repetição, além do próprio código de extração.
Alterações na análise sintática
O scraper também depende da estrutura que espera encontrar.
Uma alteração nos rótulos, nos elementos da página ou na forma como os dados são carregados pode afetar os campos retornados pelo analisador. O scraper pode continuar funcionando, mas, sem que se perceba, gerando valores ausentes ou mapeados incorretamente.
Portanto, são necessárias verificações regulares para confirmar se a saída ainda corresponde ao que os sistemas a jusante esperam.
Infraestrutura e monitoramento
Quando um scraper passa a realizar tarefas recorrentes, é preciso que alguém acompanhe se ele ainda está funcionando.
Isso pode incluir servidores, logs, armazenamento, status das tarefas, alertas, lotes com falha e verificações de saída. O monitoramento se torna especialmente importante quando os dados alimentam outro sistema e uma falha na extração pode não ser percebida imediatamente.
Essa é a parte de um scraper do Google Maps feito por conta própria que é fácil subestimar. O código que coleta os dados é apenas uma parte. A equipe também é responsável pelos sistemas necessários para manter o processo de coleta em funcionamento.
A Outscraper cuida da camada de extração do Google Maps para que sua equipe possa trabalhar com os dados comerciais resultantes, em vez de ter que manter a infraestrutura de extração de dados.
Quanto custa desenvolver seu próprio scraper do Google Maps?
O custo de um scraper desenvolvido internamente vai além da criação da primeira versão do código. Quando o scraper passa a suportar tarefas recorrentes, a equipe também arca com os custos dos sistemas e do tempo de engenharia necessários para mantê-lo em funcionamento.
Compare o custo de construção do raspador com o custo de mantê-lo em funcionamento.
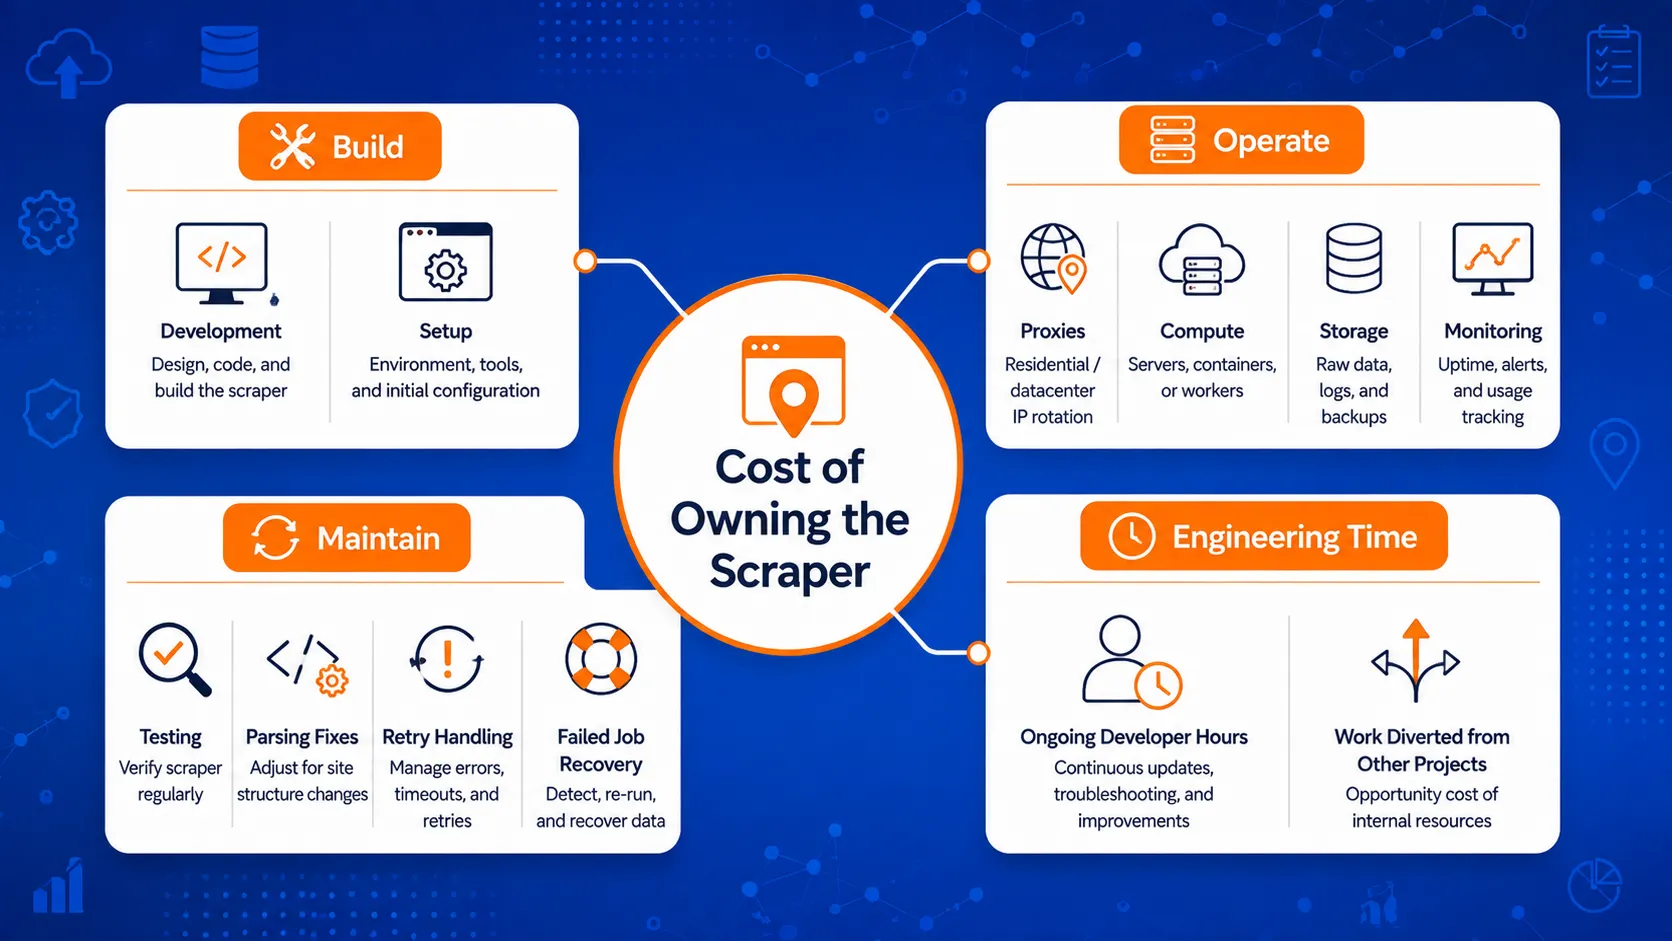
Tempo inicial de engenharia
A primeira compilação pode incluir mais do que apenas o próprio script de extração.
Os engenheiros também podem precisar configurar a automação do navegador, o tratamento de solicitações, o roteamento por proxy, o armazenamento de dados, as regras de repetição de tentativas, o registro em log e as verificações de saída. A quantidade de trabalho depende da quantidade de dados que o scraper precisa coletar e do nível de confiabilidade exigido pelo fluxo de trabalho.
Um pequeno teste interno tem requisitos muito diferentes dos de um scraper que alimenta um banco de dados de produção semanalmente.
Custos de proxy e de infraestrutura
A extração recorrente pode exigir infraestrutura paga, como proxies, servidores, armazenamento e monitoramento.
Esses custos podem aumentar com o número de pesquisas, locais e registros coletados. Eles também podem variar quando o scraper precisa de recursos adicionais para lidar com tarefas maiores ou solicitações com falha.
O ponto importante é que a infraestrutura geralmente continua fazendo parte dos custos operacionais após a conclusão do desenvolvimento.
Tempo de manutenção
É preciso ficar atento ao scraper quando o comportamento da extração muda ou quando os resultados deixam de corresponder às expectativas.
Esse trabalho pode incluir:
- correção de seletores ou regras de análise
- substituição de proxies com falhas
- verificação de tarefas incompletas
- atualização da automação do navegador
- análise de registros
- testar as alterações antes de executar o próximo lote
Mesmo pequenas correções acabam somando quando o scraper passa a fazer parte de um processo recorrente de tratamento de dados.
Custos de falha e recuperação
As tarefas com falha também consomem tempo.
Alguém precisa identificar o que deu errado, determinar quais registros já foram coletados, refazer o trabalho que ficou pendente e verificar se há lacunas ou duplicatas no resultado final.
Isso se torna ainda mais importante quando um lote com falha atrasa outro processo, como a preparação de uma lista de clientes potenciais, uma pesquisa de mercado ou um aplicativo interno que depende desses dados.
Custo de Oportunidade em Engenharia
O tempo dedicado à engenharia tem outro custo: o trabalho que fica por fazer enquanto os desenvolvedores mantêm o scraper.
Uma equipe pode preferir dedicar essas horas à criação de ferramentas de relatórios, ao aprimoramento de seu banco de dados, à adição de etapas de enriquecimento ou ao desenvolvimento de funcionalidades relacionadas aos dados coletados.
Isso faz com que a manutenção do raspador seja uma decisão tanto comercial quanto técnica.
| Área de custos | Durante a construção inicial | Durante o uso contínuo |
|---|---|---|
| Engenharia | Lógica e configuração da extração | Correções, testes e atualizações |
| Proxies | Configuração e testes | Uso recorrente |
| Infraestrutura | Servidores, armazenamento, registro de logs | Hospedagem e monitoramento |
| Recuperação do mercado de trabalho | Lógica de repetição de tentativa | Tarefas com falha e tarefas parciais |
| Verificações de dados | Configuração de saída | Campos ausentes ou incorretos |
| Tempo de Engenharia | Construindo o scraper | Manutenção do processo de extração |
Para comparar esses custos internos com a opção administrada, você também pode verificar como Preços do Google Maps Scraper como funciona e quais configurações podem afetar o custo da tarefa.
A opção de menor custo no início pode não continuar sendo a de menor custo quando se levam em conta a manutenção, os trabalhos com falhas e o tempo de engenharia.
Quando vale a pena fazer você mesmo
Criar seu próprio scraper ainda pode ser a melhor opção quando o próprio trabalho de extração é fundamental para o produto ou quando a equipe tem um motivo claro para controlar toda a configuração.
Você precisa de uma lógica de extração altamente personalizada
Um scraper gerenciado pode atender aos campos e ao fluxo de trabalho de que a maioria das equipes precisa, mas alguns projetos exigem regras de extração específicas para um determinado aplicativo.
Isso pode incluir uma lógica de análise incomum, comportamento personalizado da página, etapas especiais de validação ou um fluxo de trabalho baseado em dados que os provedores padrão não retornam.
Nesses casos, o fato de a equipe de engenharia ser responsável pelo scraper lhe dá mais liberdade para alterar o funcionamento da extração.
Você já conta com engenheiros especializados em scraping internos
A carga de manutenção assume um aspecto diferente quando uma empresa já conta com engenheiros responsáveis pelos sistemas de scraping.
Eles talvez já disponham de infraestrutura de proxy, monitoramento, lógica de repetição de tentativas, armazenamento e ferramentas internas para lidar com tarefas com falha. Adicionar um scraper do Google Maps a essa configuração pode ser mais viável do que introduzir outro serviço externo.
A questão principal é se a equipe tem capacidade disponível para dar conta disso sem desviar a atenção das tarefas de maior prioridade.
O fluxo de trabalho é restrito ou experimental
Um pequeno teste nem sempre requer uma infraestrutura de nível de produção.
Para um projeto de pesquisa curto, uma prova de conceito ou um experimento interno de escopo limitado, um scraper básico pode ser suficiente para responder à questão que a equipe está testando.
A decisão muda se esse script temporário começar a se tornar uma fonte de dados recorrente. Nesse momento, o trabalho de manutenção mencionado anteriormente passa a ter maior importância.
O controle total da infraestrutura é fundamental
Algumas equipes precisam de controle direto sobre como as solicitações são feitas, onde os dados são processados, como os registros são armazenados ou como o sistema se comporta quando uma tarefa falha.
Esses requisitos podem decorrer de normas internas de engenharia, políticas de segurança ou da arquitetura do produto.
Se esse nível de controle for necessário, desenvolver internamente pode ser mais fácil de justificar, mesmo que isso gere mais trabalho de manutenção.
A extração de dados faz parte do produto
Para algumas empresas, o scraping não é apenas uma forma de coletar dados de entrada. O próprio sistema de extração faz parte do que a empresa desenvolve e mantém.
Uma equipe que desenvolve seu próprio produto de dados, rastreador ou plataforma de extração pode ter motivos mais convincentes para possuir a tecnologia subjacente.
Nessa situação, o trabalho de engenharia apoia diretamente o produto, em vez de ficar à margem do trabalho principal da equipe.
A abordagem “faça você mesmo” faz mais sentido quando o controle adicional tem um objetivo claro. Se o scraper existe apenas para fornecer dados a outro fluxo de trabalho, fica mais difícil justificar o valor de se ter uma camada de extração própria.
Quando um scraper gerenciado do Google Maps faz mais sentido
Um scraper gerenciado se torna mais prático quando a equipe precisa dos dados regularmente, mas não deseja ser responsável pelos sistemas que mantêm o processo de extração em funcionamento.
Você executa tarefas recorrentes
Uma extração única de dados é mais fácil de gerenciar do que um fluxo de trabalho executado semanalmente ou diariamente.
Tarefas recorrentes aumentam as chances de ocorrência de solicitações bloqueadas, resultados parciais, lotes com falha e alterações na análise que possam interromper o processo. Um scraper gerenciado pode reduzir a quantidade de trabalho interno necessário para manter essas tarefas em execução.
Você precisa de conjuntos de dados repetidos ou maiores
A carga de manutenção aumenta quando o mesmo fluxo de trabalho precisa abranger mais pesquisas, locais ou registros.
Nesse ponto, o desafio já não se limita à lógica de extração. A equipe também precisa gerenciar novas tentativas, o acompanhamento de tarefas, a infraestrutura e as verificações de resultados em um volume maior de trabalho.
Um serviço gerenciado pode ser mais fácil de justificar quando a equipe precisa de acesso recorrente aos dados da empresa sem precisar ampliar a infraestrutura de extração de dados internamente.
Sua equipe precisa dos dados, não do scraper
Muitas equipes utilizam os dados comerciais do Google Maps como base para outra tarefa.
Isso pode incluir geração de leads, pesquisa de mercado, análise de negócios locais, bancos de dados internos ou recursos de aplicativos. Nesses fluxos de trabalho, a manutenção do scraper não melhora diretamente o uso final dos dados.
Outscraper's serviço gerenciado de extração de dados do Google Maps é adequado para esse tipo de configuração, pois cuida da parte da extração enquanto o usuário trabalha com os dados comerciais resultantes.
Você precisa de acesso a dados por meio de API
As exportações manuais podem ser suficientes para pesquisas ocasionais, mas os fluxos de trabalho recorrentes geralmente exigem que os dados sejam transferidos automaticamente para outro sistema.
Uma API permite que um aplicativo ou processo interno solicite dados por meio de programação e continue trabalhando com os resultados após a extração.
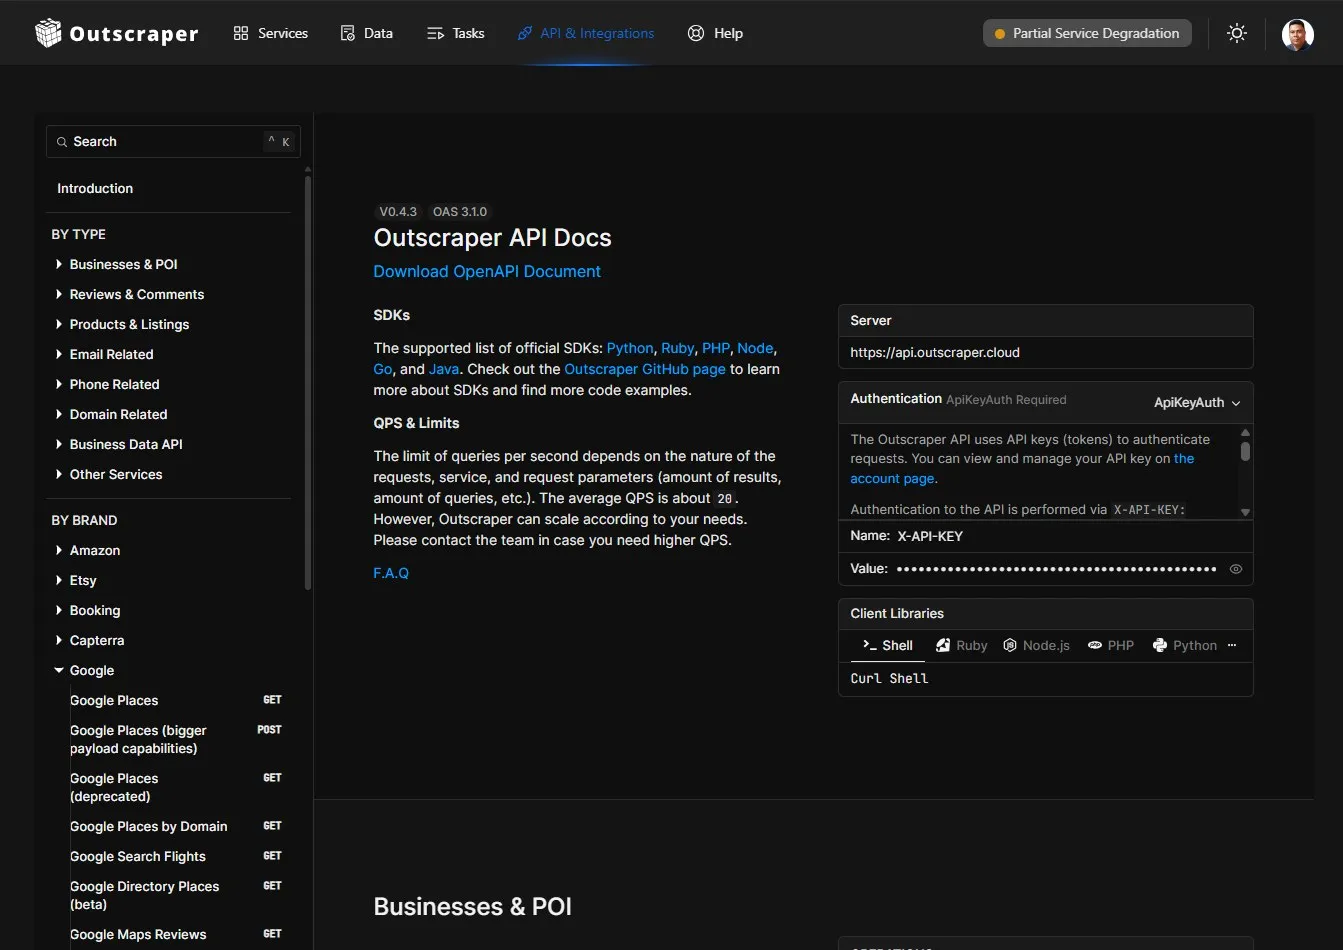
Os desenvolvedores podem consultar o Documentação da API Outscraper para conhecer os endpoints, parâmetros, respostas e exemplos de código atuais.
Isso permite que os desenvolvedores tenham controle sobre os componentes essenciais dentro de seus próprios sistemas, sem que precisem manter o scraper do Google Maps subjacente.
É melhor dedicar o tempo de engenharia às etapas posteriores do processo
O custo de manutenção de um scraper também inclui o trabalho que os desenvolvedores não estão realizando em outras áreas.
Uma equipe pode obter mais benefícios ao dedicar tempo de engenharia ao projeto de bancos de dados, ferramentas internas, geração de relatórios, enriquecimento, análise ou recursos de produto desenvolvidos com base nos dados coletados.
Um scraper gerenciado se justifica melhor quando a camada de extração é necessária, mas não é fundamental para o que a equipe está tentando desenvolver.
Utilize o Outscraper para a coleta recorrente de dados do Google Maps, mantendo ao mesmo tempo seus fluxos de trabalho de geração de leads, pesquisa, banco de dados ou aplicativos em pleno funcionamento.
É melhor desenvolver um scraper do Google Maps ou usar um serviço gerenciado?
A escolha fica mais fácil quando se compara quem é o responsável por cada etapa do fluxo de trabalho.
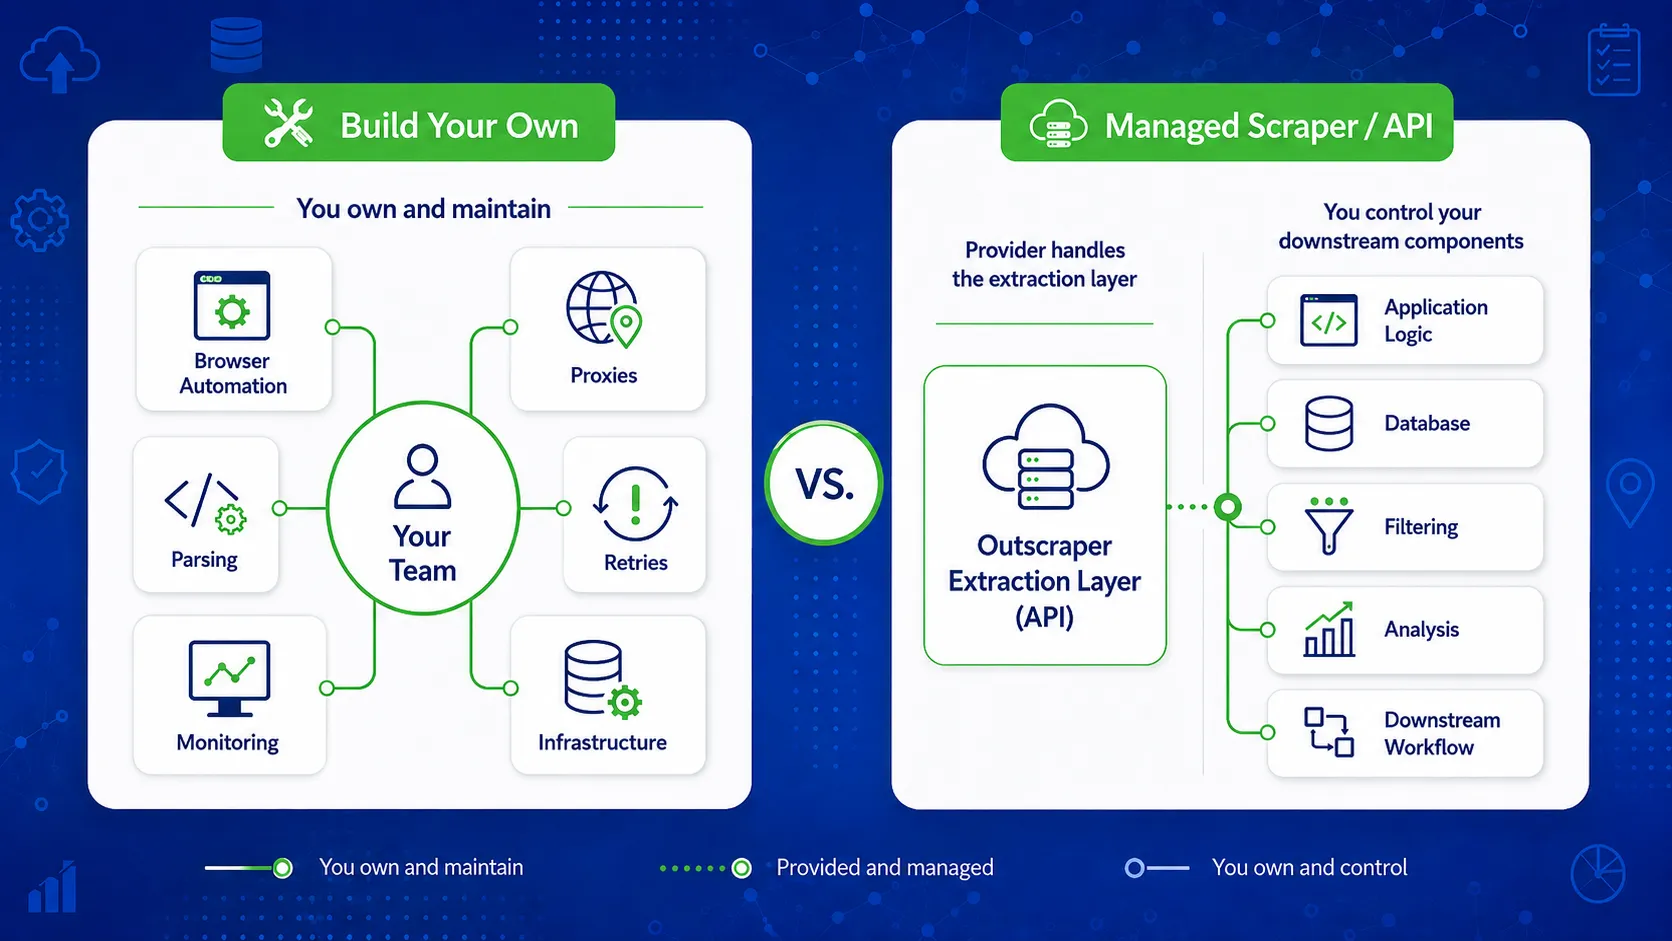
| Fator | Crie o seu próprio | Scraper gerenciado / API |
|---|---|---|
| Controle de extração | Controle total | Limitado às capacidades do provedor |
| Trabalhos iniciais de engenharia | Mais alto | Mais baixo |
| Manutenção do navegador | Sua equipe | Provedor |
| Gerenciamento de proxies | Sua equipe | Provedor |
| Alterações na análise sintática | Sua equipe | Provedor |
| Tratamento de novas tentativas | Sua equipe | Normalmente é de responsabilidade do prestador |
| Monitoramento | Sua equipe | O provedor é responsável pela camada de extração |
| Personalização do fluxo de trabalho | Mais alto | Valores elevados em torno da API e da saída |
| Escalonamento | Requer mais trabalho de engenharia | Geralmente é mais fácil de expandir |
| Melhor ajuste | Equipes com requisitos técnicos específicos | Equipes focadas no uso dos dados |
Nenhuma das opções é automaticamente melhor. A escolha certa depende do nível de controle de que sua equipe precisa e do volume de manutenção que ela deseja manter internamente.
Uma terceira opção: criar o fluxo de trabalho, não o scraper
A decisão não precisa se limitar a desenvolver tudo por conta própria ou delegar todo o fluxo de trabalho a um prestador de serviços.
Uma equipe pode manter o controle sobre seu aplicativo, a lógica de consulta, o armazenamento, a filtragem, o enriquecimento e o processamento posterior, ao mesmo tempo em que utiliza uma API de scraper gerenciada para a etapa de extração.
Para conhecer os aspectos técnicos dessa configuração, veja como APIs Outscraper pode ser usado em ambientes internos fluxos de trabalho de dados personalizados.
Uma configuração pode ser assim:
Seu aplicativo ou automação
→ API de scraper gerenciada
→ Dados comerciais do Google Maps
→ Seu banco de dados, CRM, ferramenta de relatórios ou sistema interno.
Essa abordagem pode ser adequada para desenvolvedores e equipes de dados que desejam acesso programático sem precisar manter navegadores, proxies, lógica de análise e infraestrutura de extração.
A equipe continua controlando como os dados são utilizados após a coleta. O provedor fica responsável pela parte relacionada à coleta.
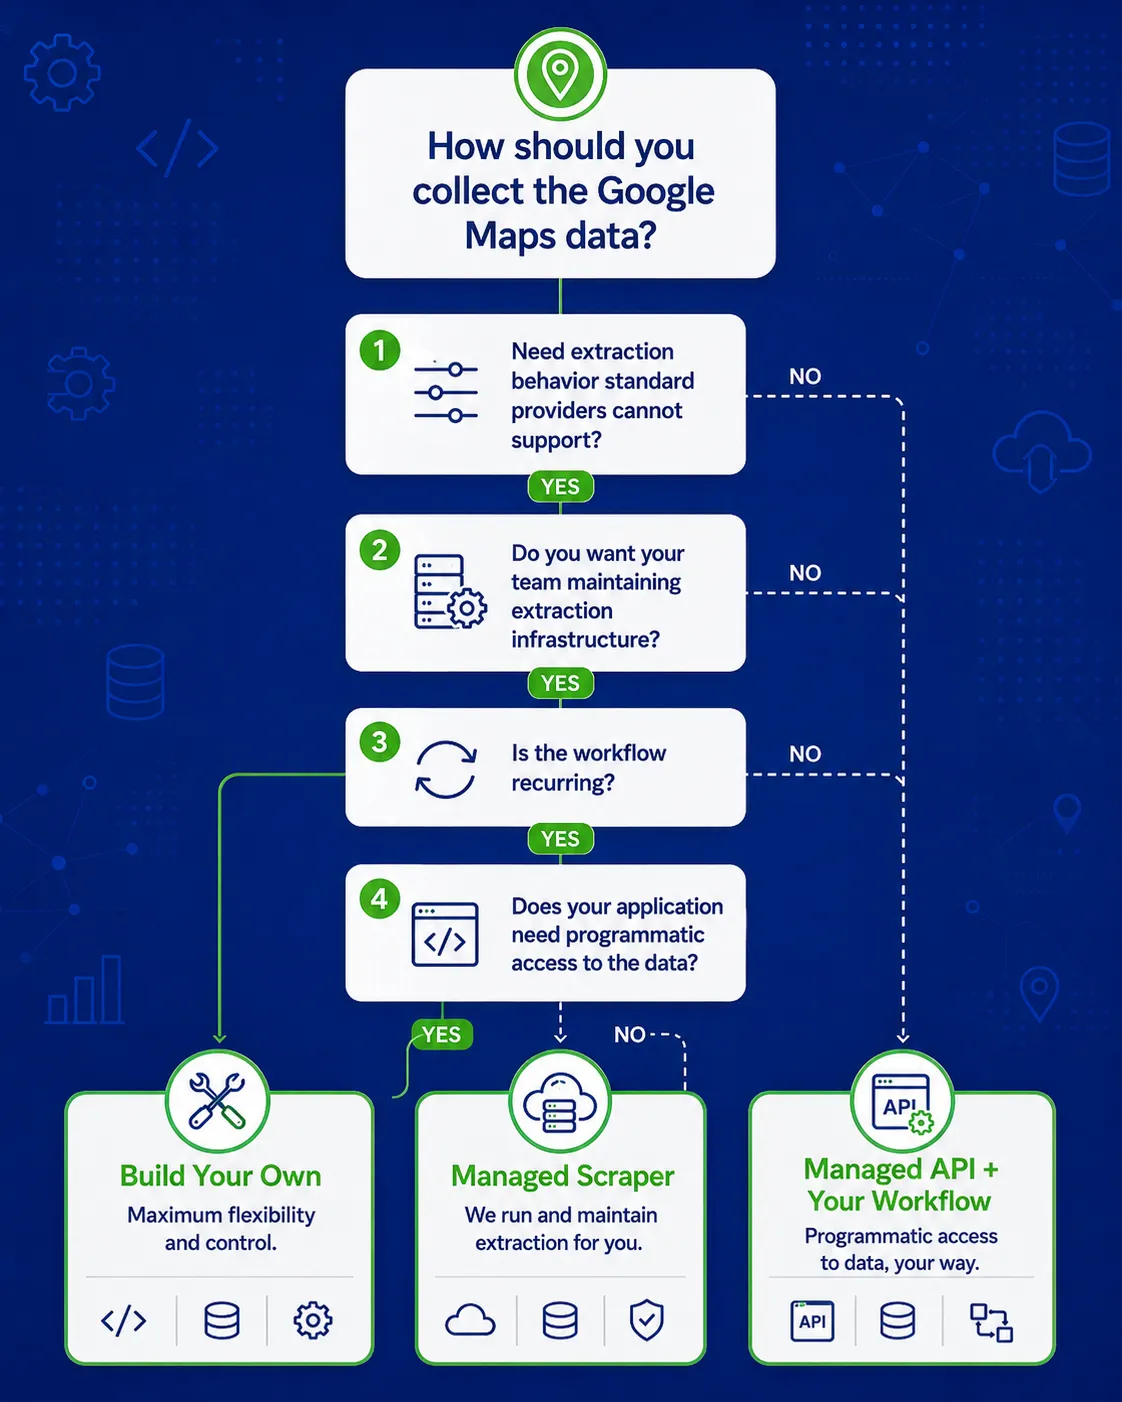
Mantenha o controle sobre a lógica da sua aplicação, o armazenamento, a filtragem e o processamento posterior, enquanto o Outscraper se encarrega da extração de dados do Google Maps.
Perguntas a fazer antes de escolher
A escolha técnica fica mais fácil quando se define como o scraper será utilizado, quem fará sua manutenção e o que acontecerá caso o fluxo de trabalho deixe de funcionar conforme o esperado.
Com que frequência você vai executá-lo?
Um scraper utilizado para um trabalho de pesquisa pontual tem requisitos diferentes daqueles que são executados diariamente ou semanalmente.
Tarefas recorrentes geram mais trabalho de manutenção, pois falhas, alterações na análise de dados e problemas de infraestrutura têm mais chances de interromper o processo.
De quanto tráfego de dados você precisa?
Algumas pesquisas para um teste interno são mais fáceis de gerenciar do que coletar dados comerciais em centenas de locais ou categorias.
À medida que o volume aumenta, o rastreamento de tarefas, as tentativas de repetição, o uso de proxies, o armazenamento e o monitoramento passam a representar uma parcela cada vez maior da carga de trabalho.
Quão específicas são suas necessidades de extração?
Liste os campos e as regras de extração necessários antes de decidir iniciar a construção.
Se suas necessidades dependerem de um comportamento incomum da página ou de campos que os provedores gerenciados não suportam, pode ser mais fácil justificar o uso de um scraper personalizado.
Se os dados comerciais necessários já estiverem disponíveis por meio de um serviço gerenciado, manter a lógica de extração pode representar um trabalho a mais sem trazer muitos benefícios.
Quem faz a manutenção quando algo quebra?
Alguém precisa assumir a responsabilidade quando um emprego é extinto, um setor desaparece ou a produção sofre alterações.
Identifique essa pessoa ou equipe antes de considerar um raspador feito por conta própria como um projeto concluído. O trabalho de manutenção precisa de um responsável, assim como qualquer outro sistema de produção.
Você precisa de uma API?
Uma API é importante quando outro aplicativo, banco de dados ou sistema de automação precisa solicitar dados sem que seja necessário iniciar e baixar manualmente cada tarefa.
É também nesse ponto que a decisão sobre a compilação pode mudar. Uma equipe ainda pode desenvolver seu próprio aplicativo, ao mesmo tempo em que utiliza uma API gerenciada para a etapa de extração.
Quanto custa o tempo de engenharia?
As taxas de proxy e os servidores são despesas visíveis. O tempo de engenharia é mais fácil de passar despercebido.
Estime o tempo necessário para monitoramento, depuração, testes, recuperação e alterações futuras. Em seguida, compare esse trabalho com outras tarefas pelas quais os mesmos engenheiros são responsáveis.
O que acontece quando os empregos não dão certo?
Esteja preparado tanto para resultados parciais quanto para fracassos totais.
Pergunte como o sistema identificará registros ausentes, tentará novamente tarefas não concluídas, evitará a duplicação de dados e alertará a equipe quando uma tarefa precisar de atenção.
Um scraper que funciona quando tudo corre bem é apenas uma parte do fluxo de trabalho de produção.
Quais são os requisitos legais, contratuais ou relativos ao uso de dados que se aplicam?
As regras de extração de dados podem depender da fonte, de seus termos, do tipo de dados coletados, da jurisdição e da forma como os dados serão utilizados.
O Google também publica seu próprio Termos de Serviço da Plataforma do Google Maps e as orientações de política relacionadas, que devem ser analisadas quando um fluxo de trabalho depende dos serviços da Google Maps Platform.
Analise os requisitos aplicáveis ao seu fluxo de trabalho específico antes de decidir como os dados serão coletados ou processados. Esta seção não constitui aconselhamento jurídico.
Lista de verificação para decisões relacionadas ao scraper do Google Maps
- Defina com que frequência você precisa dos dados.
- Liste os campos e as regras de extração necessárias.
- Faça uma estimativa dos trabalhos de manutenção e engenharia.
- Decida quem será responsável pelos erros e pelas correções.
- Verifique se é necessário o acesso programático à API.
- Compare o valor do controle total do raspador com o trabalho necessário para mantê-lo.
- Analise as regras que se aplicam ao seu fluxo de trabalho de dados.
A Outscraper pode cuidar da camada de extração do Google Maps enquanto sua equipe se concentra em utilizar os dados para geração de leads, pesquisas, bancos de dados ou aplicativos.
Perguntas frequentes
Perguntas e respostas mais frequentes
É relativamente simples criar um protótipo de um scraper básico. O mais difícil é garantir sua confiabilidade ao longo de tarefas repetidas, solicitações bloqueadas, alterações na página, novas tentativas e cargas de trabalho maiores.
A dificuldade depende da frequência com que ele é executado, da quantidade de dados que coleta e da manutenção necessária para o fluxo de trabalho.
Não existe um custo único que se aplique a todos os projetos.
O custo total depende do tempo de engenharia, dos proxies, dos servidores, do armazenamento, do monitoramento, da manutenção e da recuperação de tarefas com falha. Um teste interno rápido pode custar muito menos do que um scraper que seja executado continuamente como parte de um sistema de produção.
Depende da carga de trabalho.
Um scraper desenvolvido internamente pode ter um custo inicial menor quando o projeto é pequeno e já há recursos de engenharia disponíveis. Um scraper gerenciado pode se tornar mais prático quando a manutenção recorrente, os custos de proxy, as tarefas com falha e o tempo dos desenvolvedores são incluídos na comparação.
Sim. Um desenvolvedor pode criar o aplicativo, o banco de dados, os filtros, as regras de negócios e o processamento posterior, utilizando uma API de scraper gerenciada para a extração de dados. Outscraper oferece suporte a esse tipo de configuração por meio de seus serviços de extração de dados e API.
Essa abordagem mantém a lógica da aplicação sob seu controle, sem exigir que sua equipe faça a manutenção da camada de extração de dados.
“Seguro” pode se referir a várias questões diferentes.
Antes de escolher um provedor, verifique como as tarefas são executadas, se seu próprio endereço IP ou sua conta do Google ficam expostos, como as credenciais da API e os dados coletados são tratados, o que acontece quando as tarefas falham e quais requisitos legais ou contratuais se aplicam ao seu caso de uso.
Um serviço de terceiros deve ser avaliado com base nesses critérios, em vez de ser considerado seguro simplesmente por ser gerenciado.
Sim, dependendo dos dados e do fluxo de trabalho de que você precisa.
As APIs da Google Maps Platform e o web scraping são formas diferentes de acessar informações relacionadas a locais, com diferentes áreas de atuação, limites, custos e regras de uso. Se essa for a principal decisão que você está tomando, o guia dedicado Comparação entre a API do Google Maps e o web scraping é o melhor lugar para analisar essas diferenças.