Table des matières
Copier quelques lignes d'un site web dans un tableur est un jeu d'enfant. Mais lorsque cette tâche porte sur des centaines, voire des milliers de pages, un outil d'extraction de données peut collecter les champs nécessaires et les transformer en enregistrements structurés bien plus rapidement.
Ces données peuvent inclure des informations sur les produits, des fiches d'entreprise, des avis, des coordonnées, des tableaux ou des liens. La difficulté réside dans le fait que les sites web ne présentent ni ne chargent pas tous les informations de la même manière ; ainsi, une méthode d'extraction qui fonctionne sur un site peut ne pas donner les mêmes résultats sur un autre.
Pour les équipes qui collectent régulièrement des données provenant de sites web, l'extraction doit également permettre d'obtenir des enregistrements cohérents et exploitables, sans nécessiter de nettoyage ni de maintenance superflus.
Pour choisir la bonne approche, il faut d'abord comprendre de quelles données vous avez besoin, où elles se trouvent et comment le site web les met à disposition. Pour une vision plus globale de la place qu'occupe l'extraction dans les processus métier, consultez notre guide sur Outils de collecte de données et cas d'utilisation.
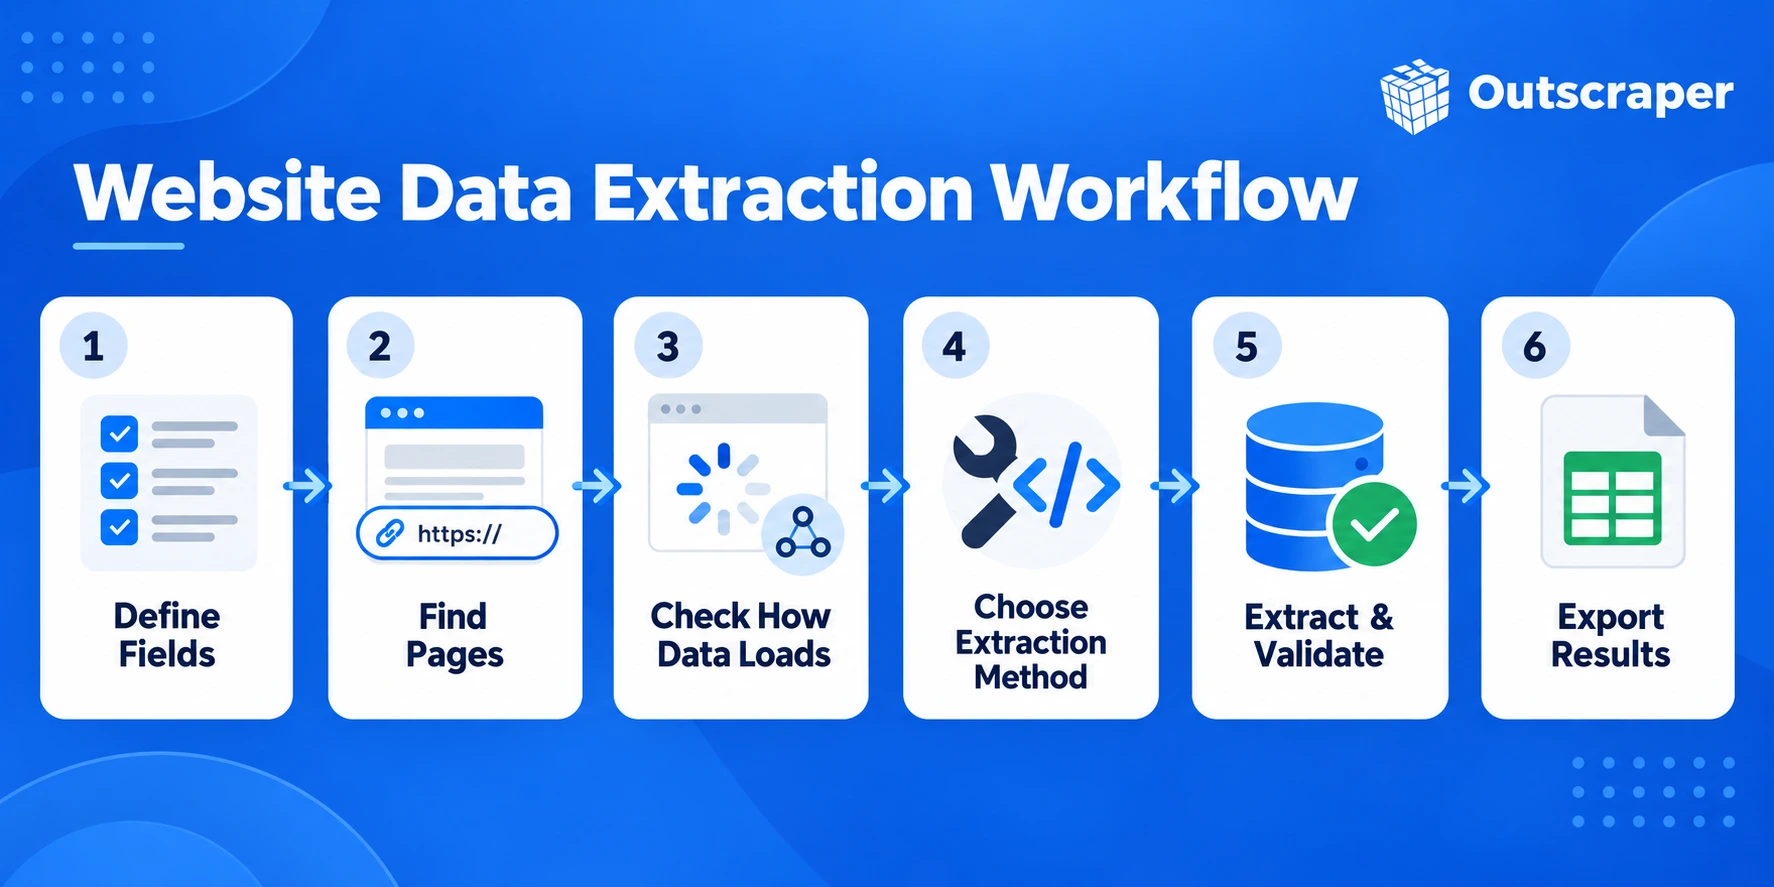
Réponse rapide : Comment extraire des données d'un site web ?
- Définissez les données dont vous avez besoin.
- Recherchez les pages qui le contiennent.
- Vérifiez comment le site web charge le contenu.
- Choisissez une méthode d'extraction.
- Testez un petit échantillon.
- Extraire et valider les données.
- Exportez les résultats dans un format exploitable.
La meilleure méthode dépend de la structure du site web, du volume de données, de la fréquence des mises à jour et du niveau d'intervention que vous souhaitez assumer.
Outscraper’s Gratte-papier universel alimenté par l'IA extrait les champs sélectionnés des URL de sites web sans que vous ayez à gérer la configuration du scraping.
Comment extraire des données d'un site web, étape par étape
L'extraction de données d'un site web est plus facile à gérer lorsque vous définissez d'abord le format de sortie, puis choisissez l'outil. Concentrez-vous sur les champs dont vous avez besoin, leur emplacement sur la page et la capacité de la méthode d'extraction à les récupérer de manière cohérente.
Watch: Scrape Any Website into Clean Data
1. Définissez les champs de données dont vous avez besoin
Commencez par définir clairement le jeu de données final que vous souhaitez obtenir.
Pour un site dédié à un produit, cela pourrait inclure :
- nom du produit
- prix
- rating
- disponibilité
- URL du produit
Pour un annuaire d'entreprises, vous aurez peut-être besoin de :
- raison sociale
- category
- numéro de téléphone
- site web
- adresse
En limitant la liste des champs, on évite toute extraction superflue et on facilite la vérification de l'exhaustivité du résultat final.
2. Identifiez les pages ou les URL
Ensuite, repérez les pages qui contiennent ces informations.
Les données peuvent apparaître sur :
- pages de listes
- pages produits
- pages de profil
- pages de catégories
- résultats de recherche
- tableaux
- sections paginées
Certaines tâches ne nécessitent que des données provenant d'un seul type de page. D'autres requièrent d'abord des informations issues d'une page de liste, puis des pages de détails individuelles.
3. Vérifiez comment le site web charge les données
Vérifiez si les informations s'affichent dès le chargement de la page ou seulement après une action.
Certaines pages affichent directement le contenu dans le code HTML. D'autres peuvent charger des enregistrements via JavaScript et requêtes réseau asynchrones, ainsi que la pagination, les filtres ou le défilement infini.
Cela signifie que certaines informations peuvent s'afficher après le chargement de la page initiale ; un robot d'indexation qui ne lit que le code HTML d'origine risque donc de ne pas les détecter.
4. Choisir et tester une méthode d'extraction
Choisissez une méthode en fonction de la structure du site web et du volume de données dont vous avez besoin.
Les options peuvent inclure :
- extraction visuelle ou sans code
- Extraction de données à l'aide de sélecteurs HTML ou CSS
- scripts personnalisés
- API
- Extraction assistée par l'IA
Avant de lancer le processus sur des centaines ou des milliers de pages, testez-le d'abord sur un petit échantillon. Vérifiez si les champs attendus s'affichent correctement et si la même méthode fonctionne sur différentes pages.
5. Extraire et valider les données
Une fois que le test fonctionne, lancez l'extraction sur les pages souhaitées.
Ne partez pas du principe que les résultats sont corrects simplement parce que le processus s'est achevé. Vérifiez les points suivants :
- valeurs manquantes
- enregistrements en double
- champs incorrects
- formats non uniformes
- pages n'ayant renvoyé aucune donnée
La validation revêt une importance particulière lorsque les pages ne présentent pas toutes la même mise en page.
6. Exporter et préparer les résultats
Enregistrez les données dans un format adapté à l'étape suivante.
Les formats courants sont notamment le CSV, Excel et JSON. Selon le flux de travail, les données de sortie peuvent encore nécessiter un nettoyage, une déduplication ou une mise en forme avant d'être prêtes pour l'analyse ou pour être transmises à un autre système.
Quelles données un outil d'extraction de données peut-il extraire d'un site web ?
Le type de données que vous pouvez collecter dépend des informations que le site web met à disposition sur ses pages. Dans la plupart des cas, un scraper est configuré pour extraire des champs spécifiques plutôt que de copier la page dans son intégralité.
Listes et répertoires
Les répertoires contiennent souvent des enregistrements en double comportant les mêmes champs.
Des plateformes telles que Google Maps et l' Pages Jaunes Ce sont là des exemples courants de sources de type « annuaire » dans lesquelles les noms d'entreprises, les catégories, les adresses, les numéros de téléphone, les sites web et les informations de localisation peuvent être collectés sous forme d'enregistrements structurés.
Parmi les exemples typiques, on peut citer :
- dénominations sociales
- catégories
- adresses
- numéros de téléphone
- liens vers des sites web
- détails sur le lieu
Ces pages sont généralement plus faciles à structurer, car les mêmes champs apparaissent dans de nombreuses annonces.
Informations sur les produits et les annonces
Les pages produits et les places de marché peuvent comporter des champs tels que :
- nom du produit
- prix
- description
- rating
- disponibilité
- Informations sur le vendeur
- URL du produit
Certaines de ces informations peuvent figurer sur les pages de présentation, tandis que d'autres détails ne sont disponibles que sur la page dédiée à chaque produit.
Pour un exemple spécifique à une source, celui de Outscraper : Le Scraping de produits Amazon peut collecter des données structurées sur les produits et les fiches produits à partir des pages Amazon.
Tableaux et enregistrements structurés
Les sites web publient souvent des informations sous forme de tableaux, de grilles comparatives, de calendriers ou d'autres mises en page récurrentes.
Un « scraper » permet de récupérer les valeurs de chaque ligne ou colonne et de les convertir en enregistrements plus faciles à trier, à filtrer ou à analyser.
Avis et notes
Les pages d'avis peuvent inclure :
- texte de la critique
- rating
- date de révision
- nom du critique
- texte de réponse
- autres détails visibles de l'avis
Outscraper's Le Scraping d'avis Google Maps peut fournir des données structurées issues d'avis clients pour le suivi de la réputation, l'analyse des commentaires des clients et l'étude de la concurrence.
Les champs disponibles varient d'un site web à l'autre ; la configuration de l'extraction doit donc correspondre à la structure de la page d'avis.

Utilisez les « Outscraper » Le Scraping d'avis Google Maps pour recueillir des avis clients sur les entreprises que vous étudiez.
Coordonnées pour le public et informations sur l'entreprise
Les sites web d'entreprise, les annuaires et les pages de profil peuvent afficher :
- dénominations sociales
- adresses
- numéros de téléphone
- adresses e-mail
- URL de sites web
- liens vers les réseaux sociaux
- autres informations sur la société cotée en bourse
Toutes les pages ne contiennent pas nécessairement tous les champs ; il faut donc s'attendre à des valeurs manquantes lorsque l'on travaille avec des ensembles de données volumineux.
Lorsque les coordonnées constituent les principaux champs dont vous avez besoin, la solution de Outscraper Le Scraping de courriels et de contacts peut collecter des adresses e-mail, des numéros de téléphone et des profils sur les réseaux sociaux accessibles au public à partir de sites web.

Outscraper propose des outils de collecte de données pour les fiches d'entreprises, les avis, les produits, les annuaires et les coordonnées publiques.
Pourquoi certains sites web sont plus difficiles à « scraper » que d'autres
Deux sites web peuvent présenter des informations similaires, mais nécessiter des méthodes d'extraction très différentes. La difficulté réside généralement dans la manière dont la page charge le contenu, dans la répartition des enregistrements sur le site et dans le degré de cohérence de la structure de la page.
Contenu généré par JavaScript
Certains sites web n'intègrent pas toutes les informations visibles dans le code HTML initial. À la place, JavaScript charge une partie de la page après la première requête.
Un simple outil de scraping peut extraire la page, mais risquerait néanmoins de ne pas récupérer les champs visibles par l'utilisateur dans le navigateur. Dans ces cas-là, la méthode d'extraction doit prendre en compte le contenu qui s'affiche après le chargement de la page.
Pagination et défilement infini
Une liste peut contenir des centaines d'enregistrements, mais seul un petit nombre d'entre eux apparaît sur la première page.
La pagination répartit ces enregistrements sur plusieurs URL ou états de page. Le défilement infini charge davantage de résultats à mesure que le visiteur descend dans la page.
Dans les deux cas, le scraper doit continuer à demander ou à charger des enregistrements supplémentaires au lieu de s'arrêter après le premier ensemble visible.
Différentes mises en page
Toutes les pages d'un même site web ne suivent pas nécessairement la même structure.
Par exemple, certaines pages de produits peuvent comporter des champs indiquant le prix, la note et la disponibilité, tandis que d'autres utilisent une mise en page différente ou omettent carrément certains champs.
Les règles d'extraction qui fonctionnent sur une page peuvent donc devoir prendre en charge plusieurs variantes.
Champs manquants ou incohérents
Les archives d'un site web sont rarement complètes pour toutes les pages.
Une fiche d'entreprise peut indiquer un numéro de téléphone, mais pas d'adresse e-mail. Un produit peut avoir une note, tandis qu'un autre n'a pas encore reçu d'avis.
Le scraper doit conserver l'enregistrement même lorsque certains champs attendus sont manquants.
Modification de la structure des sites web
Les sites Web sont mis à jour au fil du temps. Une page remaniée, un élément renommé ou un comportement de chargement modifié peuvent perturber une configuration d'extraction qui fonctionnait auparavant.
C'est l'une des raisons pour lesquelles l'extraction récurrente de sites web nécessite généralement davantage de maintenance qu'une tâche ponctuelle. Plus le nombre de pages et de types de pages concernés est élevé, plus il est important de vérifier que les résultats restent cohérents.
Méthodes d'extraction de données structurées à partir d'un site web
Il n'existe pas de méthode d'extraction unique adaptée à tous les sites web. La bonne approche dépend de la structure de la page, de la quantité de données dont vous avez besoin et du fait que le processus soit exécuté une seule fois ou de manière répétée.
Extraction visuelle et sans code
Les outils de capture visuelle permettent aux utilisateurs de sélectionner les champs souhaités directement à partir d'une page Web, sans avoir à écrire de code.
Cette méthode convient particulièrement aux pages simples présentant des mises en page répétitives, telles que les répertoires, les listes de produits ou les tableaux. Elle s'avère également utile lorsque la tâche d'extraction est de petite envergure ou lorsqu'un utilisateur non initié à la technique doit configurer le flux de travail.
Extraction de sélecteurs HTML et CSS
De nombreux outils de scraping identifient les éléments d'une page grâce à la structure HTML, Sélecteurs CSS, ou des règles similaires.
Cette approche permet de mieux contrôler les champs à collecter et fonctionne bien lorsque les pages cibles présentent une mise en page homogène.
Sa principale faiblesse réside dans la maintenance. Si le site web modifie la structure de ses pages, il peut s'avérer nécessaire de mettre à jour les sélecteurs.
Code personnalisé
Les développeurs peuvent créer leur propre logique d'extraction à l'aide de langages tels que Python ou JavaScript.
Le code personnalisé s'avère utile lorsque le site web présente un comportement inhabituel, que les données nécessitent un traitement particulier ou que l'extraction doit s'intégrer étroitement à un autre système.
En contrepartie, l'équipe assume également la responsabilité des tests, de la maintenance, de la gestion des erreurs et des modifications apportées au site web.
API
Certains workflows peuvent collecter des données provenant de sites web via une API, plutôt que de gérer directement la logique d'extraction.
Une API peut s'avérer utile lorsque les données doivent alimenter une application, une base de données ou un flux de travail récurrent. Les développeurs utilisant Outscraper peuvent se reporter à la Documentation de l'API Universal Scraper pour connaître les paramètres disponibles, les réponses et les exemples de requêtes.
En ce qui concerne les données commerciales géolocalisées, la solution de Outscraper API Places de Google Maps peut être utilisé pour demander des informations structurées sur des lieux et des entreprises à des fins d'applications, de bases de données ou de flux de travail récurrents.
Les champs disponibles, les limites et le comportement dépendent de l'API utilisée.
Extraction assistée par l'IA
AI-assisted extraction can identify fields based on the information a user asks for rather than relying only on fixed selectors.
This can help when pages have less consistent layouts or when defining every extraction rule manually would take too much time.
Les Universal AI Scraper guide shows how Outscraper applies this approach to extracting selected fields from website URLs.
It still needs testing. AI-based extraction should be checked for missing fields, incorrect values, and inconsistent outputs before it is used at scale.
Examples of AI-Assisted Website Data Extraction
AI-assisted extraction can be used for different types of pages, depending on the information available on the website.
Business directory example
For a business directory, you might request fields such as business name, website, phone number, category, and address.
Product page example
For product pages, the requested fields could include product name, price, availability, rating, and product URL.
Article or listing example
For content or listing pages, you might extract fields such as title, author, publication date, category, and page URL.
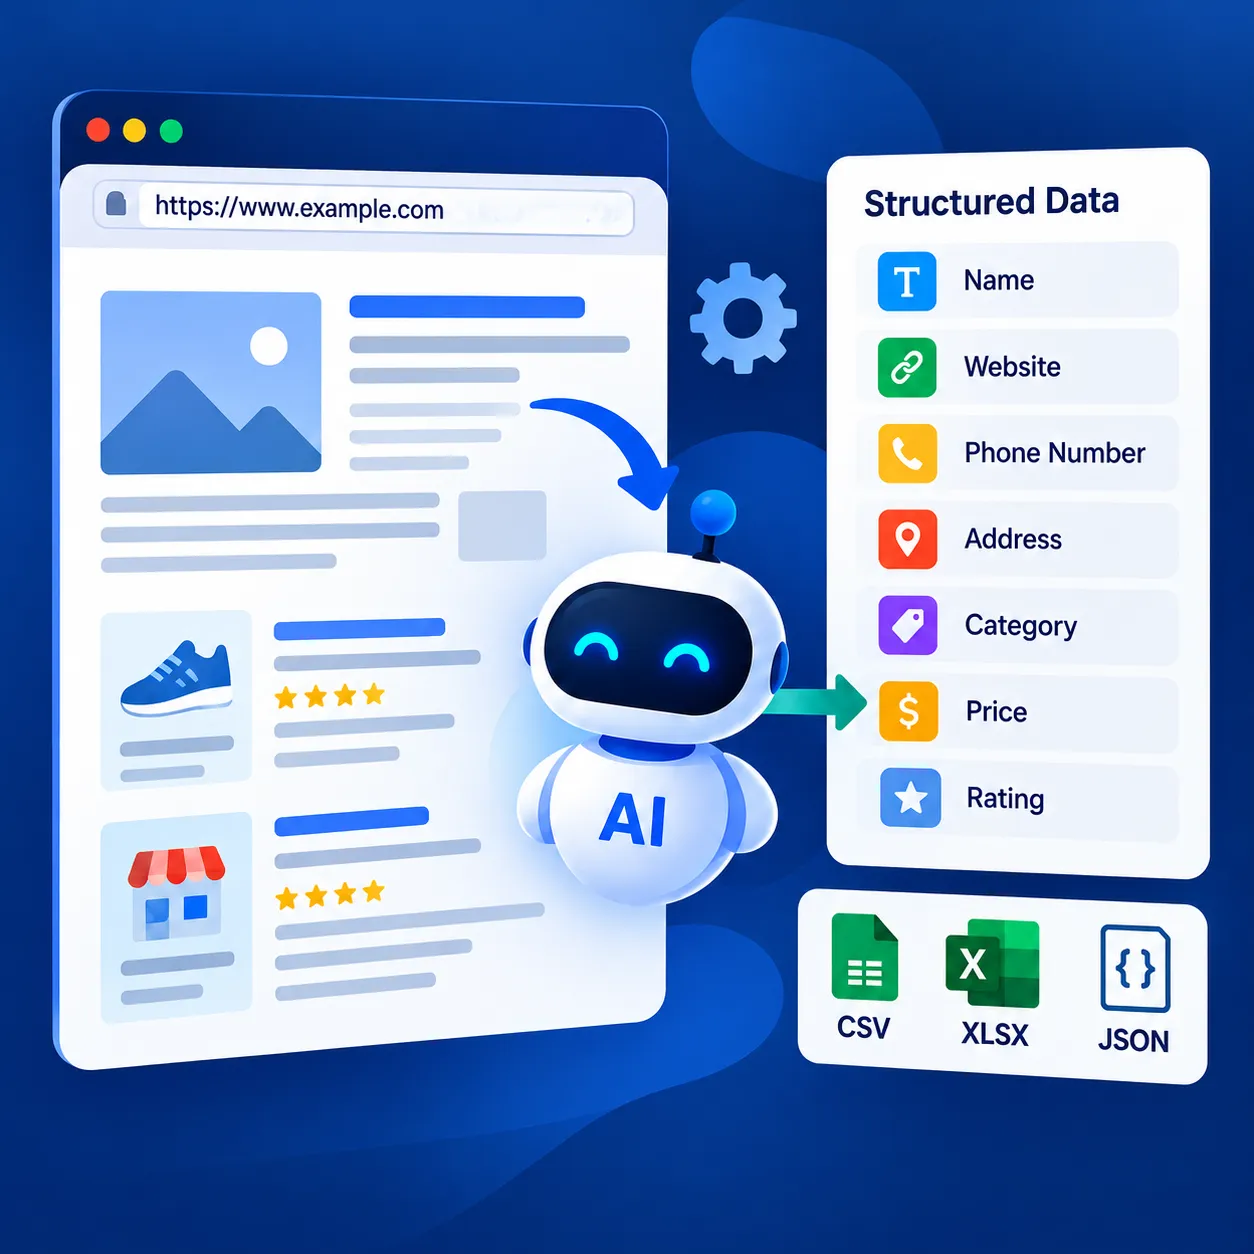
Utilisez les « Outscraper » Gratte-papier universel alimenté par l'IA to collect the fields you need from website pages and return them as structured data.
How to Choose the Right Website Data Extraction Method
The best extraction method depends on the website, the amount of data involved, and how often the process needs to run. A simple page may only need a visual scraper, while a large or recurring job may require code, an API, or a managed extraction service.

Match the Method to the Website
Start with the way the website presents its data.
A page with a stable layout and repeated fields may work well with selectors or a no-code scraper. A site that relies heavily on JavaScript, dynamic loading, or changing layouts may need a more flexible approach.
The more complex the page behavior, the more important it is to test the method before scaling the extraction.
Consider Scale, Frequency, and Maintenance
A method that works for 20 pages may not be the best choice for 20,000.
For a one-time extraction, manual setup may be acceptable. For recurring collection, maintenance becomes a bigger part of the decision.
Consider:
- how many pages need to be processed
- how often the data needs to be refreshed
- whether the page structure changes often
- how much monitoring the workflow requires
- whether your team can maintain custom scraping logic
The larger and more frequent the job, the more valuable it becomes to reduce manual checks and repeated setup.
Check Output and Data-Use Requirements
The extraction method should also fit what happens after the data is collected.
If the results need to move into a spreadsheet, database, application, or automated workflow, check whether the method supports the required output and structure.
It is also important to review the website’s access rules, the type of information being collected, and the requirements that apply to how the data will be used.
When extracting website data, also check whether the information is publicly accessible, whether the site has terms or access restrictions that apply, and whether privacy or data-protection rules affect how the collected information can be stored or used. Requirements can vary by website, data type, intended use, and jurisdiction.
A good extraction method should fit both the website and the workflow that comes after it.
Where Outscraper Fits Into a Website Data Extraction Workflow
Building your own scraper gives you control, but it also means handling testing, maintenance, page changes, and failed extraction jobs yourself.
Teams comparing the best data scraper for a project should look at the data source, required fields, scale, refresh frequency, and how much scraping infrastructure they want to maintain.
Outscraper provides scraping tools and APIs for collecting structured public data from websites and online directories, including source-specific options for platforms such as Google Maps, Google Maps Reviews, Amazon, Trustpilot, and Yellow Pages.
For broader website extraction, Outscraper’s Gratte-papier universel alimenté par l'IA can be used when you need structured data without maintaining the full scraping setup internally.
If your website extraction project involves defined fields and multiple pages, Outscraper’s Universal AI-Powered Web Scraper can be one option to consider.
How a Data Scraper Extracts Data From a Website
A outil d'extraction de données works by reading a webpage, locating the information it has been told to collect, and turning those values into structured records.
Loading the Page
The scraper first needs access to the webpage content.
For simpler sites, the required information may already be present in the HTML returned by the server. Other sites load part of the content later through JavaScript or additional requests.
How the page loads affects what the scraper can see and when the data becomes available.
Finding the Right Page Elements
Once the page is available, the scraper needs to identify the elements that contain the required fields.
That might include:
- a product title
- a price
- a business name
- a review rating
- a phone number
- a link
- a table row
Depending on the method, those fields can be identified through selectors, page structure, extraction rules, or AI-assisted instructions.
Extracting the Values
The scraper then collects the values from those elements.
For example, a product page might return:
- product name: Example Product
- price: $49
- rating: 4.6
- availability: In stock
The same extraction rules can then be applied across similar pages if the structure remains consistent.
Turning the Results Into Structured Records
Raw webpage content is not very useful on its own. The extracted values need to be organized into consistent fields so each record follows the same structure.
For a product page, the output might look like this:
| Product Name | Prix | Note | Disponibilité | Product URL |
|---|---|---|---|---|
| Example Product A | $49 | 4.6 | In stock | example.com/product-a |
| Example Product B | $72 | 4.3 | Out of stock | example.com/product-b |
| Example Product C | $35 | 4.8 | In stock | example.com/product-c |
Once the fields are structured, the records can be exported, analyzed, stored in a database, or passed into another workflow.
The reliability of the final dataset depends on how consistently the scraper can find the same fields across all target pages.
Final Checklist Before You Extract Data From a Website
- Define the fields you need.
- Find the right pages or URLs.
- Check how the site loads the data.
- Choose the extraction method.
- Testez un petit échantillon.
- Validate the records.
- Confirm the output format and data-use requirements.
Need a outil d'extraction de données for your website extraction project? Outscraper helps you collect structured public data from websites, directories, listings, and reviews without managing the full scraping setup yourself.
FAQ
Questions et réponses les plus fréquentes
Un outil d'extraction de données Web recueille des informations spécifiques sur des pages Web et les convertit en enregistrements structurés. Selon la page, ces informations peuvent inclure du texte, des prix, des liens, des avis, des coordonnées, des tableaux, des listes ou d'autres champs visibles.
Oui. Les outils de scraping visuels et sans code permettent aux utilisateurs de sélectionner des champs sur une page web sans avoir à écrire de script. Ces méthodes sont particulièrement efficaces lorsque les pages cibles présentent une structure claire et récurrente.
Oui. Un robot d'indexation peut parcourir plusieurs URL, des pages de liste, des pages paginées ou des pages de détails liées. La configuration doit tenir compte de la manière dont le site web organise et charge ces pages.
Le « web scraping » permet de collecter des informations à partir de pages web, tandis qu'une API fournit des données structurées via une interface définie. Les API sont souvent plus faciles à intégrer dans des applications, mais les champs disponibles dépendent de ce que le fournisseur met à disposition.
Oui, à condition que l'outil d'extraction prenne en charge ces formats. Les fichiers CSV et Excel sont des choix courants lorsque les données doivent être examinées, filtrées, nettoyées ou partagées dans un tableur.
Des données peuvent manquer lorsque le contenu est chargé via JavaScript, que certains champs sont absents de certaines pages, que la mise en page varie ou que le site web modifie sa structure. Tester plusieurs pages avant de lancer une extraction à plus grande échelle peut permettre d'identifier ces problèmes à un stade précoce.