Table des matières
Nous avons extrait plus de 3 000 fiches d'entreprise à l'aide d'un scraper basique dans le cadre d'un projet d'extraction de données sur mesure. Cela a fonctionné pendant les premiers jours, mais la structure a ensuite changé. Les requêtes ont échoué, les champs clés ont disparu et l'ensemble de données est devenu peu fiable.
C'est là le problème majeur du scraping manuel : ce n'est pas un échec ponctuel, mais une succession d'échecs.
C'est pourquoi de plus en plus d'équipes se tournent vers l'extraction de données personnalisée via des API, plutôt que de gérer des scripts peu fiables. Le marché de la gestion des API devrait atteindre $15,88 milliards d'ici 2027, ce qui reflète cette évolution vers un accès stable et programmatique aux données, à mesure que les entreprises délaissent la collecte manuelle de données.
Au lieu de gérer des scripts peu fiables, vous pouvez vous connecter directement à des outils tels que API d'Outscraper et récupérez des données métier structurées dès que vous en avez besoin. Vous n'avez pas à vous soucier des serveurs proxy, des CAPTCHA ou des corrections incessantes.
Comment lancer une extraction de données personnalisée avec l'API Outscraper
Pour lancer une extraction de données personnalisée, vous n’avez pas besoin de mettre en place votre propre infrastructure de scraping. Le moyen le plus rapide consiste à vous connecter directement à l’API Outscraper et à lui laisser le soin de gérer la collecte des données, la prévention des blocages et la mise à l’échelle.
La plupart des développeurs se retrouvent bloqués à cette étape, car ils essaient de gérer manuellement la rotation des proxys, les en-têtes et les limites de requêtes. Cela entraîne généralement des erreurs 403 et des scripts instables.
Avec Outscraper, vous pouvez ignorer toute cette étape et vous concentrer sur l'extraction de données structurées. Avant d'envoyer votre première requête, il est utile de bien comprendre un principe fondamental : le rôle d'une API.
Étape 1 : Comprendre le fonctionnement de l'API Outscraper
Une interface de programmation d'applications (API) permet à une application de demander des données à une autre application. En termes simples, votre script envoie une requête et l'API lui renvoie les résultats.
Avec Outscraper, cela signifie que vous pouvez extraire des données professionnelles à partir de sources telles que Google Maps sans avoir à créer votre propre outil d'extraction de données à partir de zéro.
Il vous suffit de comprendre ces 5 concepts simples avant de vous lancer :
Récupérer automatiquement les données
Extraire des données professionnelles depuis Google Maps
Où sont transmises les demandes
Ce que vous recherchez
Des données fiables et exploitables (noms, adresses, numéros de téléphone, sites web)
Étape 2 : Générer votre clé API
1. Connectez-vous sur votre compte Outscraper. S'inscrire si vous n'avez pas encore de compte.
2. Accédez à votre tableau de bord du profil.
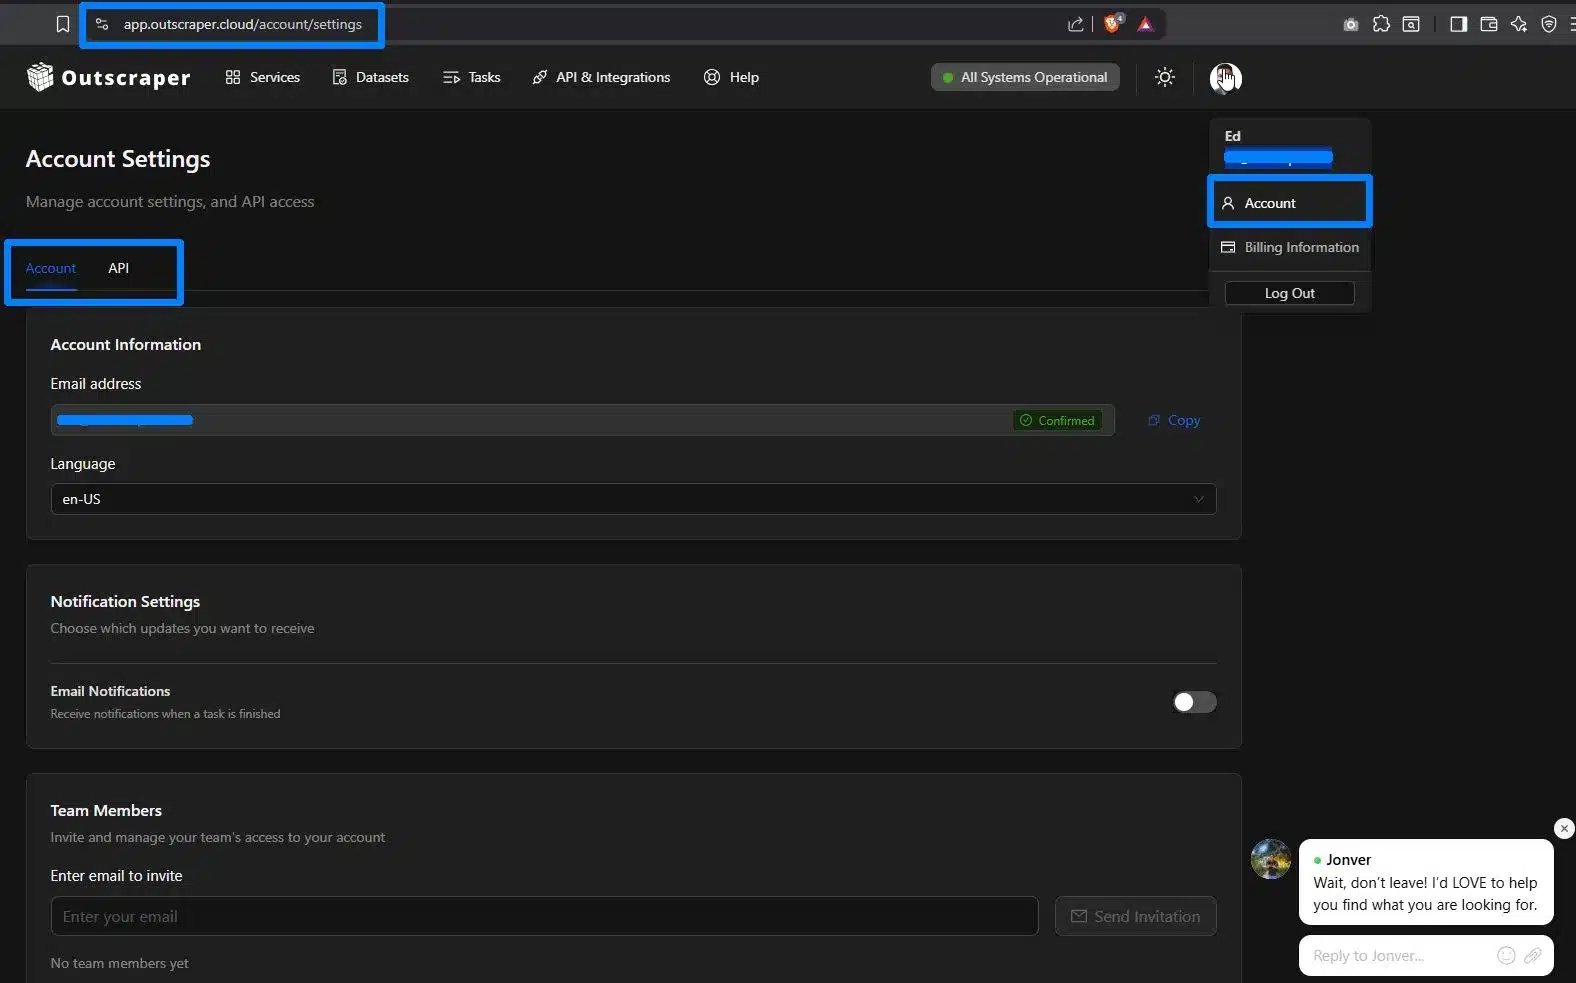
Que trouve-t-on dans le tableau de bord de votre compte Outscraper ?
3. Copiez votre Clé API
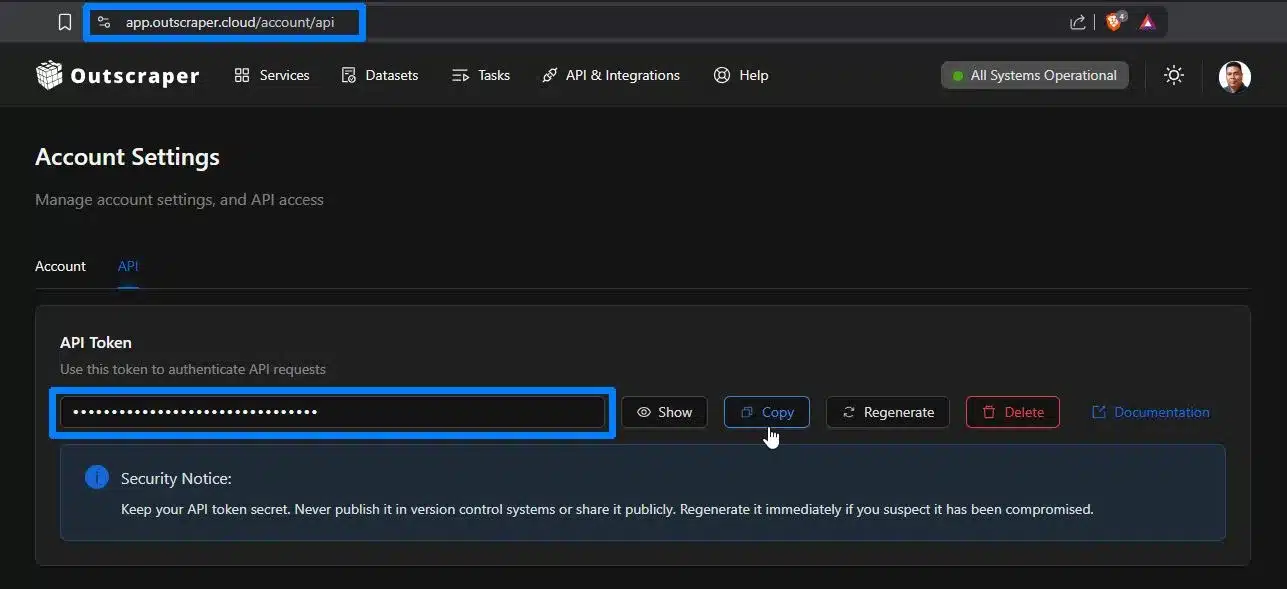
Copiez votre clé API exclusive pour lancer votre outil d'extraction de données personnalisée
Cette clé permet de gérer votre utilisation et votre facturation ; veillez donc à la conserver en lieu sûr.
Étape 3 : Configurer et exécuter votre première requête
Maintenant que vous maîtrisez les bases et que vous disposez de votre clé API, l'étape suivante consiste à envoyer votre première requête.
Pour cela, il vous suffit de trois choses :
- le point d'extrémité
- votre clé API
- une requête de recherche
Votre première requête (exemple simple)
Voici une configuration de base :
Point d'extrémité
https://api.outscraper.cloud/google-maps-search
Requête
restaurants, Manhattan, New York, États-Unis
Limite
3
Asynchrone
false
Ce que cela signifie
- Rechercher des restaurants à Manhattan
- afficher jusqu'à 3 résultats
- renvoyer les résultats immédiatement
Exécutez votre premier exemple en Python
Vous pouvez tester cela avec Python sur votre ordinateur ou à l'aide d'outils tels que Jupyter Notebook ou Google Colab.
-
Installer Python
Téléchargez et installez Python à partir de :
https://www.python.org/downloads/
Une fois l'installation terminée, ouvrez votre terminal ou votre invite de commande et exécutez la commande suivante :
python --version
Cela confirme que Python est correctement installé. -
Installez la bibliothèque « requests »
Exécutez cette commande :
pip install requests
Si vous préférez ne rien installer, vous pouvez également exécuter ce code dans Google Colab ou Jupyter Notebook.
Avant d'exécuter le script, assurez-vous que Python est bien installé.
Ouvrez l'invite de commande et exécutez la commande suivante :
python --version
Si un numéro de version s'affiche, vous pouvez continuer.

Vous avez vu comment ça fonctionne. Essayez maintenant avec votre propre requête et obtenez instantanément des données métier structurées.
Comment exécuter Python sur votre ordinateur local
Vous pouvez copier le script ci-dessous et l'exécuter à l'aide de l'Invite de commandes (Windows) ou du Terminal (Mac/Linux).
Remarque : Remplacez “ YOUR_API_KEY ” par votre clé API Outscraper personnelle.
					import requests

url = "https://api.outscraper.cloud/google-maps-search"

headers = {
    "X-API-KEY": "YOUR_API_KEY"
}

params = {
    "query": "restaurants, Manhattan, NY, USA",
    "limit": 3,
    "async": "false"
}

response = requests.get(url, headers=headers, params=params)

print("HTTP status:", response.status_code)

data = response.json()
print("API status:", data.get("status"))

places = data.get("data", [])

if places and len(places) > 0:
    for place in places[0]:
        print("Name:", place.get("name"))
        print("Address:", place.get("address"))
        print("Phone:", place.get("phone"))
        print("Website:", place.get("website"))
        print("-" * 30)
else:
    print("No places found.")
- Copiez le code (script) dans le Bloc-notes, puis enregistrez le fichier sous le nom outscraper.py
- Ouvrez la Invite de commande et assurez-vous que la bibliothèque « requests » a bien été installée
- Ouvrez le dossier dans lequel votre fichier est enregistré
- Ouvrez Python IDLE et Courir Module
Vous devriez voir s'afficher les résultats structurés sur votre terminal.
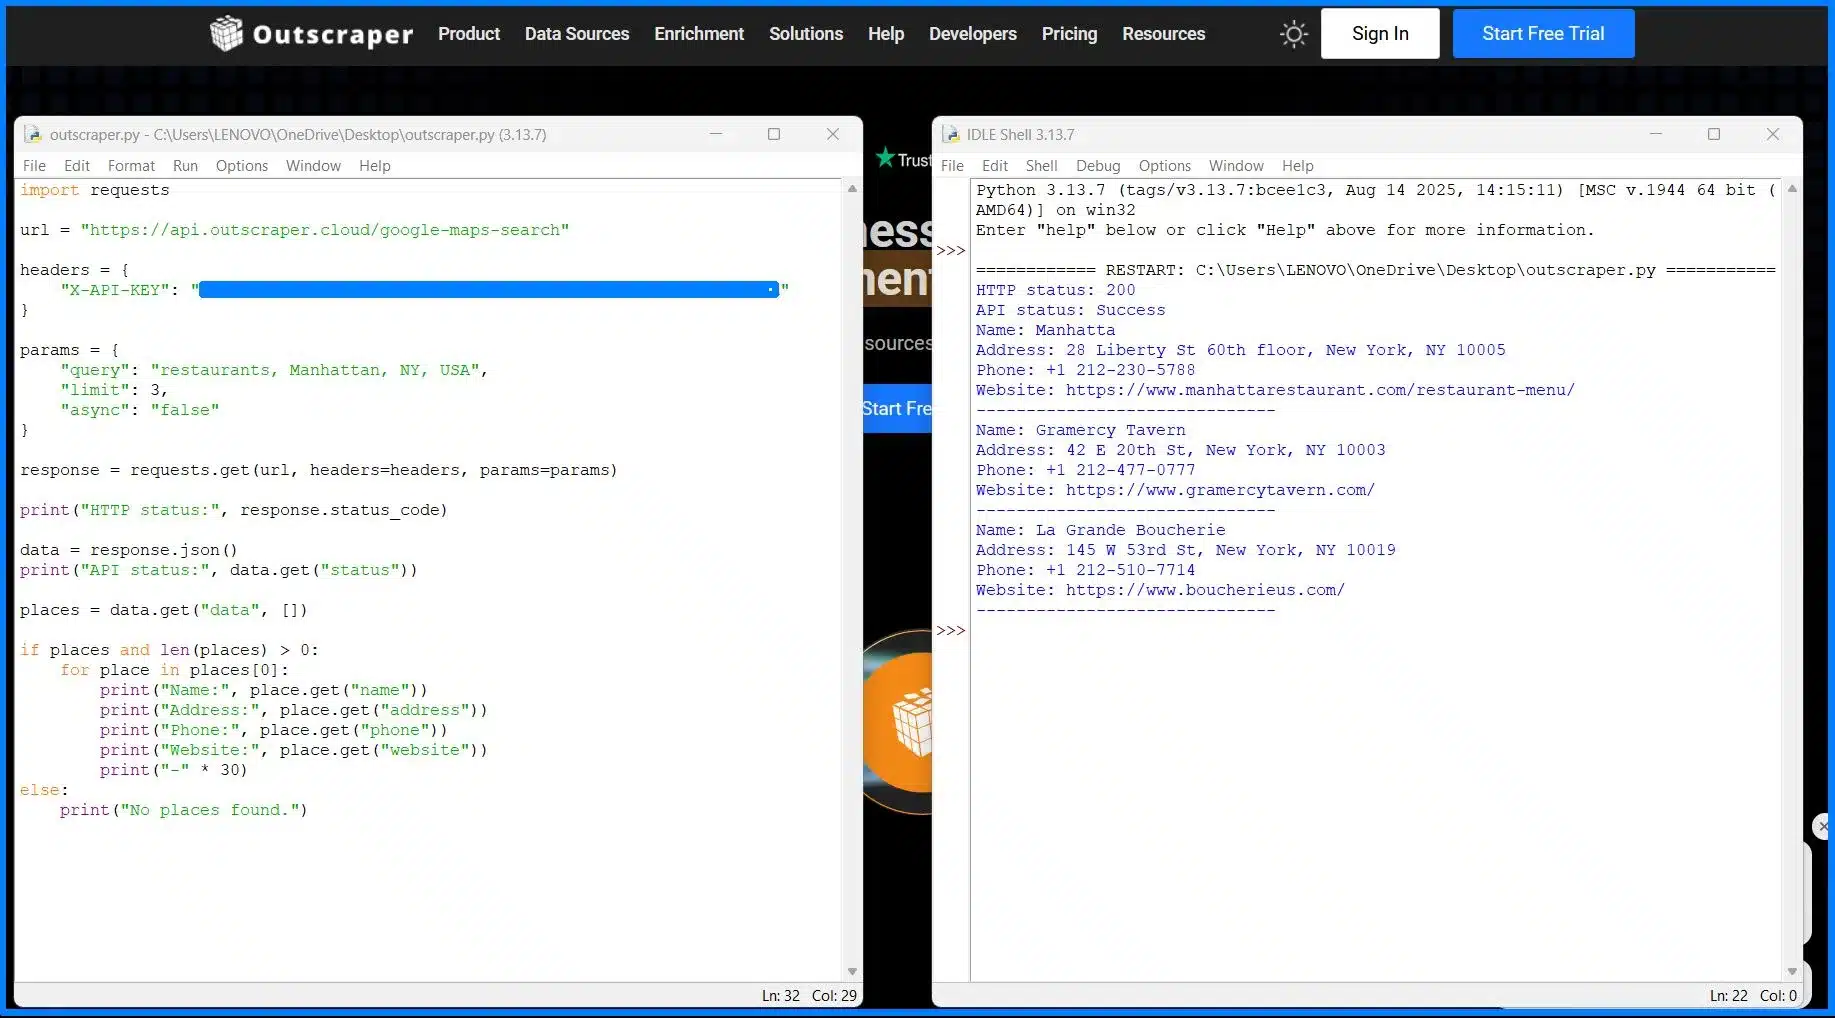
Si vous ne souhaitez pas télécharger Python IDLE et préférez simplement utiliser le terminal Windows pour extraire des données personnalisées, c'est également possible. Assurez-vous d'être dans le bon chemin d'accès.

Si rien ne se passe et que cela ne fonctionne pas, vérifiez d'abord ceci :
Si votre script s'exécute mais que rien ne s'affiche, ne vous inquiétez pas. C'est un problème courant chez les débutants.
-
Python attend une entrée
Si vous voyez..., appuyez sur Réessayez pour exécuter la commande. -
Vérifiez si la requête a abouti
Exécuter :print(response.status_code)
Tu devrais voir 200. -
Vérifier l'état de la réponse de l'API
Exécuter :print(response.json().get("status"))Tu devrais voir Succès. -
Le résultat est trop volumineux
print(response.json())renvoie beaucoup de données. Extrayez plutôt uniquement ce dont vous avez besoin. -
Accéder à la structure de données appropriée
Les résultats sont disponibles ici :data["data"][0]
-
Toujours rien ?
Essayez d'afficher le nombre de résultats :print(len(response.json().get("data", [])))
Conseil : Il est plus simple d'exécuter votre code sous forme de fichier (python script.py) au lieu de tout taper dans la console Python.
Et ensuite ?
- Votre requête est envoyée à l'API Outscraper
- L'API traite la requête.
- Vous avez reçu des résultats structurés (données commerciales).
Commencez modestement. Utilisez une seule requête, une limite basse et async=false. Une fois que cela fonctionne, vous pourrez augmenter l'échelle par la suite.
Étape 4 : Comprendre le résultat de votre première requête
Après votre première requête, Outscraper renvoie des données dans JSON format.
Voici une façon simple de comprendre la structure de la réponse.
Indique si la requête a abouti
Présente les résultats de l'entreprise
L'identifiant de la requête
Données structurées renvoyées par l'API
Une entreprise = une fiche. Chaque étiquette, comme
name ou phone = un champ.À ce stade, votre requête fonctionne et vous obtenez des résultats structurés. Si vous souhaitez intégrer ces résultats structurés dans une application, consultez Comment créer une application géolocalisée à l'aide des données de Google Maps et de Supabase à l'aide d'un workflow de conversion JSON vers une base de données.
La prochaine étape ne consiste pas à collecter davantage de données, mais à collecter les “ bonnes ” données. C'est là que la plupart des débutants gaspillent leurs crédits API.
Réglons ça.
Vous avez exécuté votre première requête en local. Vous pouvez désormais extraire des données métier réelles à grande échelle sans avoir à gérer de scripts ni d'infrastructure.
Comment définir votre logique d'extraction de données (sans gaspiller vos crédits API)
La plupart des débutants essaient de tout rassembler d'un seul coup. Utilisez plutôt cette méthode simple :
La méthode d'extraction de données Outscraper en trois étapes
Une méthode simple pour récupérer uniquement les données dont vous avez besoin sans gaspiller de crédits API.
Recherchez des entreprises à l'aide de critères spécifiques, de catégories et de lieux.
Ne conservez que les données pertinentes en affinant les paramètres et en sélectionnant les champs utiles.
Ajoutez des adresses e-mail, des profils sur les réseaux sociaux et d'autres informations pour transformer ces données en prospects.
Ne collectez pas toutes les données d'un seul coup. Commencez modestement, affinez vos données, puis enrichissez uniquement celles qui comptent.
L'utilisation de l'API est simple. C'est le choix des données à collecter qui fait toute la différence. Si vous ne le définissez pas dès le départ, vous risquez de
- Collecter des données non pertinentes
- Crédits API liés aux déchets
- Consacrez plus de temps à l'affiner vos résultats
Commencez par vous concentrer uniquement sur les données dont vous avez besoin.
1. Définissez vos critères de recherche
Les recherches trop générales donnent des résultats peu clairs. Au lieu de “ magasins à New York ”.”
Utilisez des requêtes plus précises :
- Filtrage par catégorie – “ dentistes à New York ”
- Ciblage géographique – Zones spécifiques ou coordonnées
- Filtrage des avis – Privilégiez les données de grande qualité ou récentes.
Des requêtes plus précises = des données plus fiables + moins de crédits gaspillés.
2. Ne collectez que les données dont vous aurez besoin
L'API renvoie de nombreux champs, mais vous n'en avez pas besoin de tous.
Par exemple :
- Génération de leads = nom, adresse, numéro de téléphone (NAP), site web
- Sensibilisation = e-mail et profils sur les réseaux sociaux
- Analyse = notes, avis.
Commencez modestement. N'ajoutez d'autres champs que lorsque cela s'avère nécessaire.
3. Enrichir les données dans un deuxième temps
Les résultats de base ne constituent qu'un point de départ. Vous pouvez passer à une deuxième étape pour enrichir vos données :
- E-mails = extrait du site web de l'entreprise
- Profils sur les réseaux sociaux = données provenant d'un réseau social ou d'un réseau professionnel.
Cela permet de transformer une simple liste en une base de données de prospects exploitable.
Pensez par étapes, plutôt que de formuler une seule grande demande
Au lieu de tout rassembler d'un seul coup :
- Trouver des entreprises
- Filtrer les résultats
- Enrichir les prospects sélectionnés
Cela permet de garantir l'efficacité de votre flux de travail et de réduire l'utilisation superflue de l'API.
Collecter trop de données trop tôt entraîne une augmentation des coûts et génère des ensembles de données non structurés. Commencez par une requête ciblée et de petite envergure, puis élargissez-la uniquement lorsque cela s'avère nécessaire.

Utilisez des requêtes structurées et des filtres pour extraire uniquement les données dont vous avez besoin et éviter de gaspiller vos crédits API.
Comment faire évoluer le scraping de données personnalisées grâce au traitement par lots et aux requêtes parallèles
L'exécution d'une seule requête convient pour les tests. Elle ne convient pas pour la mise à l'échelle.
À mesure que le volume de vos données augmente, les principaux défis à relever sont les suivants :
- Trop d'appels API
- Exécution lente des requêtes
Pour évoluer efficacement, vous devez réduire ces deux éléments.
Voici à quoi ressemble un workflow d'extraction de données évolutif :
Exécuter une requête → lent et limité pour les grands ensembles de données
Regrouper plusieurs requêtes en une seule → moins d'appels API
Utilisez les limites et les filtres → des résultats plus rapides et plus précis
Exécuter les requêtes en arrière-plan et traiter plusieurs requêtes simultanément
1. Envoyer plusieurs requêtes dans une seule demande
Outscraper vous permet d'envoyer plusieurs requêtes en une seule demande à l'aide de la requête paramètre.
Au lieu d'envoyer des requêtes séparées, vous pouvez les regrouper.
Selon le documentation, le traitement par lots permet de regrouper plusieurs requêtes dans une seule requête, ce qui réduit la charge réseau et améliore la vitesse.
2. Gérez la quantité de données que vous collectez
Utilisez le limite paramètre permettant de contrôler le nombre de résultats renvoyés par chaque requête.
- Limite inférieure – Réponse plus rapide
- Limite plus élevée – Plus de données, mais plus lent
Commencez modestement, puis augmentez progressivement uniquement si nécessaire.
3. Veiller à la clarté des résultats
Lorsque vous utilisez plusieurs requêtes, les résultats peuvent se chevaucher.
Utilisation :
- dropDuplicates – Supprimer les doublons
- totalLimit – Limite du nombre total de résultats
Cela permet de garantir la facilité d'utilisation de votre ensemble de données.
4. Utilisez les requêtes parallèles dans votre code
Le traitement par lots et l'asynchronisme sont gérés par l'API.
C'est votre code qui gère l'exécution parallèle.
Au lieu d'attendre qu'une requête soit terminée, vous pouvez lancer plusieurs requêtes simultanément afin d'accélérer votre flux de travail.
Utilisez le traitement par lots, les requêtes asynchrones et l'exécution parallèle pour traiter efficacement les grands ensembles de données.
Automatisation des flux de travail d'extraction de données grâce aux webhooks
Lorsque vous exécutez des requêtes volumineuses, votre script finira par dépasser le délai d'attente. Cela se produit généralement lorsque vous commencez à regrouper des requêtes ou à utiliser des enrichissements.
Au lieu d'attendre la réponse, utilisez « async=true » avec un webhook.
Configuration
- Ajoutez « async=true » à votre requête
- Ajouter une URL de webhook
- Envoyez la requête et laissez-la s'exécuter
Outscraper traitera la tâche en arrière-plan et enverra les résultats à votre serveur une fois celle-ci terminée.
Lorsque vous utilisez des webhooks, veillez à toujours tester votre point de terminaison à l'aide d'une petite requête avant d'exécuter des tâches volumineuses.
"async" : true,
"webhook" : "https://yourserver.com/webhook"
Cela permet d'éviter les échecs de livraison et facilite le débogage avant de faire évoluer votre flux de travail.
Erreur courante
Exécution d'un grand nombre de requêtes avec `async=false`.
Cela maintient la connexion ouverte et augmente le risque de délais d'attente ou d'échecs de requêtes.
Utilisez les webhooks pour automatiser votre pipeline de données et vérifier les signatures des requêtes afin de vous assurer que chaque réponse est authentique et sécurisée.
Comment transformer des données brutes en processus de génération de prospects et en workflows basés sur l'IA
La plupart des projets d'extraction de données échouent dès la première étape. Puisque vous collectez ces données, vous devriez les exploiter.
Si vos résultats restent au format JSON ou dans un fichier texte, ils ne généreront pas de prospects et ne permettront pas d'alimenter un système. La véritable valeur réside dans la transformation de ces données brutes en informations exploitables.
Préparez les données pour votre CRM
Les résultats bruts de l'API ne sont pas prêts à être utilisés à des fins commerciales. Avant de les intégrer dans un CRM, vous devez nettoyer et structurer les données.
Zoom sur :
- Cartographie sur le terrain – faire correspondre les champs de l'API aux colonnes du CRM (nom – nom de l'entreprise, téléphone – numéro de téléphone).
- Supprimer les enregistrements incomplets – Écartez les entreprises qui n'ont ni site web ni coordonnées.
- Dédupliquer les résultats – Évitez les doublons de prospects résultant de requêtes qui se recoupent.
Vérifier les coordonnées avant de prendre contact
Toutes les données extraites ne sont pas exploitables.
Avant de lancer des campagnes :
- Vérifier les adresses e-mail
- Supprimer les e-mails non valides ou présentant un risque
- Ne conserver que les contacts joignables
Cela permet d'éviter :
- Taux de rebond élevés
- Problèmes liés au spam
- Réputation de l'expéditeur compromise
Transformer les données en liste de prospects
À ce stade, votre objectif est simple : il suffit de transformer des données structurées en une liste exploitable.
Une liste de prospects de base comprend :
- Raison sociale
- Site Internet
- Numéro de téléphone
C'est ce qu'utilisent votre équipe commerciale ou vos outils de prospection.
Utiliser les données pour l'automatisation basée sur l'IA
Une fois vos données nettoyées, vous pouvez les exploiter au-delà de la génération de prospects.
Exemples :
- Enrichissement par IA – Classification des entreprises par secteur d'activité ou par intention.
- Enrichissement des prospects – Donner la priorité aux prospects à forte valeur ajoutée.
- Communication automatisée – déclencher des flux de travail par e-mail ou via le CRM.
Un même ensemble de données peut alimenter les deux :
- Pipelines de vente
- Workflows basés sur l'IA
La plupart des problèmes ne surviennent pas lors de l'extraction des données, mais lorsque vous essayez d'utiliser ces données dans votre CRM ou votre outil de prospection.
Commencez par un petit ensemble de données et testez l'ensemble de votre pipeline (extraction → CRM → prospection) avant de passer à une plus grande échelle. La plupart des problèmes surviennent après l'intégration, et non pendant l'extraction.
Du scénario à la production
À ce stade, vous disposez déjà de tout ce dont vous avez besoin pour mettre en place un workflow prêt à être utilisé en production :
- Séries structurées
- Extraction contrôlée des données
- Demandes évolutives
- Envoi automatisé via des webhooks
La différence entre un script de test et un système de production réside dans la cohérence. Une fois que votre pipeline est stable, vous pouvez l'exécuter en continu et l'intégrer à vos outils existants.
La plupart des équipes ne rencontrent pas de difficultés lors de l'extraction, mais la plupart d'entre elles ne parviennent pas à en faire un système reproductible.
Évitez de créer des scrapers à partir de zéro. Utilisez l'API Outscraper pour extraire, mettre à l'échelle et automatiser votre pipeline de données.
Foire aux questions
L'extraction personnalisée de données via une API consiste à envoyer des requêtes structurées à un service tel que Outscraper afin de récupérer des données professionnelles (telles que des noms, des adresses et des sites web) sans avoir à développer son propre outil de scraping.
Au lieu de gérer des proxys ou des CAPTCHA, l'API renvoie des résultats épurés et structurés que vous pouvez utiliser immédiatement.
Des connaissances de base en Python ou sur les API sont un atout, mais vous n'avez pas besoin de compétences avancées en développement.
Ce guide vous explique comment effectuer votre première requête à l'aide d'un script simple. Vous pouvez également utiliser des outils tels que Google Colab pour effectuer des tests sans avoir à installer quoi que ce soit localement.
C'est l'un des problèmes les plus courants. Cela se produit généralement lorsque :
- la requête est trop générale ou trop vague
- la requête ne s'est pas exécutée correctement
- les résultats ne sont pas correctement récupérés dans la réponse JSON
Commencez par une requête simple et une limite modeste, puis élargissez le champ d'application une fois que cela fonctionne.
Pour évoluer efficacement :
- envoyer plusieurs requêtes en une seule demande
- contrôler les résultats à l'aide du paramètre de limite
- utilisation async=true pour les travaux de plus grande envergure
- exécuter des requêtes en parallèle dans votre code
La mise à l'échelle consiste à réduire à la fois le nombre d'appels d'API et le temps d'attente.
Une fois les données extraites :
- associer les champs à votre CRM (nom, numéro de téléphone, site web)
- supprimer les enregistrements incomplets ou en double
- vérifier la validité des adresses e-mail avant de les contacter
La plupart des problèmes surviennent après l'extraction, lors de la préparation des données en vue de leur utilisation effective.