El inicio de Internet es el inicio del web scraping
A medida que la era digital se fue desarrollando con la llegada de Internet, también se produjo el inicio de extracción de datos de la web. Los inicios de Internet se caracterizaron por una inmensa cantidad de información, a la espera de ser explorada y aprovechada. Las empresas tecnológicas buscaban formas de recopilar, clasificar y utilizar la creciente cantidad de datos disponibles en línea. Fue en esa época cuando las empresas de motores de búsqueda más famosas lograron destacar por encima de todas las demás en la recopilación y clasificación de información.
Protectores de datos frente a extractores de datos
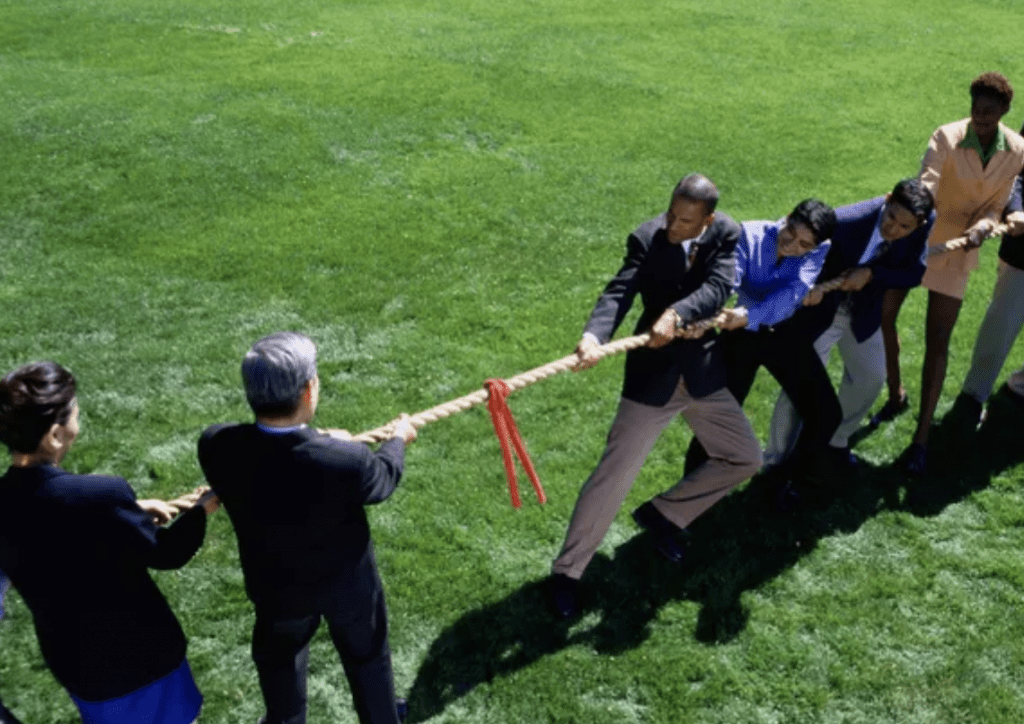
En el vasto panorama digital, se libra una batalla silenciosa entre los defensores de los datos y quienes los extraen. Por un lado, los defensores de los datos —a menudo ingenieros y profesionales del ámbito jurídico— abogan por la protección de la información personal y privada. En el extremo opuesto, los extractores de datos —entre los que se incluyen los «web scrapers», los «data miners» y algunos investigadores de mercado— innovan constantemente para acceder a los datos de la web y aprovecharlos. Su objetivo suele ser recabar información, impulsar estrategias empresariales o, simplemente, recopilar datos para diversos fines.
Este tira y afloja entre las dos facciones pone de relieve un debate más amplio sobre el equilibrio entre el libre acceso a la información y la protección de la privacidad y la propiedad intelectual en la era digital.
Avance en IA
 Como IA Los algoritmos se han vuelto más sofisticados, al igual que las capacidades de los programas de extracción de datos web. Ya no es necesario utilizar Selectores CSS o XPathes para indicar de dónde se deben extraer los datos. La IA es capaz de comprender la estructura de cualquier página HTML y extraer los datos necesarios según la estructura que solicites (nombre, precio, descripción, etc.). Un buen ejemplo de ello es el de Outscraper: Raspador web universal basado en inteligencia artificial que se utiliza para extraer datos de cualquier página web sin necesidad de programar ni seleccionar el origen de los campos.
Por lo tanto, simplemente Si bien la IA se utilizó para proteger los contenidos frente a los bots de scraping, las empresas de scraping también la aprovecharon para facilitar la extracción de datos.
El futuro del web scraping
 Al contemplar el horizonte de la era digital, el futuro del «web scraping» promete ser dinámico y polifacético. Con los rápidos avances en inteligencia artificial y aprendizaje automático, las herramientas de «web scraping» están llamadas a volverse más inteligentes, capaces de comprender el contexto, adaptarse a los cambios de los sitios web en tiempo real e incluso predecir tendencias en los datos. Al mismo tiempo, a medida que se intensifican las preocupaciones sobre la privacidad y la seguridad de los datos, cabe prever que los sitios web implementen medidas de protección más sólidas. Esto dará lugar a un complejo juego del gato y el ratón entre los defensores de los datos y quienes los extraen, lo que ampliará los límites tanto de las tecnologías de defensa como de extracción.
Además, con el auge de la web descentralizada y las tecnologías de cadena de bloques, surgirán nuevos retos y oportunidades para el web scraping. En esencia, el futuro del web scraping se caracterizará por una combinación de innovación tecnológica, consideraciones éticas y un panorama jurídico en constante evolución.