目录
了解"拥有网站的企业"为何重要
如何仅抓取拥有网站的企业?请筛选您的数据抓取工具,使其仅返回拥有有效网站网址的企业信息。根据2024年美国小微企业数字化转型调查显示, 70%的受访者拥有网站 那一年在美国。
拥有网站的企业对潜在客户的开发至关重要,而这仅仅是原因之一。当一家企业拥有自己的网站时,您就能立即更清晰地了解其细分领域、规模、可信度以及数字化准备程度。
拥有网站的公司更容易评估,而且你可以更快地核实其联系方式。
针对拥有网站的企业进行营销的主要优势
- 质量更高的潜在客户,其在线资料易于查阅,且信息可核实。
- 根据细分市场、行业或在线内容类型进行更细致的细分。
- 更便于评估数字化准备情况,包括搜索引擎优化(SEO)表现、提供的服务以及网站结构。
什么是网页抓取?它是如何工作的?
网页抓取是指从网站自动收集和提取数据的过程。它使您能够收集结构化的商业信息,例如公司名称、网站域名、联系方式和行业类别。像Outscraper这样的工具让这一过程变得简单,能够快速、准确地提取公开数据。
只要专注于公开可获取的信息,网络爬取就是合法的。其用途通常限于内部使用,例如建立潜在客户名单、进行市场调研或分析网络趋势。请避免爬取敏感、私密或受限的数据,以确保符合道德和法律规范。
通过有效运用网页抓取技术,您无需手动调研即可构建高质量的商业数据集,从而节省时间并提升潜在客户定位的精准度。
如何识别仅拥有网站的企业
建立高质量潜在客户名单的第一步,是确定哪些企业确实拥有网站。 重点在于筛选数据源 所以 仅包含有效 URL 的条目 已包含.
筛选方法:
- 抓取企业名录,并仅保留包含网站网址的条目
- 排除没有网站的企业:
- 在谷歌地图中,查找“网站”字段为空的商家信息 为空或缺失. 这些条目通常指仅依靠线下运营的企业。
- 关于 行业特定目录,过滤掉标记为“无网站”的条目,或者 条目 那个 仅列出 电话号码或实际地址。
- 通过保留这些排除项,可确保您的列表中仅包含可验证的网络线索。
常用的入门资料:
- 行业专用名录 – 筛选包含网站信息的条目。
- 谷歌地图 – 手动复制并粘贴拥有网站的企业信息,或者您可以使用 Outscraper 的谷歌地图数据抓取工具,仅提取拥有网站的企业信息。
交叉核对
整合多个数据集以确保准确性。利用公开的企业注册信息或API,并核实每家企业的网络存在情况。此步骤旨在确认网站处于活跃状态且联系方式有效。
针对拥有网站的企业进行数据抓取的关键策略
建立高质量潜在客户名单的第一步,是确定哪些企业确实拥有网站。 重点在于筛选数据源 所以 仅包含有效 URL 的条目 已包含.
使用专用工具和 API
- Outscraper的 谷歌地图数据抓取工具
- 提取商家名称、类别、营业状态、评分和评论。
- 通过“拥有网站”字段筛选企业,以实现精准定位。
- Google 地方信息 API
- 查找企业,并将其与许可证数据库或网站网址进行比对。
- 电子邮件和联系方式抓取工具
- 诸如 Outscraper 的“电子邮件与联系人抓取工具”、Hunter.io 和 Snov.io 等工具,可提取与特定域名相关的电子邮件地址和社交媒体个人资料。
- AI 爬虫
- 诸如 Outscraper 的 AI 驱动提取工具、Browse AI 和 Clay 等平台,利用人工智能自动检测并提取结构化网站数据。
锁定高价值数据源
- 在线商业名录
- 筛选包含“网站”字段的列表。
- 示例:Clutch、Crunchbase、Targetron 以及当地商会的名录
- 搜索引擎
- 使用高级谷歌搜索运算符,例如“数字营销机构” + “网站” + “洛杉矶”,以查找包含URL的搜索结果
- 使用 Outscraper 或浏览器扩展程序抓取生成的页面。
- 企业注册数据库
- 将政府发布的商业名录与网络爬虫技术相结合,以确认每家公司的在线存在情况。
应用有效的网页抓取技术
- 无代码工具
- 类似 Outscraper、Octoparse 和 ParseHub 的拖放式平台 允许 供非开发人员收集 基于网站的 数据 很快.
- 编程框架
- 诸如 BeautifulSoup 或 Scrapy 之类的 Python 库支持高级自定义爬取工作流。
- 动态内容处理
- Selenium 或 Puppeteer 可处理通过 JavaScript 加载内容的网站。
- 输出
- 将数据导出为 CSV 或 JSON 格式 格式,然后导入CRM或数据增强平台来管理潜在客户。
最佳实践与伦理考量
在抓取拥有网站的企业数据时,遵循道德和技术方面的最佳实践有助于您确保合规并保持数据质量。负责任的抓取既能保护您的声誉,也能保障工具的性能。
检查权限和限制
在运行任何爬虫程序之前,请务必确认您的操作符合该网站的规则和数据隐私标准。
- 在进行数据抓取之前,请先检查 robots.txt 文件。
- 请遵守各网站的服务条款。
- 请勿抓取个人数据或受登录保护的页面。
负责任地管理服务器负载
大规模运行爬虫时,需要谨慎操作,以免给目标网站造成过载。
- 限速请求模拟了人类的浏览行为。
- 请在非高峰时段安排数据抓取。
- 使用 Outscraper 内置的速率限制和代理轮换功能。
使用代理和防封措施
代理和反封禁技术有助于在从多个来源收集数据时保持数据的连续性和准确性。
- 轮换IP地址以避免被检测到。
- 进行大规模数据抓取时,请使用可靠的代理服务。
- 为确保透明度,请记录请求的时间和状态。
分步指南:仅使用 Outscraper 爬取拥有网站的企业
本指南将指导您筛选出仅拥有经过验证网站的企业,以便您构建高质量且可直接用于外联的潜在客户名单。
先决条件
步骤 1:确定目标
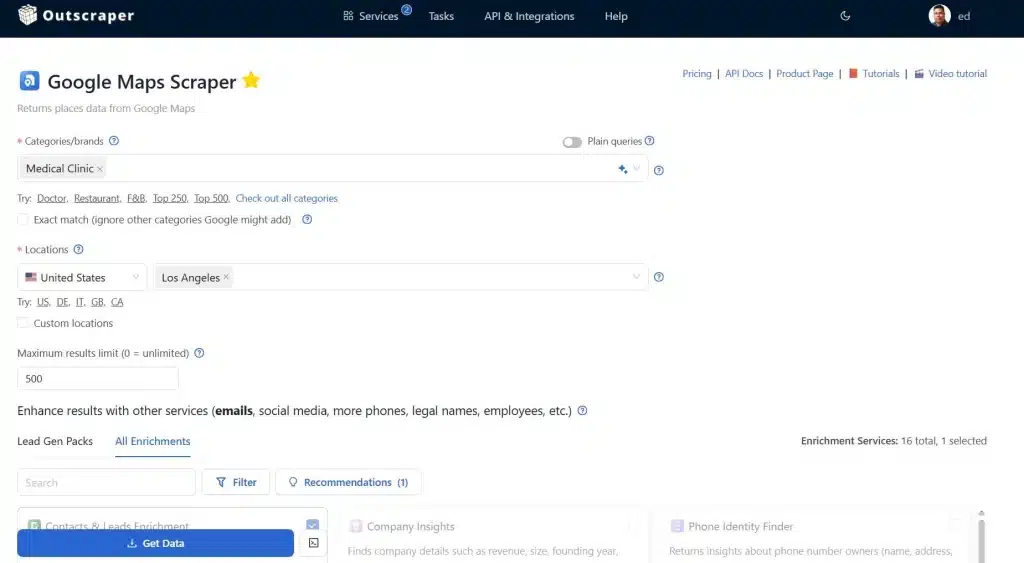
- 打开您的 Outscraper 账户, 请继续 服务 然后选择 谷歌地图数据抓取工具.
- 请输入目标关键词或类别,然后输入具体位置。 (例如,“洛杉矶的诊所”)。
- 请输入最大结果数(例如 500),但如果您希望获取无限数量的结果,请输入“0”或留空。
步骤 2:使用数据增强工具优化结果
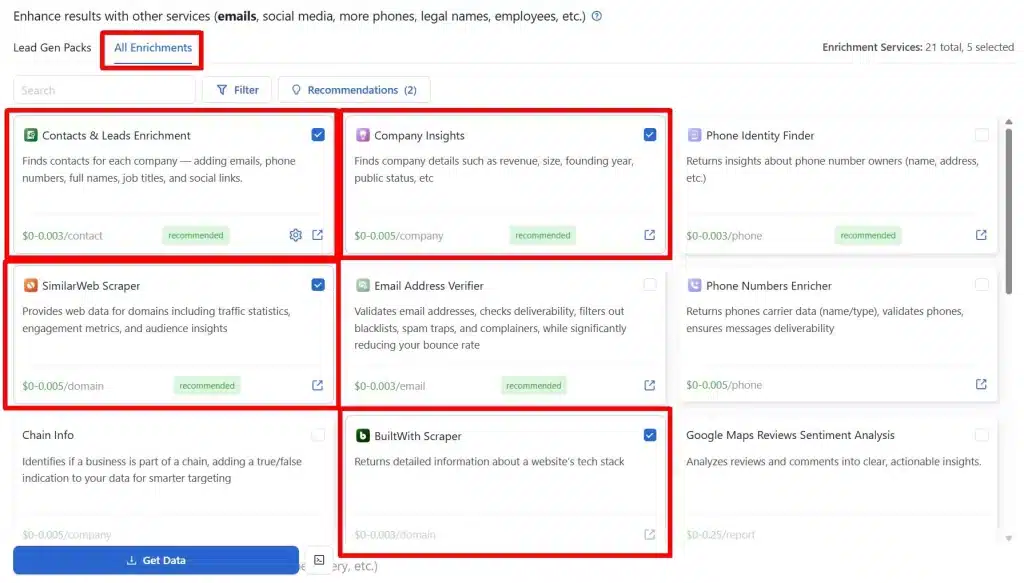
- 利用 Outscraper 的数据增强功能来提升分析效果。在本示例中,我们将使用“所有数据增强”选项卡,并选择 联系人及潜在客户信息补充, 公司洞察, SimilarWeb 数据抓取工具, BuiltWith 抓取工具, 和 Trustpilot Scraper.
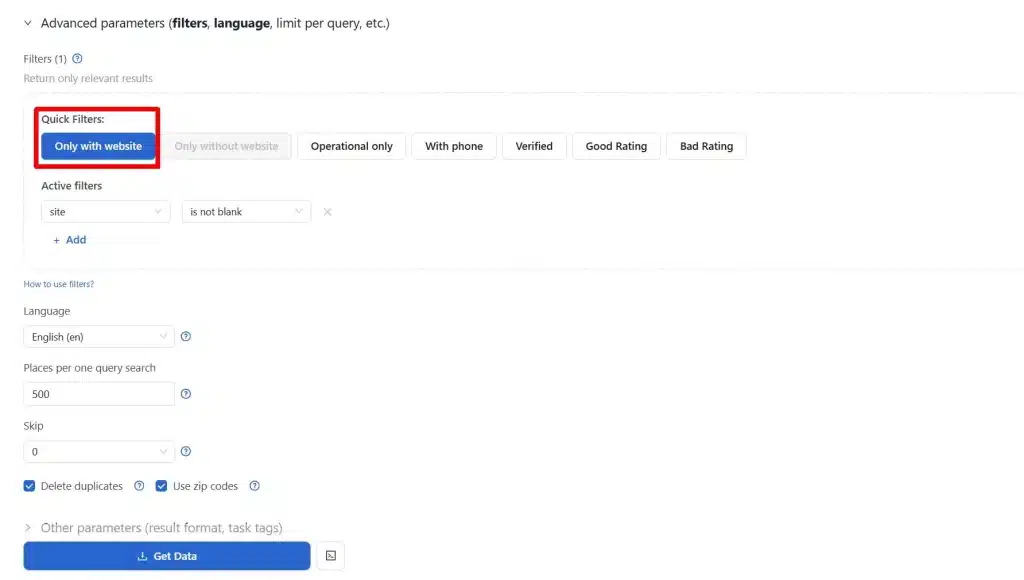
- 转到“高级筛选”并选择“快速筛选” “仅限网站。”
- 选择语言(英语),并设置每次查询的搜索结果数量(例如,500)。
- 勾选“删除重复项”和“使用邮政编码及其他参数”,系统将生成结果(例如 CSV 格式)并添加任务标签。
步骤 3:运行任务并下载数据
- 启动爬虫,并在Outscraper应用的“任务”部分中监控进度。
第 4 步:验证数据并导入到您的 CRM 中
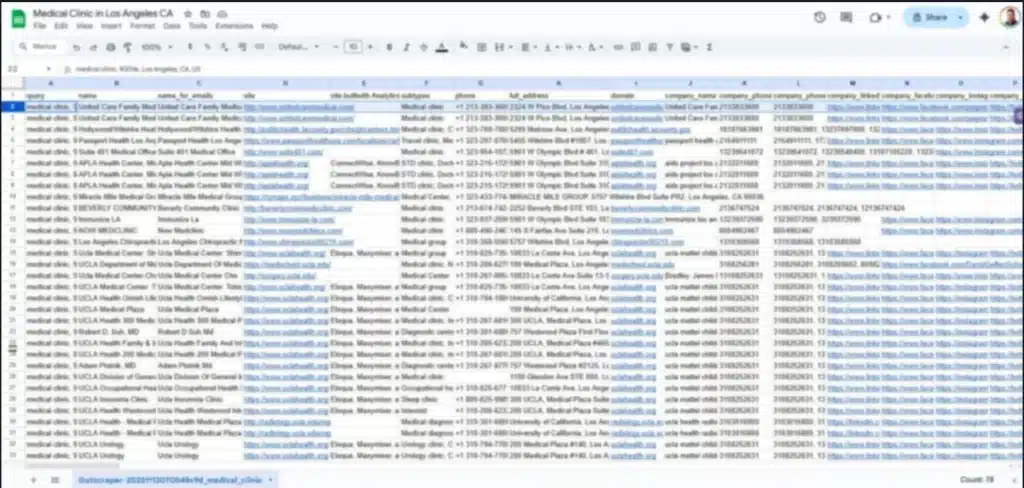
- 抓取完成后,检查数据集中是否存在已停用或无法访问的网站。
- 将增强后的数据集导出到 Google 表格、HubSpot、Pipedrive、GoHighLevel 及其他 CRM 系统或您首选的平台。
- 按地区、行业或公司规模进行分类,以便有针对性地开展推广活动。
下一步
- 根据优先级对潜在客户进行分类(例如,域名权威度较高或大型企业)。
- 启动个性化推广活动或研究竞争对手。
- 保持规律的日程安排,以确保潜在客户列表始终保持最新。您还可以使用 Outscraper 的“计划任务”功能。除了安排任务外,您还可以将其复制为 API 请求,甚至可以将同一模板用于您想要抓取的其他类别或行业。
总结
将目标锁定在拥有网站的企业上,可以让你锁定那些身份可验证、更容易联系且更可能做出回应的潜在客户。通过结合 Outscraper的 谷歌地图数据抓取工具 具有诸如……之类的增强功能 联系人及潜在客户, 公司洞察, SimilarWeb, BuiltWith,以及 Trustpilot,您可以将原始商业名单转化为高价值的数据集。
对这些数据进行筛选、验证并导入到您的 CRM 系统中,可为外联、竞争对手研究和本地 SEO 活动建立一个有序的工作流程。遵循合乎道德的爬取规范,既能确保数据的可靠性和合规性,又能最大限度地减少干扰。
坚持执行这些步骤,将为您带来源源不断的合格潜在客户,从而帮助您的营销和销售工作变得更加精准和高效。
常见问题
最常见的问题和答案
锁定拥有网站的企业,可确保您的潜在客户信息真实可靠、更易于联系且活跃于数字渠道。网站能提供有关公司规模、细分领域、信誉度及线上影响力的信息,从而使您的推广活动更加精准有效。.
在 Outscraper 或者在导出数据之前,请确认“目录”和“谷歌地图”中的网站字段未为空。.
是的。Outscraper 提供了多种增强工具,包括 联系人与潜在客户、公司洞察、SimilarWeb、BuiltWith,以及 Trustpilot, ,以添加经过验证的联系人、公司详情、流量指标、技术栈和评价信息。.
将增强后的数据集以 CSV 或 JSON 格式导出,并上传至 HubSpot、Pipedrive 或 GoHighLevel 等平台。. Outscraper的API 或者 集成工具 让这一工作流程变得无缝衔接。.
轮换 IP 地址、使用代理、设置速率限制,并在非高峰时段安排抓取任务。保留日志以监控进度并排查失败的请求。



